26种设计模式 2. 创建型模式 接下来我们来看看设计原则的最佳实践
设计模式的类型
根据设计模式的参考书 Design Patterns - Elements of Reusable Object-Oriented Software(中文译名:设计模式 - 可复用的面向对象软件元素) 中所提到的,总共有 23 种设计模式。这些模式可以分为三大类:创建型模式(Creational Patterns)、结构型模式(Structural Patterns)、行为型模式(Behavioral Patterns)。当然,我们还会讨论另一类设计模式:J2EE 设计模式。
序号
模式 & 描述
包括
1
创建型模式 这些设计模式提供了一种在创建对象的同时隐藏创建逻辑的方式,而不是使用 new 运算符直接实例化对象。这使得程序在判断针对某个给定实例需要创建哪些对象时更加灵活。工厂模式(Factory Pattern)抽象工厂模式(Abstract Factory Pattern)单例模式(Singleton Pattern)建造者模式(Builder Pattern)原型模式(Prototype Pattern)
2
结构型模式 这些设计模式关注类和对象的组合。继承的概念被用来组合接口和定义组合对象获得新功能的方式。适配器模式(Adapter Pattern)桥接模式(Bridge Pattern)过滤器模式(Filter、Criteria Pattern)组合模式(Composite Pattern)装饰器模式(Decorator Pattern)外观模式(Facade Pattern)享元模式(Flyweight Pattern)代理模式(Proxy Pattern)
3
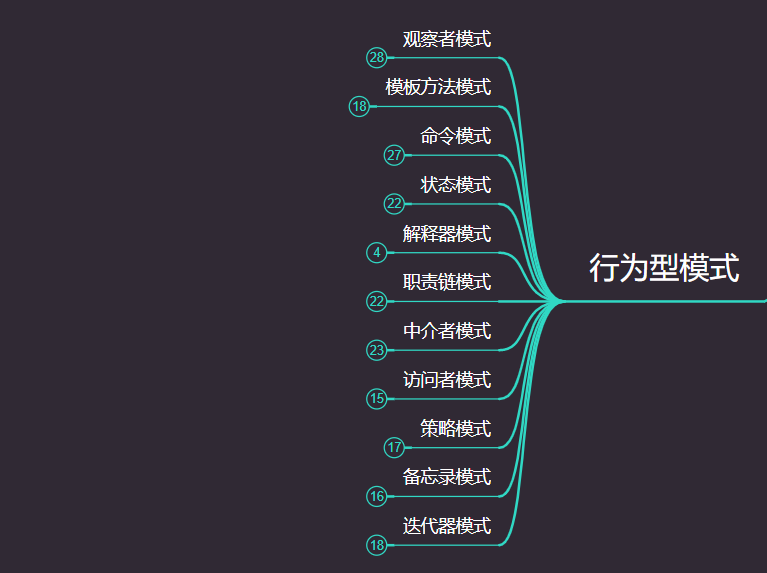
行为型模式 这些设计模式特别关注对象之间的通信。责任链模式(Chain of Responsibility Pattern)命令模式(Command Pattern)解释器模式(Interpreter Pattern)迭代器模式(Iterator Pattern)中介者模式(Mediator Pattern)备忘录模式(Memento Pattern)观察者模式(Observer Pattern)状态模式(State Pattern)空对象模式(Null Object Pattern)策略模式(Strategy Pattern)模板模式(Template Pattern)访问者模式(Visitor Pattern)
4
J2EE 模式 这些设计模式特别关注表示层。这些模式是由 Sun Java Center 鉴定的。MVC 模式(MVC Pattern)业务代表模式(Business Delegate Pattern)组合实体模式(Composite Entity Pattern)数据访问对象模式(Data Access Object Pattern)前端控制器模式(Front Controller Pattern)拦截过滤器模式(Intercepting Filter Pattern)服务定位器模式(Service Locator Pattern)传输对象模式(Transfer Object Pattern)
2.1 工厂设计模式
工厂设计模式属于创建型模式 ,创建型模式的核心是隐藏细节,并创建实例,我们看工厂模式中的模式都是能够向外提供类的实例对象的
其中工厂设计模式分为三种:
在讲工厂设计模式之前,我们先来看看一个合理的运用设计模式设计出来的软件架构应该是怎么样的,这也是面向接口编程的设计方式
我们在面向接口编程中,模块和模块之间不能直接调用具体实现类,而是调用模块提供的接口,我们仔细想想在平时的编码中,有直接service层调用dao层的xxxDaoImpl的吗?显然没有,如果直接调用了也差不多该换下一份工作了,一般都是注入接口,让容器注入一个实现类
工厂模式的核心也是隐藏内部实现,对外暴露接口实现具体逻辑,我们来看看工厂模式中的几个重要概念:
产品:就是具体的产品,例如下面代码中的Hamburger
抽象产品:产品的抽象,例如Food
产品簇:这个概念在抽象工厂中在场景中再解释
产品等级:同上
我们来看一个简单的例子,来理解上面的几个概念,另外在学习设计模式的时候一定要清醒的认识到,为什么要有设计模式,为了应对变化,以不变应万变,这里还有两个概念,就是我们习惯于把功能提供者称为作者,把我们这些API调用工厂师叫做用户
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 interface Food { void eat () ; } class Hamburger implements Food { @Override public void eat () { System.out.println("吃汉堡包..." ); } } public class AppTest { public static void main (String[] args) { Food food = new hamburger (); food.eat(); } }
本来没有什么问题的,但是我一开始就提过,我们要应对这个不断变化的世界,现在变化来了,由于某些原因,作者把原来提供的类名改了,例如把hamburger改为hamburger2,这时候怎么办,是不是我们也要跟着改!!!
跟我说,什么叫耦合?一个改了另一个也要改,这就叫耦合;什么叫解耦?一个改了另一个不需要改,这就叫解耦!
有人说怎么可能,作者好好地没事会去该类名,闲得慌??你别说,笔者在项目中还经常遇到一些作者瞎改类名又不提示用户的,hutool包是我们常用的工具包,但是有一些类名在包升级的时候直接修改,而且完全没有做兼容处理,有一次团队项目打包失败了,最后定位问题发现,这个作者之前类名单词拼写错误了,然后升级版本的时候直接改了类名,导致我们升级版本导入一个不存在的类,导致项目出现问题,记得当时我们都说这个作者是个坑爹玩意,一看就是设计模式没学好
读者可以看看这个作者违反了什么原则?违反了开闭原则,正确的做法应该是给错误的类加过时的标记,重新写一个
我们来总结一下:
这样的设计非常的脆弱,为什么呢?只要作者修改了具体产品的类名,那么客户端就要一起修改,这样的代码就是耦合的
我们希望的效果是,无论服务端客户端如何修改,客户端代码都应该无感知,而不用去进行修改
那么我们如何进行改进呢?针对服务端代码一旦修改,客户端代码也要修改的问题,我们直接使用简单工厂设计模式
2.1.1 简单工厂模式
设计模式的类型
这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。它的本质就是通过传入不同的参数达到多态的目的
优点:
一个调用者想创建一个对象,只要知道其名称就可以了。
扩展性高,如果想增加一个产品,只要扩展一个工厂类就可以。
屏蔽产品的具体实现,调用者只关心产品的接口。
缺点:
用户需要去记忆具体产品和常量之间的映射关系,例如:FoodNumberEnum.HAMBURGER -> hamburger
如果具体产品非常多,在简单工厂里面映射关系会非常多
最重要的是,当用户需要拓展新产品时,就需要在作者的工厂源码中添加映射关系,违反开闭原则
首先我们要弄清楚一个问题,简单工厂设计模式是谁进行具体编码的?是我们(用户)去写吗?还是作者去写,其实是应该由作者去写
假设我们现在是这个作者,我们发现之前的设计确实不太合理,现在要进行优化,我们就可以这样写:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 interface Food { void eat () ; } class hamburger implements Food { @Override public void eat () { System.out.println("吃汉堡包..." ); } } class hamburger2 implements Food { @Override public void eat () { System.out.println("这是作者修改后的汉堡包..." ); } } class FoodFactory { public enum FoodNumberEnum { HAMBURGER(1001 , "汉堡包" ), HAMBURGER2(1002 , "修改后的汉堡包" ), ; private final Integer foodNumber; private final String describe; FoodNumberEnum(Integer foodNumber, String describe) { this .foodNumber = foodNumber; this .describe = describe; } public Integer getFoodNumber () { return foodNumber; } public String getDescribe () { return describe; } public static FoodNumberEnum getByType (int type) { for (FoodNumberEnum constants : values()) { if (constants.getFoodNumber() == type) { return constants; } } return null ; } } public static Food getFood (FoodNumberEnum foodNumberEnum) { Food food = null ; switch (FoodNumberEnum.getByType(foodNumberEnum.getFoodNumber())) { case HAMBURGER : food = new hamburger (); break ; case HAMBURGER2 : food = new hamburger2 (); break ; default : break ; } return food; } } public class AppTest { public static void main (String[] args) { Food food = FoodFactory.getFood(FoodFactory.FoodNumberEnum.HAMBURGER); food.eat(); } }
我们来看这样做的好处是什么:
之前是我们直接创建对象,依赖于作者的代码;现在是依赖于工厂,由工厂创建对象
如果作者对原来的实现类做出了修改,也必须修改工厂里面的代码,注意,这里是作者进行修改,而不是用户修改,这样就做到了依赖倒置,完成了解耦,这样用户代码不用做出任何修改
之前由于作者修改代码导致用户也要修改其实还违背了迪米特法则,因为我们被迫去了解了作者的实现,其实我们是不关心如何实现的,我们只需要一个接口实现我们想要的功能即可!!!
可能有又有杠精要问了,要是作者把枚举也改了怎么办?这不是还是要改客户端代吗,我我我???直接好家伙
请杠精看看Spring中的工厂模式是怎么做的,后面笔者也会分析源码,我们在Spring中,不是一直写这样的代码吗???
1
2
3
4
5
@Component public class XXX { @Autowired(required = false) private XXXBean xxxBean; }
请问,这样做不管实现类怎么修改,只要注入IOC容器,我难道不能直接注入接口中吗?这就叫解耦,面向接口编程
我们总结一下简单工厂的优点:
把具体产品的类名,从客户端代码中解构出来了,服务端如果修改了服务端类名,客户端也不知道
这便符合了面向接口编程的思想,这里注意,这里的接口并不特指interface,而是指下层给上层暴露的东西,可以是一个方法、一个接口、甚至是一个工厂,并且这些接口必须稳定,绝对不能改变
那么缺点呢? 好像也没啥缺点感觉,又解耦了,又隐藏细节了,这里又不得不提一直提到的变字了,学习设计模式,我们要将变字贯穿整个学习过程
客户端不得不死记硬背那些枚举类和产品之间的映射关系,比如FoodNumberEnum.HAMBURGER -> hamburger
如果有成千上万个产品,那么简单工厂就会变得十分的臃肿,造成映射关系爆炸
最重要的是如果变化来了,如果客户端需要拓展产品,首先我们不能改源代码(违反开闭原则),我们只能搞一个实现类实现自己的逻辑,但是工厂中又没有映射关系让我们创建这个实例,我们又得去修改工厂的源码,又违背了开闭原则,同时最重要的是,你这是去改别人提供的jar包呀我的天,你觉得你能看到被人的源代码吗?你能修改吗?????显然不能,那怎么解决呢?这就引出第二个工厂模式:工厂方法设计模式
有的同学可能会觉得自己拓展的类,自己new一个不就好了,还改什么源代码?讲的有道理,但是如果你也是作者呢?你写的拓展是要给别人使用的呢?难道让读者去new一个你的实现类,这不违背迪米特法则了吗?用户只想要一个具体的实现,你现在要让用户去找你的实现类,这合理吗?这不合理,我们直接看工厂方法设计模式是怎么解决的
最后来画一下类图,我们学设计模式,一定要能熟练画出类图
总结:
2.1.2 工厂方法模式 我们回顾一下上面简单工厂产生的问题,就是简单工厂只能提供作者提供好的产品,我们无法对产品进行拓展
工厂方法
定义一个用于创建产品的接口,由子类决定生产什么产品
坏处: 加一个类,需要加一个工厂,类的个数成倍增加,增加维护成本,增加系统抽象性和理解难度
好处: 符合开闭原则
总结:简单工厂模式 + 开闭原则 = 工厂方法
我们来改造一下上面有问题的代码,我们现在不将工厂写死,而是面向抽象编程,将工厂定义为一个接口,在作者的代码中提供一些基本的实现,例如创建Hamburger、RichNoodle的实现
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 interface Food { void eat () ; } class Hamburger implements Food { @Override public void eat () { System.out.println("吃汉堡包..." ); } } class RichNoodle implements Food { @Override public void eat () { System.out.println("过桥米线" ); } } interface FoodFactory { Food getFood () ; } class HamburgerFactory implements FoodFactory { @Override public Food getFood () { return new Hamburger (); } } class RichNoodleFactory implements FoodFactory { @Override public Food getFood () { return new RichNoodle (); } } public class App { public static void main (String[] args) { FoodFactory foodFactory = new HamburgerFactory (); Food food = foodFactory.getFood(); food.eat(); } }
我们会发现我们将工厂作为接口暴露之后就有一个好处,如果我们想要新增加一个产品,我们不需要去修改原来的产品,而是通过继承Food创建产品类,再通过暴露的工厂接口创建工厂,再来实例化我们需要的产品,具体实现为:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 class PorkFeetRice implements Food { @Override public void eat () { System.out.println("吃猪角饭..." ); } } class PorkFeetRiceFactory implements FoodFactory { @Override public Food getFood () { return new PorkFeetRice (); } } public class App { public static void main (String[] args) { FoodFactory foodFactory = new PorkFeetRiceFactory (); Food food = foodFactory.getFood(); food.eat(); } }
我们可以看到,我们通过提供的工厂接口,并没有修改之前的工厂逻辑,又进行了拓展,并且新的产品和工厂实现类都是我们自己创建的,符合开闭原则
我们来总结一下工厂方法模式的优点 :
仍然具有简单工厂的优点,服务端修改了生产产品的逻辑时,用户端无感知
因为产品和工厂都是拓展出来的,所以不需要修改原来的代码,只需要创建一个新的产品和工厂即可
但是我们也有发现这样好像怪怪的,感觉就是暴露了个接口而已,读者可能会有以下的疑问 :
虽然说好像不管是简单工厂也好,工厂方法也罢,虽然都做到了和具体实现解耦,用户不用关注实现是否发生了改变,但是,反观我们现在的代码,好像还在依赖于具体的工厂,说的就是上面的PorkFeetRiceFactory,如果我们每生产一种产品,都要去知道这种产品对应的工厂,这又违反了迪米特法则,并且如果如果作者如果把工厂名字写错了,又会出现上面的问题
感觉折腾了一圈,又回到了原点,之前是依赖于具体的实现,现在是依赖具体的工厂,还是耦合的关系
我们来解释一下上面的两个问题:
首先,既然作者已经对外暴露了接口,那么作者有义务保存接口的稳定,不能出现改接口名的行为(或弃用)
其次工厂模式还可以隐藏一个实例创建的过程,学过spring等框架的同学就会知道,在框架中一个实例的创建并不只是简简单单new那么简单,可能还会牵涉到容器生命周期以及一些解析bean的操作,显然会复杂很多,所以工厂模式还帮我们隐藏了细节、封装了代码,至于具体要使用那个工厂,是我们应该去了解的,毕竟每个工厂提供产品都会不同
很多问题现在简单的业务下并不是问题,但是请不要忘记变这个字 ,我们的代码为什么要分一层又一层,就是为了能够在之后改变后的业务场景依旧能够使用,如果读者还有问题,请复习复习Spring IOC容器的设计,如果没有工厂,IOC容器如果做到解析那么多注解,如何完成依赖注入,如果完成各种Spring预留的拓展接口,如果完成Bean的声明周期
总结一下缺点 :
我们现在来画一下工厂方法模式的UML类图 :
最后总结一下 :
2.1.3 抽象工厂
抽象工厂模式
抽象工厂模式(Abstract Factory Pattern)是围绕一个超级工厂创建其他工厂。该超级工厂又称为其他工厂的工厂。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
在抽象工厂模式中,接口是负责创建一个相关对象的工厂,不需要显式指定它们的类。每个生成的工厂都能按照工厂模式提供对象
优点 :解决了工厂方法模式中类爆炸的问题,同时拥有其可拓展性的优点
缺点 :产品族扩展非常困难,要增加或删除一个系列的某一产品,既要在抽象的工厂里加代码,又要在具体的里面产品加代码,违背开闭原则
我们来后顾一下前面的两种工厂模式的缺点
简单工厂:耦合与具体的工厂实现,没有良好的拓展性
工厂方法:会产生类爆炸的问题,每一个产品类都需要对应的工厂,代码臃肿
我们现在要通过工厂方法设计量类产品的生产,分别是食物Food、饮料Drink,其中食物有三种,饮料有两种,我们会发现食物需要定义一个接口,三个具体产品类,一个抽象工厂类,三个具体工厂类;饮料需要定义一个接口,两个具体产品类,一个抽象工厂类,两个具体工厂类,一共14个类,我就想要产生五种类,好家伙,按照工厂方法的写法,直接写出14个类了
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 interface Food { void eat () ; } interface Drink { void drink () ; } class Hamburger implements Food { @Override public void eat () { System.out.println("吃汉堡包..." ); } } class RichNoodle implements Food { @Override public void eat () { System.out.println("过桥米线" ); } } class Cola implements Drink { @Override public void drink () { System.out.println("喝可口可乐..." ); } } class IcePeak implements Drink { @Override public void drink () { System.out.println("喝冰峰..." ); } } interface FoodFactory { Food getFood () ; } interface DrinkFactory { Drink getDrink () ; } class HamburgerFactory implements FoodFactory { @Override public Food getFood () { return new Hamburger (); } } class RichNoodleFactory implements FoodFactory { @Override public Food getFood () { return new RichNoodle (); } } class ColaFactory implements DrinkFactory { @Override public Drink getDrink () { return new Cola (); } } class IcePeakFactory implements DrinkFactory { @Override public Drink getDrink () { return new IcePeak (); } } class PorkFeetRice implements Food { @Override public void eat () { System.out.println("吃猪角饭..." ); } } class PorkFeetRiceFactory implements FoodFactory { @Override public Food getFood () { return new PorkFeetRice (); } } public class AbstractApp { public static void main (String[] args) { FoodFactory foodFactory = new PorkFeetRiceFactory (); Food food = foodFactory.getFood(); food.eat(); } }
上面的代码就是工厂设计模式,其实工厂设计模式到抽象工厂只有一步之遥,我们会发现上面导致类爆炸的原因就在于太多工厂类的接口了,那我们就将工厂类的接口再进行抽象,例如食物和饮料的工厂接口统一进行抽象,再将各自的实例工厂也进行合并
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 interface AbstractFactory { Food getFood () ; Drink getDrink () ; } class KFCFactory implements AbstractFactory { @Override public Food getFood () { return new Hamburger (); } @Override public Drink getDrink () { return new Cola (); } }
显然这样通过抽象 + 组合的方式,这样就可以减少一些类的产生
这样做的优点是就是在拥有工厂方法模式的优点下可以有效减少类的产生
缺点是好像在一个工厂类绑定死了具体的产品,例如KFCFactory -> Hamburger + Cola,我们为什么在这个工厂生成这两种产品
现在我们补充一下上面没有提到的两个概念:
我们可以看到如果要生产上面的25个具体产品,一共需要多少个抽象产品,多少个抽象工厂?都是五个;如果是工厂方法则需要25个类,可以看到通过不断组合的方式,可以大大减少抽象产品类和抽象工厂类的创建
👀👀👀 现在让我们想一想这样的设计有什么问题没有?我们好好想一想
🎯总结抽象工厂的缺点:
当产品等级发生改变时(增加、减少),都会引起之前工厂代码的修改,违背开闭原则
所以设计模式有优点的同时也一定都有自己的局限性,我们要看场景来使用具体的工厂模式,笔者在下一节总结中进行分析
抽象工厂总结:
2.1.4 工厂模式总结
工厂方法
优点
缺点
简单工厂
隐藏了类创建的细节,只需要类的标识就能创建一个类(多态)
产生很多映射关系;当添加产品时违反开闭原则
工厂方法
符合开闭原则(简单工厂模式 + 开闭原则 = 工厂方法)
加一个类,需要加一个工厂,类的个数成倍增加,增加维护成本,增加系统抽象性和理解难度
抽象工厂
解决了工厂方法模式中类爆炸的问题,同时拥有其可拓展性的优点
产品等级扩展非常困难,会违反开闭原则
工厂方法
适用场景
简单工厂
产品不扩充,简单工厂最好
工厂方法
产品经常要拓展(产品簇与产品等级)
抽象工厂
当产品等级固定,且产品簇需要拓展时
看了这么多好像这些工厂模式都不是我们心中最想要的结果,我们要的是既想马儿跑,又不想马儿吃草,即又不想多写代码,又想拥有良好的拓展性,那么这样的方法有吗?当然有。Spring就帮我们解决了,想想Spring是如何帮我们解决这个问题的,这将在下一节中揭晓谜底
2.1.5 Spring中的工厂模式 上面分析了这么久,还是不能满足我们好吃懒做既想马儿跑,又不想马儿吃草的需求,我们的目标是,既不能写过多的代码 ,就像工厂方法中类爆炸一样,又想要极致的拓展性 ,不能像抽象工厂一样不能添加产品等级
接下来让我们看看Spring中是如何解决的叭,可能很多同学平时框架用的爽,却根本不知道框架导致帮我们解决了什么问题,也不知道怎么解决的,这就导致一看源码就表示看不懂,很多面试题看了很多遍又会忘记,其实归根结底还是不理解,不会用,文章一开始我就讲过,最厉害的武功应该是忘记招式,无招胜有招!
直接揭晓答案叭,既想马儿跑,又不想马儿吃草的方案是:动态工厂 + 反射
当然并不是Spring中没有用其他的工厂,当然也用到了,像静态工厂(简单工厂)也运用到了,并且更多的不是一种设计模式使用,而是多种,例如:策略设计模式 + 工厂模式 + 模板方法模式
首先从BeanFactory这个顶层工厂接口说起,BeanFactory定义的是IOC容器最基本的规范
可以说BeanFactory 是 Spring 的心脏。它就是 Spring IoC 容器的真面目。Spring 使用 BeanFactory 来实例化、配置和管理 Bean。
相信被面试过BeanFactory面试题的同学对下面的张图一定很熟悉
从上面我们可以看到BeanFactory有三个实现接口,分别是ListableBeanFactory、HierarchicalBeanFactory和AutowireCapableBeanFactory,并且井井有序,继承结构设计的非常优秀,其中:
BeanFactory作为一个主接口不继承任何接口,暂且称为一级接口
有3个子接口继承了它,进行功能上的增强。这3个子接口称为二级接口
ConfigurableBeanFactory可以被称为三级接口 ,对二级接口HierarchicalBeanFactory进行了再次增强,它还继承了另一个外来的接口SingletonBeanRegistry
ConfigurableListableBeanFactory是一个更强大的接口,继承了上述的所有接口,无所不包,称为四级接口
(这4级接口是BeanFactory的基本接口体系。继续,下面是继承关系的2个抽象类和2个实现类:)
AbstractBeanFactory作为一个抽象类,实现了三级接口ConfigurableBeanFactory大部分功能
AbstractAutowireCapableBeanFactory同样是抽象类,继承自AbstractBeanFactory,并额外实现了二级接口AutowireCapableBeanFactory
DefaultListableBeanFactory继承自AbstractAutowireCapableBeanFactory,实现了最强大的四级接口ConfigurableListableBeanFactory,并实现了一个外来接口BeanDefinitionRegistry,它并非抽象类
最后是最强大的XmlBeanFactory,继承自DefaultListableBeanFactory,重写了一些功能,使自己更强大,但是这个类现在以及被标记为过期类,Spring官方建议使用:BeanFactory懒加载 或者 ApplicationContext中的逻辑来替换它
看看我们上面写的是什么玩意,跟玩具一样,就抽象了一层,不仅想解耦还想高拓展,实际的开发场景往往是十分复杂的,学习设计模式一定要把变字牢牢的记在心里。Spring中复杂的继承和抽象结构,就是为了满足尽可能多的应用场景
名字
作用
(一级接口)BeanFactory
定义的是IOC容器最基本的规范,核心方法getBean()
(二级接口)ListableBeanFactory
实现对Bean实例的枚举,以及对默些公共特征Bean的管理(同一产品等级)
(二级接口)HierarchicalBeanFactory
在BeanFactory定义的功能上增加了对父容器的定义,表示Bean继承关系
(二级接口)AutowireCapableBeanFactory
Bean的创建注入并提供对Bean的初始化前后拓展性处理
(三级接口)ConfigurableBeanFactory
提供配置Factory的各种方式
(四级接口)ConfigurableListableBeanFactory
修改Bean定义信息和分析Bean的功能,实现了预实例化单例Bean以及冻结当前工厂配置的功能
(抽象类)AbstractBeanFactory
Bean的创建和信息描述抽象方法,由继承者实现
(抽象类)AbstractAutowireCapableBeanFactory
实现Bean的创建并解决依赖注入问题,实现createBean()方法
(实现类)DefaultListableBeanFactory
对Bean容器完全成熟的默认实现,可对外使用
我们先来看(一级接口)BeanFactory,可以看到BeanFactory的核心方法就一个getBean(),还有一些获取Bean属性的方法
接下来就是(二级接口)HierarchicalBeanFactory,它的方法更少,核心就是getParentBeanFactory(),我们知道不同的Bean有不同的工厂加载,这个方法就是获取这个Bean工厂的父工厂的,主要是为了解决IOC容器循环依赖的问题,其中在IOC容器中定义一个Bean是否一样,不仅要判断Bean是否一样,还需要判断创建其的工厂是否一样,这里就不展开讲了
(二级接口)ListableBeanFactory
(二级接口)AutowireCapableBeanFactory:
(三级接口)ConfigurableBeanFactory主要是提供配置Factory的各种方法,主要的方法有:
setConversionService():设置转换器
addBeanPostProcess():添加Bean的后置处理器
destoryBean():销毁Bean
(四级接口)ConfigurableListableBeanFactory:修改Bean定义信息和分析Bean的功能,实现了预实例化单例Bean以及冻结当前工厂配置的功能
(抽象类)AbstractBeanFactory,Bean的创建和信息描述抽象方法,定义createBean()方法,核心方法有:
getBeanDefinition():BeanDefinition我们熟,Bean的定义,这个方法就是获取Bean的信息
createBean():创建Bean,由继承者来实现
(抽象类)AbstractAutowireCapableBeanFactory:实现Bean的创建并解决依赖注入问题,实现createBean()方法
好重点来了兄弟们,看来这么多层的抽象,终于到了创建Bean的地方,让我们到源码里面看看Spring是如何优雅的创建产品的
看来这么多,可能读者还是没明白在Spring中是如果动态创建产品的,其实过程很简单,我们想想在平时的编码中会干什么
首先我们会将项目分层,分为controller、service、dao等层次,我们使用SpringBoot的时候只需要加一个注解SpringBootApplication,就能自动扫描当前包及其子包下面被标记了@Component注解的类,然后加载到Spring的容器中,我们想想,我们需要管实现类的类名是什么吗?需要管实现内的代码改没改吗?都不需要,Spring会帮我们将其注册到IOC容器中,并且依靠强大的DI来进行注入,每次启动项目都会动态的去扫描,并且依靠各种工厂去创建产品
1
2
3
4
5
@Component public class XXXService { @Autowired(required = false) private XXXDao xxxdao; }
我们来思考到底比之前的工厂模式好在哪里
总结:总而言之,言而总之,Spring是如何解决工厂模式问题的?
通过动态工厂 + 反射,通过添加@Component注解动态获取Bean的定义,解决简单工厂中不能动态添加产品的问题
通过反射解决抽象工厂中无法拓展产品等级 的问题;并且解决工厂方法中类爆炸的问题
通过强大的依赖注入,解决接口与实现类之间耦合的问题,并且可以进行自动装配,条件装配,真正面向接口编程
2.1.6 工作中工厂方法使用 没有实际业务场景,一切都是无源之水、无本之木,是空洞的,现在我们举一个笔者实际开发中配合IOC容器使用的工厂模式的例子
现在有一个场景,就是需要做登录,但是我们不确定现在移动端的同学做几端,可能会有手机号登录、账号密码登录、qq登录、微信登录、PC端登录、网页端登录 。这些登录的具体实现肯定是不一样的,而且我们并不知道到底要做几种策略,并且之后一定会有所拓展
所以我们一般会用IOC容器 + 工厂模式 + 策略模式 + 模板方法模式来完成这些功能
首先我们要定义一个策略接口,用来动态获取Bean(产品)的定义,该接口继承InitializingBean,我们后面动态添加的策略只需要实现该接口,通过回调我们的注册方法,就能将自己添加到我们自己的工厂中
1 2 3 4 5 6 7 8 9 10 11 12 public interface LoginHandle extends InitializingBean { void login (Map<String,String> params) ; }
设计我们自己的登录工厂
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public class LoginFactory { private static Map<String, LoginHandle> loginStrategyFactoryMap = new ConcurrentHashMap <>(); public static LoginHandle getLoginStrategy (String loginSign) { return loginStrategyFactoryMap.get(loginSign); } public static void register (String loginSign, LoginHandle loginHandle) { if (StringUtils.isEmpty(loginSign) || Objects.isNull(loginHandle)) { throw new RuntimeException ("登录策略注册失败,参数错误" ); } loginStrategyFactoryMap.put(loginSign, loginHandle); } }
例如我现在是手机号登录,我们就写一个具体的实现类,并实现我们的策略接口
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 @Slf4j @Component public class PhoneNumberLoginStrategy implements LoginHandle { private static final String PHONE_NUMBER_LOGIN_STRATEGY = "PHONE_NUMBER_LOGIN_STRATEGY" ; @Override public void login (Map<String, String> params) { if (log.isDebugEnabled()) { log.debug("用户通过手机号码登录,参数为:{}" , params); } } @Override public void afterPropertiesSet () throws Exception { LoginFactory.register(PHONE_NUMBER_LOGIN_STRATEGY, this ); } }
我们来思考一下上面的策略模式 + 工厂模式解决了之前工厂模式的什么问题
首先,新增策略(产品),只需要实现LoginHandle策略接口,通过将自己的映射关系注册到工厂中,解决了简单工厂中无法拓展的问题
其次,每个策略上用@Component标记,表示这个Bean的实例交给Spring完成,通过反射解决抽象工厂无法拓展产品等级的问题
我们现在想要调用不同的执行策略,只需要让前端小哥哥在用户登录的时候传不同的标识,例如LoginSign = PHONE_NUMBER_LOGIN_STRATEGY,我们只需要
1
2
3
4
5
6
7
8
9
10
11
@Controller public class LoginController { @PostMapping("/user/login") public ResponseEntity<Void> login (@RequestBody Map<String, String> params) { LoginHandle loginHandle = LoginFactory.getLoginStrategy(params.get("LoginSign" )); loginHandle.login(params); return ResponseEntity.ok().build(); } }
这样如果下次需要新增加一种登录,我只需要写好具体的策略并实现策略接口,再和前端小哥沟通好标识就行了,上面这个Controller中的代码完全不用修改,这样既然解耦了,也能做到极致的拓展,并且完成不用写多余的代码,真正做到又想马儿跑,又不给马儿吃草
但是这样就ok了吗???笔者一再强调,开发讲究的就是一个变字,并且细心的小伙伴可能已经发现现在的类图好像看起来还是有点不太合理,现在的类图长这样
好像我们现在的实现类现在耦合接口LoginHandle了,有的同学会有疑问,什么叫耦合接口???不就应该面向接口编程吗?难道接口会变?对,接口就是会变,如果现在我们辛辛苦苦写了十种策略,马上要下班了,现在前端小哥说,还有一个下线的功能别忘记写了
好,现在BBQ了,我们得去该接口LoginHandle,新添加logout的接口,并且在十种策略里面都添加下线的实现,违反了开闭原则,并且我们假设,有的策略是不需要登出功能,而且又导致有些策略类不得不实现一个空方法,有的同学会问,难道不能在重新写一套工程和策略吗?当然不好,注册登录登出,本来就应该在一个体系里面
总结一下上面的问题:
依赖于LoginHandle接口,并且实现类必须要实现里面的所有接口,如果实现类有不想实现的,也必须实现
这里我们再引入板方法模式,也就是在接口与实现类之前再套一层,看多了源码的同学肯定知道,那有接口下面直接就是实现的,一般都要再套一层抽象层进行解耦
我们现在再来捋一捋思路,首先我们现在接口里面新增加一个方法
1
2
3
4
5
6
7
8
9
10
11
public interface LoginHandle extends InitializingBean { void login (Map<String, String> params) ; void logout () ; }
我们再创建一层抽象层AbstractLoginHandle,称为模板方法
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 public class AbstractLoginHandle implements LoginHandle { @Override public void login (Map<String, String> params) { throw new UnsupportedOperationException (); } @Override public void logout () { throw new UnsupportedOperationException (); } @Override abstract public void afterPropertiesSet () ; }
接下来修改我们具体的登录实现类,可以发现中间套了一层到好处是不用实现接口里面所有的方法,只需要有需要的实现即可,例如现在微信登录不需要登出功能,我们就可以这样写
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 @Slf4j @Component public class WXrLoginStrategy extends AbstractLoginHandle { private static final String WX_LOGIN_STRATEGY = "WX_LOGIN_STRATEGY" ; @Override public void login (Map<String, String> params) { if (log.isDebugEnabled()) { log.debug("用户微信登录,参数为:{}" , params); } } @Override public void afterPropertiesSet () throws Exception { LoginFactory.register(WX_LOGIN_STRATEGY, this ); } }
我们开看一下现在的类图:
现在的这个结构就算比较合理的了,但是还可以拓展,这里就不展开了
最后再提一嘴,我们这里的工厂模式是不是不属于上面提到的任何一种设计模式,其实这上面的模板方法模式和严格意义上的也有区别,希望读者始终记住,请不要死板的套用设计模式,网上随便搞篇博客上来就是写各种接口抽象类,你会发现其实用起来不是特别的顺手,只有多总结多归纳多思考,当我们真正理解后,就不会局限于那种设计模式了,而是下意识就会去这样设计,一看类图就知道这里不合理,做到无招胜有招
2.2 原型模式
原型模式(Prototype Pattern)
原型模式(Prototype Pattern)是用于创建重复的对象,同时又能保证性能。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。
这种模式是实现了一个原型接口,该接口用于创建当前对象的克隆。当直接创建对象的代价比较大时,则采用这种模式。例如,一个对象需要在一个高代价的数据库操作之后被创建。我们可以缓存该对象,在下一个请求时返回它的克隆,在需要的时候更新数据库,以此来减少数据库调用
现在我们来想一个场景,例如我们现在要写周报,大家作为互联网打工人肯定每周都是要向老板反馈工作内容的,现在我们发现周报里面需要填很多信息,例如姓名、部门、职位等等,这些信息基本都不会变,但是每次填周报我们又需要填一遍,这样显然不合理,我们其实想的是,写周报只需要填汇报内容即可,如下图所示:
那我们应该怎么办呢?是不是希望能够保存一下上一次编辑的模板,下次直接修改内容就可以了,我们用一个类来表示一下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
@Data @Accessors(chain = true) class WeekReport { private int id; private String emp; private String summary; private String plain; private String suggestion; private String department; private LocalDateTime submitDate; } public class AppTest { public static void main (String[] args) { WeekReport weekReport = new WeekReport (); weekReport.setEmp("奈李" ) .setSummary("本周主要完成了七大设计原则和工厂模式的学习" ) .setPlain("在下周的工作中完成原型模式学习" ) .setDepartment("互联网事业部" ) .setSubmitDate(LocalDateTime.now()); System.out.println(weekReport); WeekReport weekReport2 = new WeekReport (); weekReport2.setEmp("奈李" ) .setSummary("本周主要完成了剩下设计模式的学习" ) .setPlain("在下周会完成阿里巴巴开发手册学习" ) .setDepartment("互联网事业部" ) .setSubmitDate(LocalDateTime.now()); System.out.println(weekReport2); } }
我们会发现其实下一周要进行汇报时,我们只需要修改总结和下周计划的内容,但是现在我们却只能再新建一个对象重复上述代码
我们想要什么,想要的是直接克隆出一个对象来,将需要改变的填一下,不变的用之前的就好
我们现在通过克隆来实现上面的需求,在Java中只需要实现Cloneable,并重写克隆方法即可
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
@Data @Accessors(chain = true) class WeekReport implements Cloneable { private int id; private String emp; private String summary; private String plain; private String suggestion; private String department; private LocalDateTime submitDate; @Override protected Object clone () throws CloneNotSupportedException { return super .clone(); } } public class AppTest { public static void main (String[] args) throws CloneNotSupportedException { WeekReport weekReport = new WeekReport (); weekReport.setEmp("奈李" ) .setSummary("本周主要完成了七大设计原则和工厂模式的学习" ) .setPlain("在下周的工作中完成原型模式学习" ) .setDepartment("互联网事业部" ) .setSubmitDate(LocalDateTime.now()); System.out.println(weekReport); WeekReport weekReport2 = (WeekReport) weekReport.clone(); weekReport2.setSummary("本周主要完成了剩下设计模式的学习" ) .setPlain("在下周会完成阿里巴巴开发手册学习" ) .setSubmitDate(LocalDateTime.now()); System.out.println(weekReport2); } }
这就是原型设计模式,是不是感觉挺简单的,这里还有几个点要注意一下
上面的克隆其实只是浅拷贝
使用clone方法创建对象,并不会调用该对象的构造器
因为Object类的clone方法是一个本地方法,它直接操作内存中的二进制流,特别是复制大对象时,性能的差别非常明显。
2.2.1 深拷贝浅拷贝
类型
特点
浅拷贝
Object类的clone方法只会拷贝对象中的基本的数据类型,对于数组、容器对象、引用对象等都不会拷贝,这就是浅拷贝
深拷贝
会将原本对象中的数组、容器对象、引用对象等另行拷贝(完全是新的对象)
有的同学在这里总是傻傻分不清楚,就知道浅拷贝就是引用类型不拷贝,然后指向之前对象的堆空间,分不清成员变量中的引用是啥
上面的可以把setSubmitDate看做一个指针,你弄了一个新对象给它,当然会在堆空间里面新申请一块内存,当然就不一样了
那我们如何深拷贝呢?其实也很简单,既然原来的Object.clone()方法无法克隆引用类型,那我们自己来克隆就好了
其中大部分类其实都是实现了clone方法的
1
2
3
4
5
6
7
8
@Override protected Object clone () throws CloneNotSupportedException { WeekReport cloneWeekReport = (WeekReport) super .clone(); Date cloneSubmitDate = (Date) cloneWeekReport.getSubmitDate().clone(); cloneWeekReport.setSubmitDate(cloneSubmitDate); return cloneWeekReport; }
但是这样显然很麻烦,如果我们克隆的是自己定义的对象,或者是对象里面套对象,这样层层嵌套的形式,显然就有点麻烦了
2.2.2 封装深拷贝工具 所以我们一般是用序列化和反序列化来做的,并且会封装成一个工具,这个拷贝在开发中还是非常常见的,例如我们经常将一个PO转换为一个VO(就是拷贝对象),一般用Spring自带的BeanUtils,但是它只能浅拷贝,我们现在自己封装一个,可以选择继承Spring自带的BeanUtils,或者就放deepClone这一个方法就行
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 @Slf4j public final class BeanUtil extends BeanUtils { private BeanUtil () { throw new UnsupportedOperationException (); } public static <T> T copyProperties (Object source, Class<T> targetClass) { if (checkNull(source, targetClass)) { return null ; } try { T newInstance = targetClass.newInstance(); copyProperties(source, newInstance); return newInstance; } catch (Exception e) { log.error("error: " , e); return null ; } } @SuppressWarnings("unchecked") public static <T extends Serializable > T deepClone (T object) { T cloneObject = null ; try { ByteArrayOutputStream outputStream = new ByteArrayOutputStream (); ObjectOutputStream objectOutputStream = new ObjectOutputStream (outputStream); objectOutputStream.writeObject(object); objectOutputStream.close(); ByteArrayInputStream inputStream = new ByteArrayInputStream (outputStream.toByteArray()); ObjectInputStream objectInputStream = new ObjectInputStream (inputStream); cloneObject = (T) objectInputStream.readObject(); objectInputStream.close(); } catch (ClassNotFoundException | IOException e) { log.info("拷贝异常::" , e); } return cloneObject; } public static <T> T copyProperties (Object source, Class<T> targetClass, String... ignoreProperties) { if (checkNull(source, targetClass)) { return null ; } try { T newInstance = targetClass.newInstance(); copyProperties(source, newInstance, ignoreProperties); return newInstance; } catch (Exception e) { log.error("error: " , e); return null ; } } public static <T> List<T> copyProperties (List<?> sources, Class<T> targetClass) { if (checkNull(sources, targetClass) || sources.isEmpty()) { return new ArrayList <>(); } return sources.stream().map(source -> copyProperties(source, targetClass)).collect(Collectors.toList()); } private static <T> boolean checkNull (Object source, Class<T> targetClass) { return Objects.isNull(source) || Objects.isNull(targetClass); } }
现在在来看看原来的拷贝,这里需要注意进行序列化的对象需要实现Serializable接口
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
@Data @Accessors(chain = true) class WeekReport implements Serializable { private static final long serialVersionUID = 4455534412412L ; private int id; private String emp; private String summary; private String plain; private String suggestion; private String department; private Date submitDate; } public class DeepCloneTest { public static void main (String[] args) throws CloneNotSupportedException, InterruptedException { WeekReport weekReport = new WeekReport (); weekReport.setEmp("奈李" ) .setSummary("本周主要完成了七大设计原则和工厂模式的学习" ) .setPlain("在下周的工作中完成原型模式学习" ) .setDepartment("互联网事业部" ) .setSubmitDate(new Date ()); System.out.println("weekReport的时间:" + weekReport.getSubmitDate()); WeekReport weekReport2 = BeanUtil.deepClone(weekReport); weekReport2.setSummary("本周主要完成了剩下设计模式的学习" ) .setPlain("在下周会完成阿里巴巴开发手册学习" ); weekReport2.getSubmitDate().setTime(0 ); System.out.println(weekReport == weekReport2); System.out.println("weekReport2的时间:" + weekReport2.getSubmitDate()); System.out.println("weekReport的时间:" + weekReport.getSubmitDate()); } }
2.2.3 原型模式小结 是不是感觉其实原型模式也没啥,确实也没啥,所以23中设计模式其实有的模式其实还是挺简单的
2.3 建造者模式
建造者模式(Builder Pattern)
建造者模式(Builder Pattern)使用多个简单的对象一步一步构建成一个复杂的对象。这种类型的设计模式属于创建型模式,它提供了一种创建对象的最佳方式。一个 Builder 类会一步一步构造最终的对象。该 Builder 类是独立于其他对象的。
优点: 1、建造者独立,易扩展。 2、便于控制细节风险。缺点: 1、产品必须有共同点,范围有限制。 2、如内部变化复杂,会有很多的建造类。
例如我们现在有一个电脑类,里面有一些属性
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
@Data @Accessors(chain = true) class Compute { private String cpu; private String gpu; private String memory; private String hd; } public class BuilderTest { public static void main (String[] args) { Compute compute = new Compute () .setCpu("i7-10700" ) .setGpu("3080 Ti" ) .setMemory("32G" ) .setHd("1T" ); System.out.println(compute); } }
这样其实也有些问题:
对象实例化的时候就必须要为每一个属性赋值,比较麻烦
对于使用者来说,相当于给你一堆零件,然后需要自己组装
现在来改进一下,这里作者需要专门创建一个ComputeBuilder类,来专门负责组装电脑的过程
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
@Data @Accessors(chain = true) class Compute { private String cpu; private String gpu; private String memory; private String hd; } class ComputeBuilder { private Compute compute = new Compute (); public Compute builder () { return compute.setCpu("i7-10700" ) .setGpu("3080 Ti" ) .setMemory("32G" ) .setHd("1T" ); } } public class BuilderTest { public static void main (String[] args) { ComputeBuilder computeBuilder = new ComputeBuilder (); Compute compute = computeBuilder.builder(); System.out.println(compute); } }
上述代码的好处是:
但是这样的缺点是什么?
好像封装的太厉害了,无论客户需要什么,返回都是一样的配置
我们再改造一下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
@Data @Accessors(chain = true) class Compute { private String cpu; private String gpu; private String memory; private String hd; } interface IcomputeBuilder { Compute builder () ; } class HighComputeBuilder implements IcomputeBuilder { private Compute compute = new Compute (); public Compute builder () { return compute.setCpu("i7-10700" ) .setGpu("3080 Ti" ) .setMemory("32G" ) .setHd("1T" ); } } class MiddleComputeBuilder implements IcomputeBuilder { private Compute compute = new Compute (); public Compute builder () { return compute.setCpu("i5-9500" ) .setGpu("2080 Ti" ) .setMemory("16G" ) .setHd("1T" ); } } class LowComputeBuilder implements IcomputeBuilder { private Compute compute = new Compute (); public Compute builder () { return compute.setCpu("i3-8500" ) .setGpu("1080 Ti" ) .setMemory("8G" ) .setHd("500G" ); } } public class BuilderTest { public static void main (String[] args) { IcomputeBuilder highBuilder = new HighComputeBuilder (); IcomputeBuilder middleBuilder = new MiddleComputeBuilder (); IcomputeBuilder lowBuilder = new LowComputeBuilder (); Compute highCompute = highBuilder.builder(); System.out.println(highCompute); Compute middleCompute = middleBuilder.builder(); System.out.println(middleCompute); Compute lowCompute = lowBuilder.builder(); System.out.println(lowCompute); } }
这样以来用户可以通过选取不同的建造者,来生产不同的产品,但是这里还是有问题
我们发现在不同的构造者中,有重复的代码,既然有重复的代码,那就有坏味道
构建的过程是不稳定的,如果某个建造者遗漏掉了哪一步,那么生产出来的产品就是不合格的,但是编译器却不会报错
我们得再进行改造
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
@Data @Accessors(chain = true) class Compute { private String cpu; private String gpu; private String memory; private String hd; } interface IcomputeBuilder { IcomputeBuilder cpu () ; IcomputeBuilder gpu () ; IcomputeBuilder memory () ; IcomputeBuilder hd () ; Compute builder () ; } class HighComputeBuilder implements IcomputeBuilder { private Compute compute = new Compute (); @Override public IcomputeBuilder cpu () { compute.setCpu("i7-10700" ); return this ; } @Override public IcomputeBuilder gpu () { compute.setGpu("3080 Ti" ); return this ; } @Override public IcomputeBuilder memory () { compute.setMemory("32G" ); return this ; } @Override public IcomputeBuilder hd () { compute.setHd("1T" ); return this ; } public Compute builder () { return compute; } } public class BuilderTest { public static void main (String[] args) { IcomputeBuilder highBuilder = new HighComputeBuilder (); Compute highCompute = highBuilder.cpu().gpu().memory().hd().builder(); System.out.println(highCompute); } }
我们看这样进行构建的优点:
建造者类中的建造过程是稳定的。不会漏掉某一步!!这样当客户端想扩展建造者时,也不会漏掉某一步
缺点:
如果有多个建造者,代码任然会有重复
现在又变成了客户端自己配置电脑,又违反了迪米特法则。(这相当于,你去电脑城配电脑,虽然不用你亲自组装电脑,但是你必须指挥那个装机boy,下一步该干啥,下一步该干啥,虽然隐藏细节,但是还是要指挥
我们想要的是连指挥过程也要隐藏起来
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
@Data @Accessors(chain = true) class Computer { private String cpu; private String gpu; private String memory; private String hd; } interface IComputerBuilder { IComputerBuilder cpu () ; IComputerBuilder gpu () ; IComputerBuilder memory () ; IComputerBuilder hd () ; Computer builder () ; } class Director { public Computer build (IComputerBuilder computerBuilder) { return computerBuilder.cpu().gpu().memory().hd().builder(); } } class HighComputerBuilder implements IComputerBuilder { private Computer computer = new Computer (); @Override public IComputerBuilder cpu () { computer.setCpu("i7-10700" ); return this ; } @Override public IComputerBuilder gpu () { computer.setGpu("3080 Ti" ); return this ; } @Override public IComputerBuilder memory () { computer.setMemory("32G" ); return this ; } @Override public IComputerBuilder hd () { computer.setHd("1T" ); return this ; } public Computer builder () { return computer; } } public class BuilderTest { public static void main (String[] args) { IComputerBuilder highBuilder = new HighComputerBuilder (); Director director = new Director (); Computer highComputer = director.build(highBuilder); System.out.println(highComputer); } }
建造者负责建造,指挥者负责指挥,创建对象的过程是稳定的(IComputerBuilder接口负责稳定),创建对象的过程也不会有重复代码(指挥者完成)
当需要拓展新的产品时,不需要修改原来的代码,只需要实现构建者接口,然后交给指挥者完成即可,这里就将构造和流程分别由构造者和指挥者进行解耦
建造者作为中间层,进行解耦
最后画一下UML类图:
2.3.1 建造者与工厂模式的区别
工厂模式只负责创建实例,并不关心里面的属性和构建的过程;建造者模式更加关注构建的过程,通过一些规范的流程、标准构建合格的产品
2.3.2建造者模式总结
2.4 组合模式
我们先来看下面的代码,目前我们将公共代码抽象成了MenuComponent
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
package com.fx.structurePattren.composite.a;import lombok.Data;import java.util.ArrayList;import java.util.List;public class TestApp { public static void main (String[] args) { Menu menu = new Menu ("湖南菜" , "湖南人爱吃的菜" ); menu.add(new MenuItem ("鸭" , "永州血鸭" )); menu.add(new MenuItem ("蚂蚁上树" , "永州血鸭" )); Menu menu2 = new Menu ("辣椒炒肉" , "湖南人爱吃辣椒炒肉" ); menu.print("\t |--" ); } @Data static class MenuComponent { private String name; private String description; public MenuComponent () {} public MenuComponent (String menuName, String description) { setName(menuName); setDescription(description); } } @Data static class Menu extends MenuComponent { private List<MenuItem> menuItemList = new ArrayList <>(); public Menu (String menuName, String description) { super (menuName, description); } public void add (MenuItem menuItem) { menuItemList.add(menuItem); } public void print (String prefix) { System.out.println("menu " + getName() + "--" + getDescription()); for (MenuItem menuItem : menuItemList) { menuItem.print(prefix); } } } @Data static class MenuItem extends MenuComponent { public MenuItem (String menuName, String description) { super (menuName, description); } public void print (String prefix) { System.out.println(prefix + getName() + "--" + getDescription()); } } }
优化后,核心点就是将print方法抽象到父类中,在menu递归时调用print方法会由子类进行实现,对应menu就会进行递归
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
public class TestApp { public static void main (String[] args) { Menu menu = new Menu ("湖南菜" , "湖南人爱吃的菜" ); menu.add(new MenuItem ("鸭" , "永州血鸭" )); menu.add(new MenuItem ("蚂蚁上树" , "粉丝肉末" )); Menu menu2 = new Menu ("辣椒炒肉" , "湖南人爱吃辣椒炒肉" ); menu2.add(new MenuItem ("普通辣" , "普通辣" )); menu2.add(new MenuItem ("爆辣" , "爆辣" )); Menu menu3 = new Menu ("江西菜" , "江西菜" ); menu3.add(new MenuItem ("小炒黄牛肉" , "鲜嫩可口" )); menu3.add(new MenuItem ("明基虾" , "香辣美味" )); menu2.add(menu3); menu.add(menu2); MenuItem mi3 = new MenuItem ("剁椒鱼头" , "经典湘菜" ); menu.add(mi3); menu.print("" ); } @Data abstract static class MenuComponent { private String name; private String description; public MenuComponent () { } public MenuComponent (String menuName, String description) { setName(menuName); setDescription(description); } protected abstract void print (String prefix) ; } @Data static class Menu extends MenuComponent { private List<MenuComponent> menuItemList = new ArrayList <>(); public Menu (String menuName, String description) { super (menuName, description); } public void add (MenuComponent menuComponent) { menuItemList.add(menuComponent); } public void print (String prefix) { System.out.println(prefix + "menu " + getName() + "--" + getDescription()); String newPrefix = prefix + "\t |--" ; for (MenuComponent menuComponent : menuItemList) { menuComponent.print(newPrefix); } } } @Data static class MenuItem extends MenuComponent { public MenuItem (String menuName, String description) { super (menuName, description); } public void print (String prefix) { System.out.println(prefix + getName() + "--" + getDescription()); } } } menu 湖南菜--湖南人爱吃的菜 |--鸭--永州血鸭 |--蚂蚁上树--粉丝肉末 |--menu 辣椒炒肉--湖南人爱吃辣椒炒肉 |-- |--普通辣--普通辣 |-- |--爆辣--爆辣 |-- |--menu 江西菜--江西菜 |-- |-- |--小炒黄牛肉--鲜嫩可口 |-- |-- |--明基虾--香辣美味 |--剁椒鱼头--经典湘菜
现在变化来了,xu’yao
3. 结构型模式
结构型模式
这些设计模式关注类和对象的组合。继承的概念被用来组合接口和定义组合对象获得新功能的方式
3.1 装饰器模式
装饰器模式(Decorator Pattern)
装饰器模式(Decorator Pattern)允许向一个现有的对象添加新的功能,同时又不改变其结构。这种类型的设计模式属于结构型模式,它是作为现有的类的一个包装。
这种模式创建了一个装饰类,用来包装原有的类,并在保持类方法签名完整性的前提下,提供了额外的功能。
3.1.1 装饰器模式案例 我们现在来看一个业务场景,星巴克卖咖啡,一开始只有四种咖啡,分别是:Decaf低咖咖啡、Espresso浓缩咖啡、DrakRoast焦糖咖啡、HouseBlend混合咖啡
由于这四种咖啡都有共性,所以很久之前的开发人员给他们上了一个父类Beverage,饮料类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
@Data abstract class Beverage { private String description; public Beverage (String description) { this .description = description; } public abstract double cost () ; } class Decaf extends Beverage { public Decaf () { super ("无糖咖啡" ); } @Override public double cost () { return 1 ; } } class Espresso extends Beverage { public Espresso () { super ("浓缩咖啡" ); } @Override public double cost () { return 5 ; } } class DrakRoast extends Beverage { public DrakRoast () { super ("焦糖咖啡" ); } @Override public double cost () { return 15 ; } } class HouseBlend extends Beverage { public HouseBlend () { super ("混合咖啡" ); } @Override public double cost () { return 10 ; } } public class AppTest { public static void main (String[] args) { Beverage decaf = new Decaf (); Beverage espresso = new Espresso (); Beverage drakRoast = new DrakRoast (); Beverage houseBlend = new HouseBlend (); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , decaf.getDescription(), decaf.cost())); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , espresso.getDescription(), espresso.cost())); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , drakRoast.getDescription(), drakRoast.cost())); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , houseBlend.getDescription(), houseBlend.cost())); } }
这样看代码好像并没有什么问题,可是现在变化来了,现在星巴克老板为了提高竞争力,需要往咖啡里面加调料,我们假设之前的代码是作者写死了的,我们无法改变,那么现在如何
例如调料我们现在有摩卡、泡沫、白糖、牛奶,我们现在想要给上面写的四个类加上牛奶,但是由于我们不能修改源代码并且符合开闭原则,我们只能通过继承的方式
1 2 3 4 5 6 7 8 9 class DecafWithMilk { } class EspressonWithMilk { } ...
好像感觉到不对劲了叭,这才是一种调料的组合,如果我需要摩卡 + 白糖、摩卡 + 牛奶 。。。等等组合?还维护的下去吗?现在会造成类爆炸的问题,我们看一下会有多少类,结论是有多少组合就会产生多少类
如果你非常强大,硬着头皮写完了所有类,现在老板说又要加一种调料,之前是四种,组合有15中组合,现在五种调料,有31中,六种调料有63种,这合理吗?老板说一句话的功夫,如果不懂设计模式,那就得通宵加班
其实我们并不需要为每一种调料都添加,我们用装饰器模式完成这个功能:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 abstract class Condiment extends Beverage { protected Beverage beverage; public Condiment (Beverage beverage) { super ("调料" ); this .beverage = beverage; } } class Milk extends Condiment { public Milk (Beverage beverage) { super (beverage); } @Override public double cost () { return beverage.cost() + 0.2 ; } @Override public String getDescription () { return beverage.getDescription() + " 牛奶" ; } } class Mocha extends Condiment { public Mocha (Beverage beverage) { super (beverage); } @Override public double cost () { return beverage.cost() + 0.5 ; } @Override public String getDescription () { return beverage.getDescription() + " 摩卡" ; } } public class AppTest { public static void main (String[] args) { Beverage decaf = new Decaf (); Milk milk = new Milk (decaf); Mocha mocha = new Mocha (milk); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , milk.getDescription(), milk.cost())); System.out.println(String.format("咖啡描述:%s,咖啡价格:%.2f" , mocha.getDescription(), mocha.cost())); } }
1
2
咖啡描述:无糖咖啡 牛奶,咖啡价格:1.20 咖啡描述:无糖咖啡 牛奶 摩卡,咖啡价格:1.70
可能读者看到上面的代码有点蒙蔽,请多看两遍,但是上述的代码确实在不改动源代码的前提下,完成了动态添加调料的功能!
我们重点看这几行代码:
1 2 3 4 Milk milk = new Milk (decaf);Mocha mocha = new Mocha (milk);
这几行就是精华了,我们称之为想要添加什么功能就用对应的类装饰就行了!,我们把这种类称为ConcreteDecorator(具体装饰类)
我们不能用传统的继承关系看上面的代码,认为 Milk是不能继承Condiment的,我们仔细看 Milk到底做了啥
1
2
3
4
5
6
class Milk extends Condiment { public Milk (Beverage beverage) { super (beverage); } 。。。 }
可以看到Milk不仅继承了Beverage饮料类,还关联了饮料类,关联是想要获取想要装饰的对象,继承是为了在原有的基础上对装饰对象的装饰
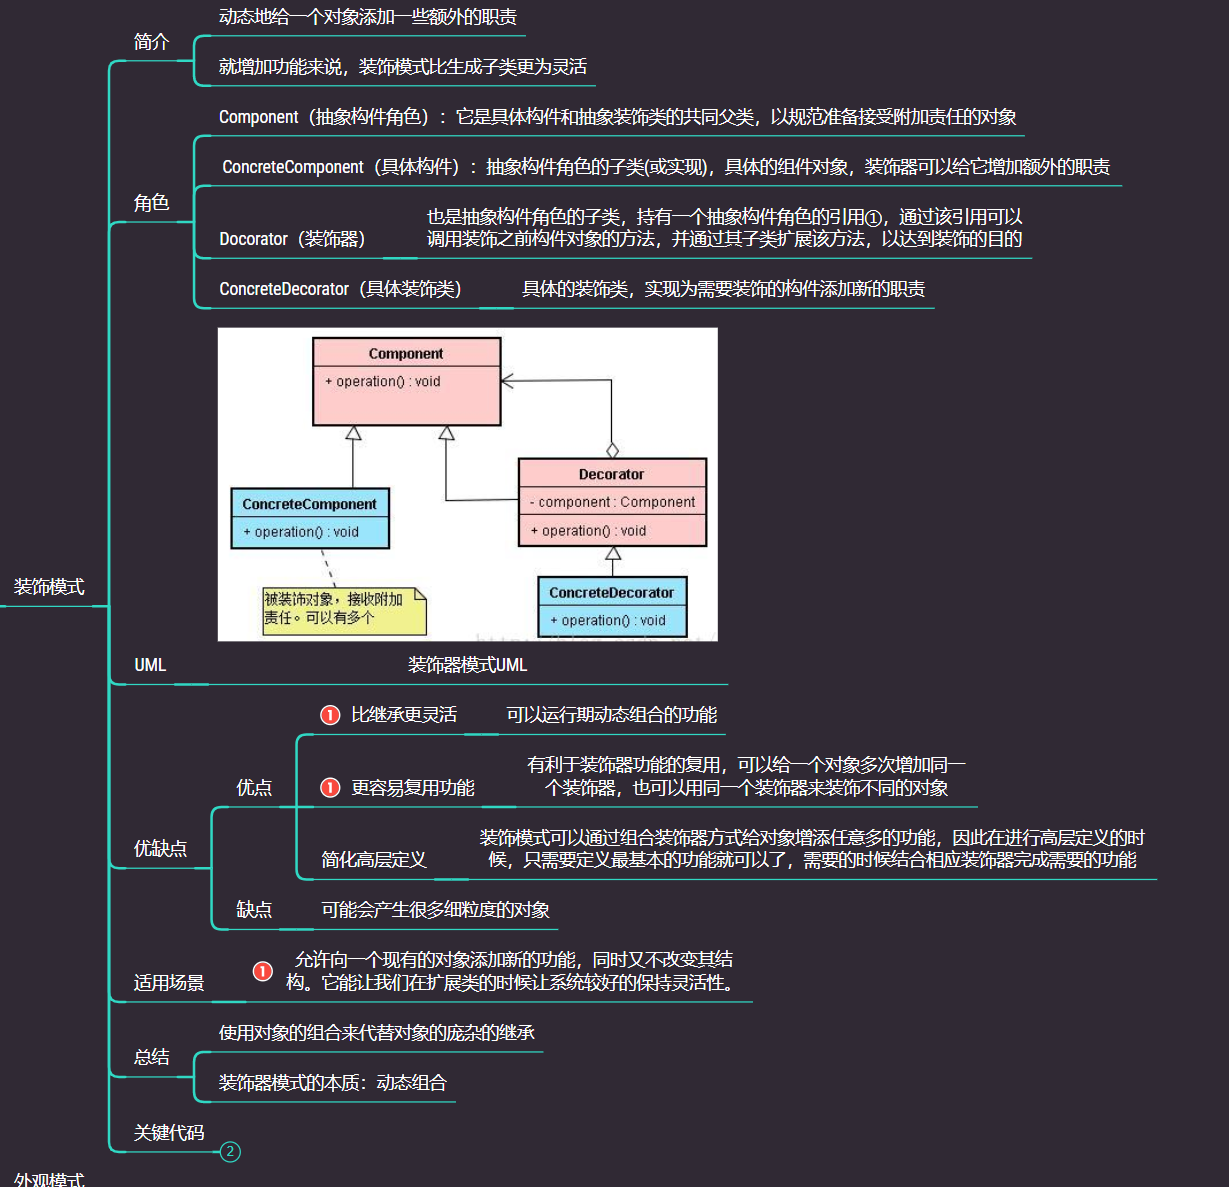
好好理解,多看几遍上面的代码,总结一下装饰器模式的几个角色
Component(抽象构件角色):它是具体构件和抽象装饰类的共同父类,以规范准备接受附加责任的对象(Beverage)
ConcreteComponent(具体构件):抽象构件角色的子类(或实现),具体的组件对象,装饰器可以给它增加额外的职责(decaf、Espresso、DrakRoast、HouseBlend)
Docorator(装饰器):也是抽象构件角色的子类,持有一个抽象构件角色的引用,通过该引用可以调用装饰之前构件对象的方法,并通过其子类扩展该方法,以达到装饰的目的(Condiment)
ConcreteDecorator(具体装饰类):具体的装饰类,实现为需要装饰的构件添加新的职责(Milk、Mocha)
记住关键步骤:
继承 + 依赖:继承需要装饰的类的父类,拥有共性;组合想要装饰的类,用于装饰(加强)
无限套娃:通过套娃,对需要装饰的类进行装饰、加强
小结一下装饰器模式的优缺点:
优点:
装饰类和被装饰类可以独立发展,不会相互耦合,装饰模式是继承的一个替代模式,装饰模式可以动态扩展一个实现类的功能
多层装饰比较复杂
3.1.2 jdk中的装饰器模式 jdk中用到了很多装饰器模式,例如流里面就有很多的装饰类,所以我们在学校Java流的时候一定会觉得为什么流这么多
我们随便写一段流的代码:
1 2 3 4 5 6 7 8 InputStream in = new FileInputStream ("xxx.txt" );BufferedInputStream bis = new BufferedInputStream (in);InputStreamReader inputStreamReader = new InputStreamReader (bis, StandardCharsets.UTF_8);inputStreamReader.close();
我们看其实流为了应对不同的场景,也是一层一层的包装下来的,我们看看继承结构
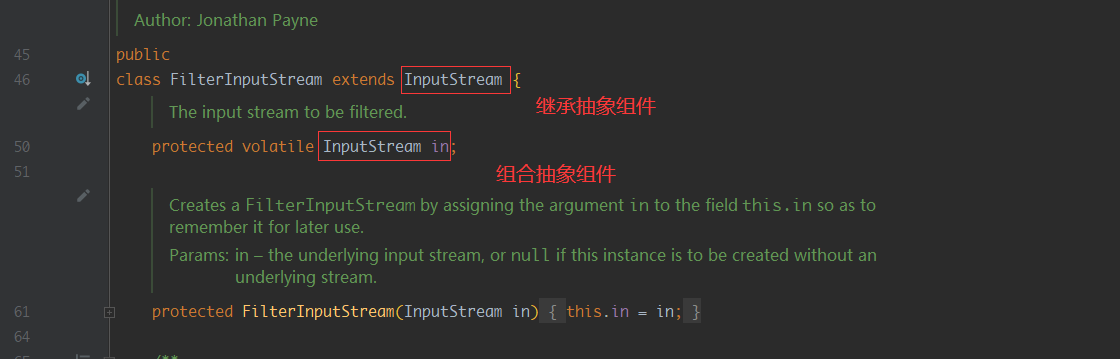
FilterInputStream,让本来没有联系的两个流FileInputStream与BufferedInputStream产生了关联,这种关联及时继承 + 关联/依赖,从而达到可以装饰(套娃)的效果,我们来看看FilterInputStream的源码
好好看你就会发现,作者又是写Stack的那个水货(无意冒犯🤣),好那么如果现在我也想写一个装饰类该怎么办呢,该继承谁呢?装饰类当然要继承装饰类(FilterInputStream),并组合想要装饰的类
其实Reader也有装饰类叫FilterReader,我们通过装饰器模式写一个BufferReader来自己实现一次读一行的能力
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
class MyBufferedReader extends Reader { private final Reader in; public MyBufferedReader (Reader in) { this .in = in; } public String readLine () throws IOException { StringBuilder sb = new StringBuilder (); while (true ) { int n = in.read(); if (n == '\n' ) { break ; } sb.append((char ) n); } return sb.toString(); } @Override public int read (char [] cbuf, int off, int len) throws IOException { return 0 ; } @Override public void close () throws IOException { in.close(); } } public class StreamTest { public static void main (String[] args) throws IOException { Reader fileReader = new FileReader ("F:\\1.txt" ); MyBufferedReader myBufferedReader = new MyBufferedReader (fileReader); String line = myBufferedReader.readLine(); System.out.println(line); String line2 = myBufferedReader.readLine(); System.out.println(line2); } }
可以看到我并没有改变原来的代码FileReader,但是在它的基础上添加了新的能力
3.1.3 装饰器模式总结 装饰器模式我们一定要记住:装饰器不但要继承需要装饰类的抽象类,还要关联它
3.2 适配器模式
适配器模式
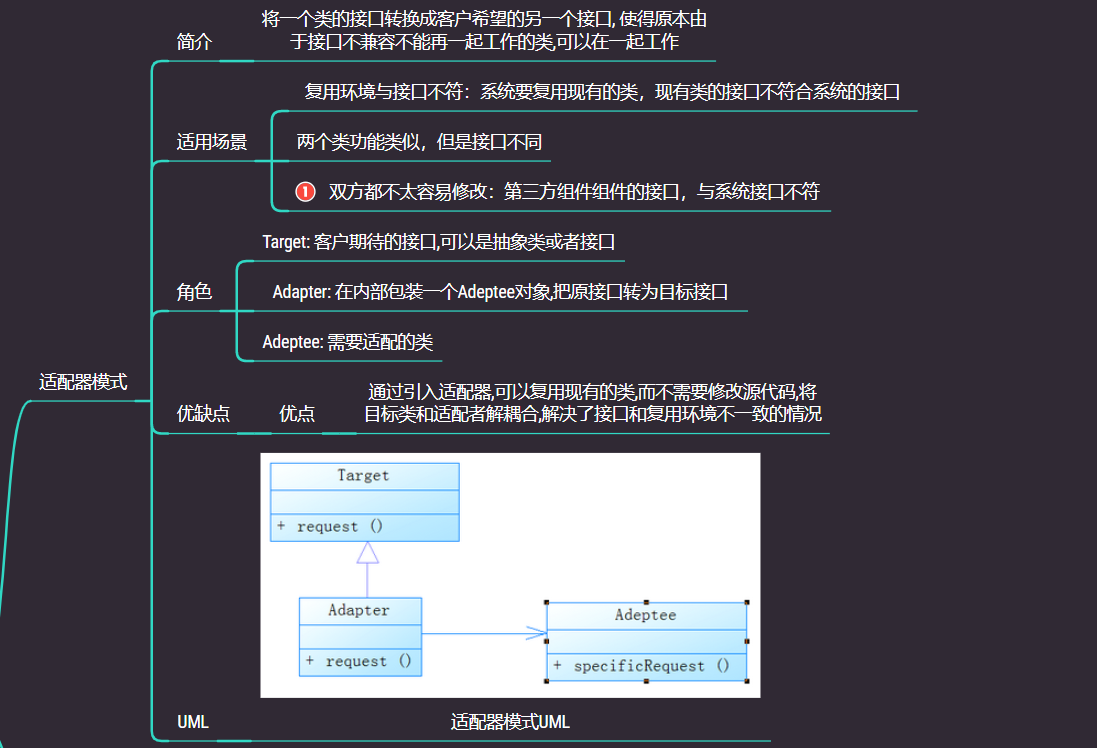
适配器模式(Adapter Pattern)是作为两个不兼容的接口之间的桥梁,将一个类的接口转换成客户希望的另一个接口, 使得原本由于接口不兼容不能再一起工作的类,可以在一起工作
主要分为三类:类适配器模式、对象适配器模式、接口适配器模式
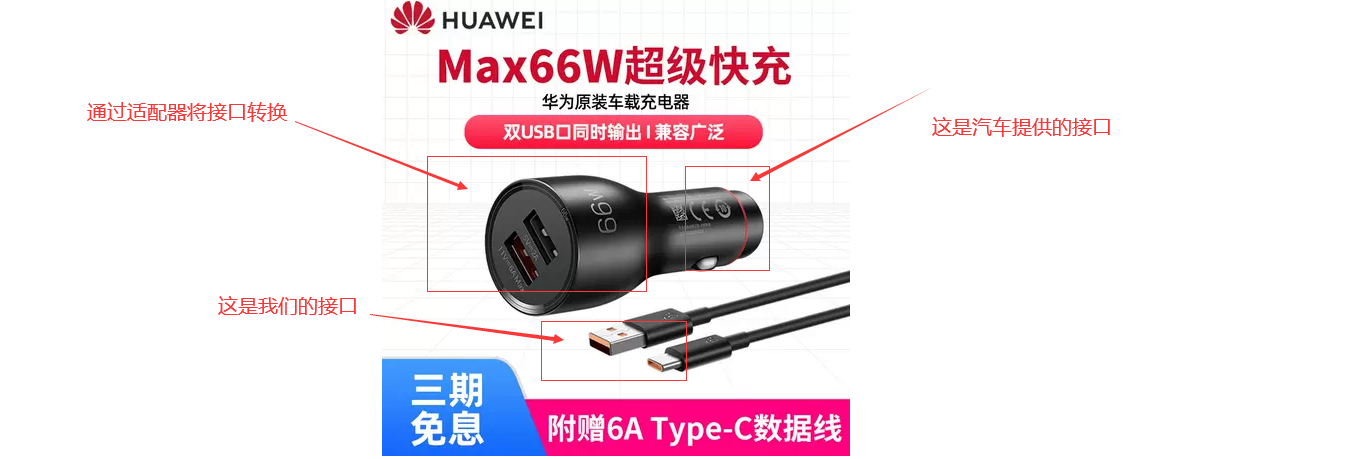
适配器我们在生活中经常使用,例如很多油车上面,没有给手机充电的usb口,我们只能去买一个车载充电器
那么代码中的适配器是什么样子的呢?假设我们这里现在有一段祖传的代码,能实现两数相加的功能
1
2
3
4
5
6
7
8
9
10
11
12
13
class Calc { public int add (int a, int b) { return a + b; } } public class AppTest { public static void main (String[] args) { Calc calc = new Calc (); System.out.println(calc.add(1 ,4 )); } }
现在变化来了,客户想要计算三个数的和?该怎么办呢?使用适配器模式我们直接
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
class CalcAdapter { private final Calc calc; public CalcAdapter (Calc calc) { this .calc = calc; } public int add (int a, int b, int c) { return calc.add(calc.add(a, b), c); } } public class AppTest { public static void main (String[] args) { CalcAdapter calcAdapter = new CalcAdapter (new Calc ()); System.out.println(calcAdapter.add(1 , 4 , 8 )); } }
好,适配器模式我们就讲完了
开玩笑开玩笑,上面的场景也太简单了,就算是不会设计模式的同学硬想也能想出来,我们看看生产中的适配器是如何操作的
3.2.1 jdk中的适配器模式 基础扎实的同学应该知道其实在java线程里面的Runnable和Callable两个接口也是通过适配转换的
我们随便写一段代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
public class ThreadTest { public static ExecutorService executorService = Executors.newFixedThreadPool(10 ); public static void main (String[] args) throws ExecutionException, InterruptedException { FutureTask<Class<?>> futureTask01 = new FutureTask <>(new Runnable () { @Override @SneakyThrows public void run () { System.out.println("线程池运行Runnable方式" ); Thread.sleep(3000 ); } }, String.class); executorService.submit(futureTask01); FutureTask<String> futureTask02 = new FutureTask <>(new Callable <String>() { @Override public String call () throws Exception { Thread.sleep(3000 ); System.out.println("线程池运行Callable方式" ); return "线程池运行Callable方式返回:" + Thread.currentThread().getName(); } }); executorService.submit(futureTask02); System.out.println(futureTask02.get()); } }
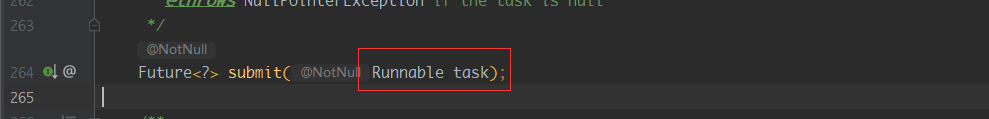
我们看到创建了两种不同类型的任务,一种是基于Runnable接口,是无返回值的任务;一种基于Callable接口,是有返回值类型的任务,但是,请看,居然都可以通过executorService#submit()方法提交到线程池中运行?难道这个方法是一个重载方法吗?
其实我们点进源码里面进行参看,发现居然是同一个方法
看来是FutureTask这个类搞得鬼,接下来我们看FutureTask类的两个构造器
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 public FutureTask (Callable<V> callable) { if (callable == null ) throw new NullPointerException (); this .callable = callable; this .state = NEW; } public FutureTask (Runnable runnable, V result) { this .callable = Executors.callable(runnable, result); this .state = NEW; }
我们看这一行代码Executors.callable(runnable, result),明明写的是Executors#callable,但是传进去的确是一个Runnable,有猫腻,我们进去看看
1
2
3
4
5
6
public static <T> Callable<T> callable (Runnable task, T result) { if (task == null ) throw new NullPointerException (); return new RunnableAdapter <T>(task, result); }
1 2 3 4 5 6 7 8 9 10 11 12 13 14 static final class RunnableAdapter <T> implements Callable <T> { final Runnable task; final T result; RunnableAdapter(Runnable task, T result) { this .task = task; this .result = result; } public T call () { task.run(); return result; } }
发现没有这个类,长得像什么,像适配器,首先它实现了Callable接口,又组合了Runnable接口,并且通过写了一个和Callable同名的call方法将Runnable#run
这是非常典型的适配模型,想要把 Runnable 适配成 Callable,首先要实现 Callable 的接口,接着在 Callable 的 call 方法里面调用被适配对象(Runnable)的方法
当然也可以将Callable适配成Runnable类,那为什么不呢?因为Callable可以提供更多的方法,例如获取返回值
可能有同学觉得,好像还是很简单,我只要记住适配器类继承要适配对象的抽象类,并组合适配对象就行了,这也不难嘛
确实关键点就是这两步,但是这种解耦、开闭的思想我们一定要融入平时的编码中,不要一上来就去改源代码
3.2.2 Spring中的适配器模式 鉴于有的读者可能觉得上面的栗子还是太简单的原因,这里来看一个稍微复杂一些的适配器模式
Spring中适配器运用的地方也有很多,这里分析两个
当SpringMVC处理请求到DispatcherServlet时,会通过HandlerAdapter处理器适配器调用具体的处理器
AOP中的AdvisorAdapter,它有三个实现AfterReturningAdviceAdapter 、ThrowsAdviceAdapter 、MethodBeforeAdviceAdapter
首先第一个SpringMVC中DispatcherServlet类下有一个获得处理器适配器的方法:
1
2
3
4
5
6
7
8
9
10
11
12
protected HandlerAdapter getHandlerAdapter (Object handler) throws ServletException { if (this .handlerAdapters != null ) { for (HandlerAdapter adapter : this .handlerAdapters) { if (adapter.supports(handler)) { return adapter; } } } throw new ServletException ("No adapter for handler [" + handler + "]: The DispatcherServlet configuration needs to include a HandlerAdapter that supports this handler" ); }
1
2
3
4
5
6
7
8
9
10
11
public interface HandlerAdapter { boolean supports (Object handler) ; @Nullable ModelAndView handle (HttpServletRequest request, HttpServletResponse response, Object handler) throws Exception; long getLastModified (HttpServletRequest request, Object handler) ; }
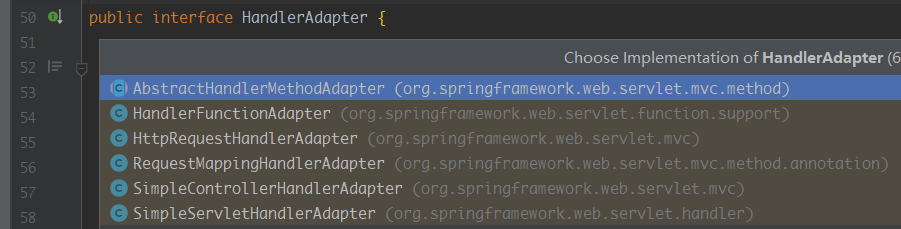
HandlerAdapter适配器的子类有:
Spring定义了一个适配接口,使得每一种Controller有一种对应的适配器实现类;
适配器代替 controller执行相应的方法;
扩展Controller时,只需要增加一个适配器类就完成了SpringMVC的扩展
接下来就是切面里的适配器了,我们知道在Spring AOP里面切面一共有五种增强(Advice),分别是:
前置通知(前置增强) - before() 执行方法前通知
返回通知(返回增强) - afterReturn 方法正常结束返回后的通知
异常抛出通知(异常抛出增强)一afetrThrow()
最终通知一after无论方法是否发生异常,均会执行该通知。
环绕通知——around包围一一个连接点(join point)的通知,如方法调用。这是最强大的一种通知类型。环绕通知可以在方法调用前后完成自定义的行为。它也会选择是否继续执行连接点或直接返回它们自己的返回值或
我们想想这些Advice难道全部是不一样的逻辑吗?其实不是,我们其实只需要写一个总的钩子函数,分别在上述的五个地方进行拦截,当预留五个适配器,分别调用总的钩子函数对应位置的逻辑即可,总的思想类似于线程池有七个参数,但是我们可以通过其内置函数调用少于七个参数的方法,间接调用最大的那个方法
这里不展开看源码了,我们看一看适配器的部分就行
1
2
3
4
5
6
7
public interface AdvisorAdapter { boolean supportsAdvice (Advice advice) ; MethodInterceptor getInterceptor (Advisor advisor) ; }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
class MethodBeforeAdviceAdapter implements AdvisorAdapter , Serializable { @Override public boolean supportsAdvice (Advice advice) { return (advice instanceof MethodBeforeAdvice); } @Override public MethodInterceptor getInterceptor (Advisor advisor) { MethodBeforeAdvice advice = (MethodBeforeAdvice) advisor.getAdvice(); return new MethodBeforeAdviceInterceptor (advice); } }
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class MethodBeforeAdviceInterceptor implements MethodInterceptor , Serializable { private MethodBeforeAdvice advice; public MethodBeforeAdviceInterceptor (MethodBeforeAdvice advice) { Assert.notNull(advice, "Advice must not be null" ); this .advice = advice; } @Override public Object invoke (MethodInvocation mi) throws Throwable { this .advice.before(mi.getMethod(), mi.getArguments(), mi.getThis() ); return mi.proceed(); } }
3.2.3 适配器模式总结
3.3 代理模式
代理模式
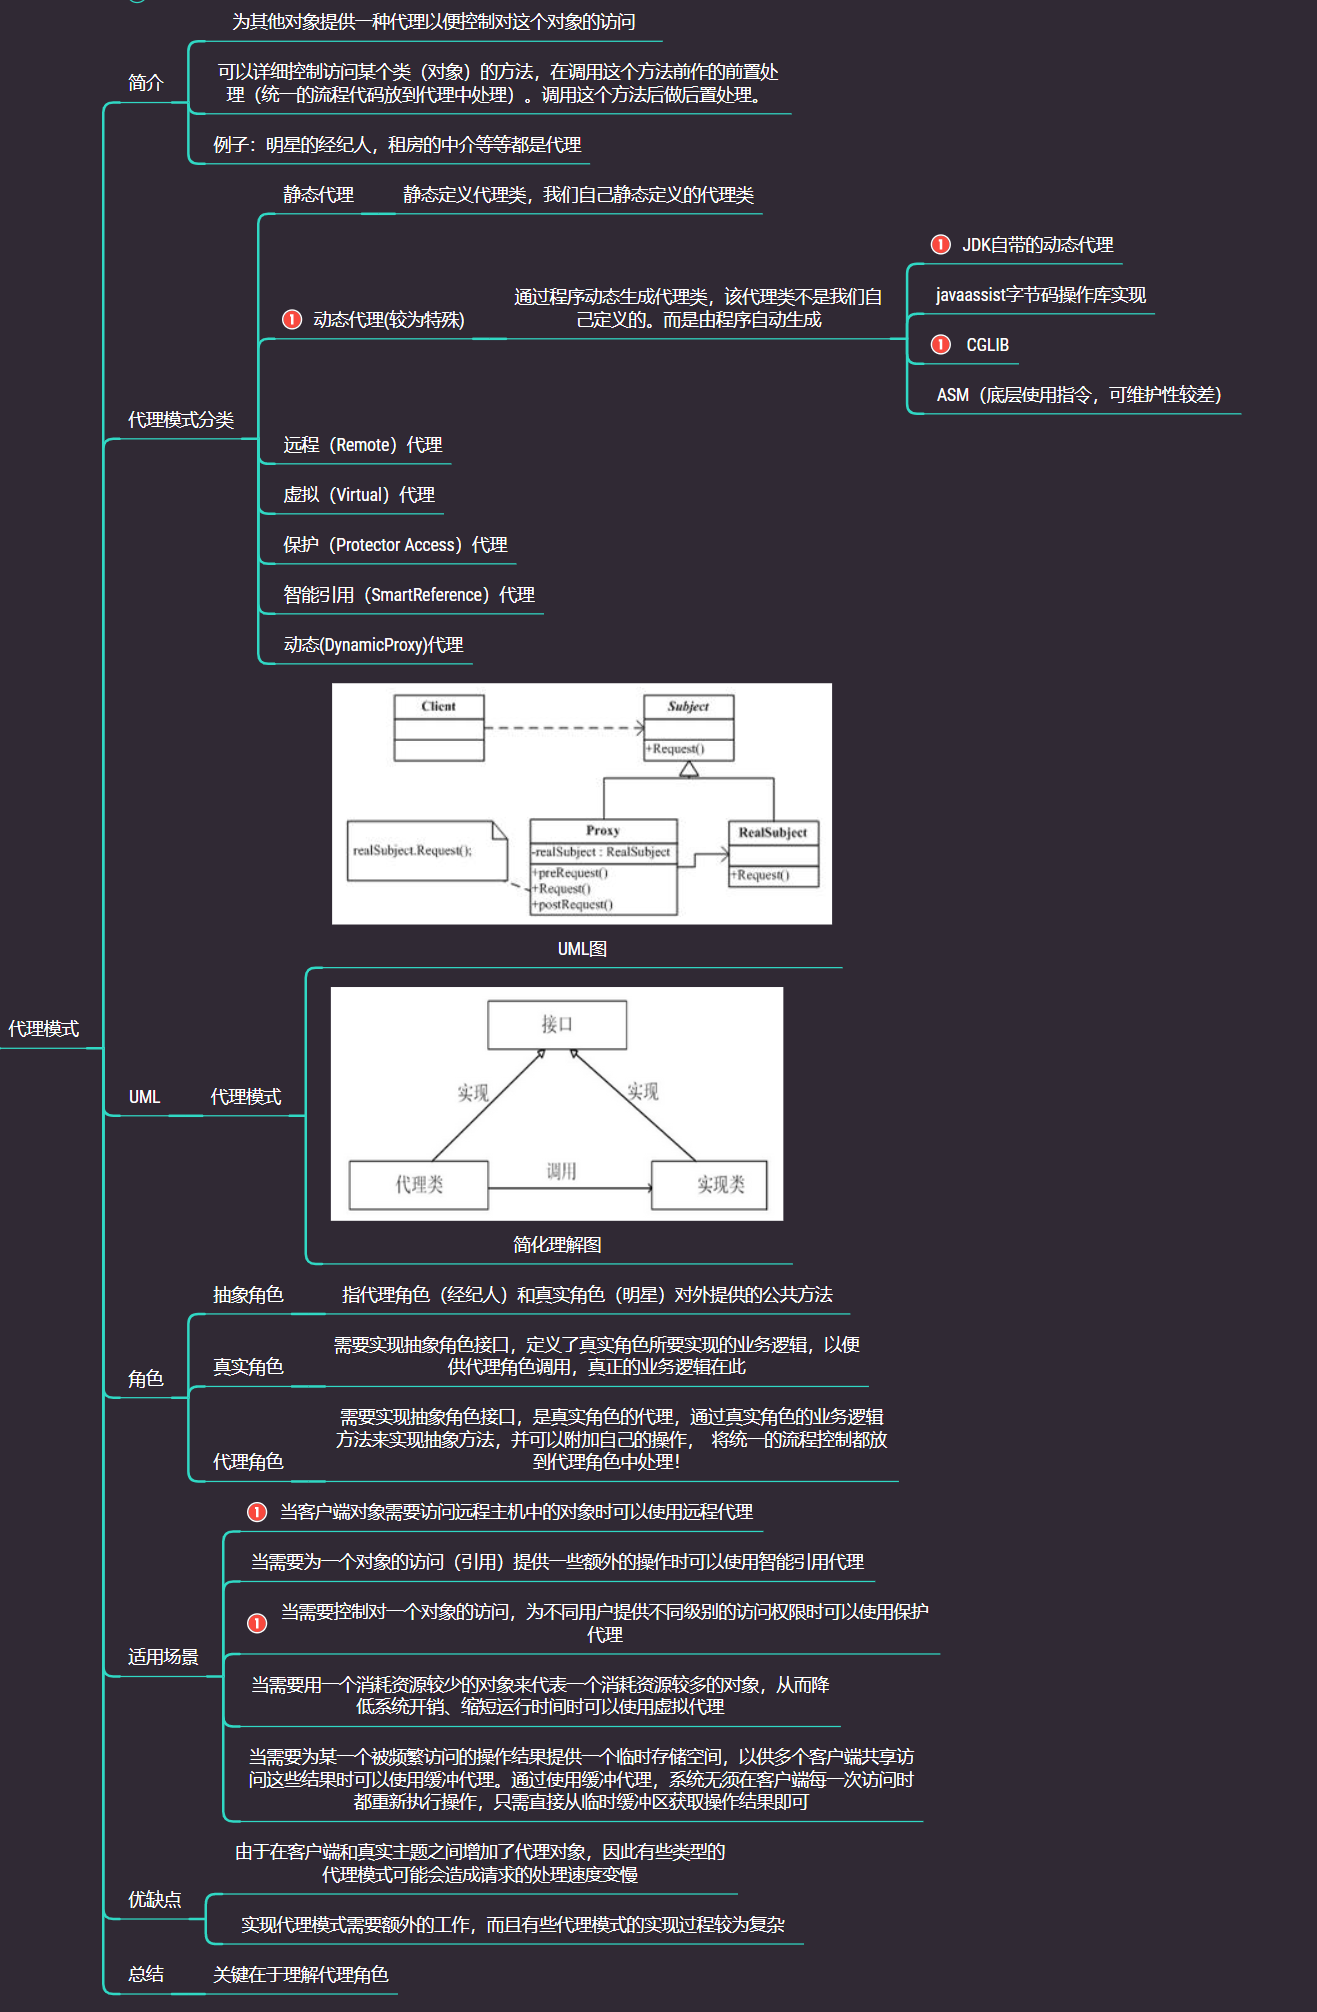
在代理模式(Proxy Pattern)中,一个类代表另一个类的功能。这种类型的设计模式属于结构型模式。
在代理模式中,我们创建具有现有对象的对象,以便向外界提供功能接口
代理模式真的用的太多了,我愿称之为框架中的模式NO1
3.3.1 问题引入 现在我们手上有一个计算器类,一共有四个方法:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
interface Calculate { int add (int x, int y) ; int reduce (int x, int y) ; int multiply (int x, int y) ; double divide (int x, int y) ; } class CalculateImpl implements Calculate { public int add (int x, int y) { return (x + y); } public int reduce (int x, int y) { return (x - y); } public int multiply (int x, int y) { return x * y; } @Override public double divide (int x, int y) { return x / y; } } public class AppTest { public static void main (String[] args) { Calculate calculate = new CalculateImpl (); System.out.println(calculate.add(1 , 4 )); System.out.println(calculate.reduce(1 , 4 )); System.out.println(calculate.multiply(1 , 4 )); System.out.println(calculate.divide(1 , 4 )); } }
假设我们现在想要统计这四个方法的耗时情况,该怎么做?
通过适配器模式装换接口,并在新的适配类中统一记录耗时情况
多写一些子类来完成
我只能说上面的方法也可以,但是不够优雅,这里才四个方法,如果有四千个呢?有的同学会问怎么可能有四千个方法,我只能说too young to simple,一个商业项目里面的接口有个小几万个太正常不过了,如果想对这些方法做增强,用我们之前学的所有设计模式都完不成,必须要用动态代理,物理上完不成,我们就得用魔法——动态代理 + 发射
3.3.2 jdk动态代理 我们先学一下jdk中动态代理的api,看如何使用动态代理,先别问为什么,先把api记住,我们可以通过Proxy类创建一个代理类
1 Proxy.newProxyInstance()
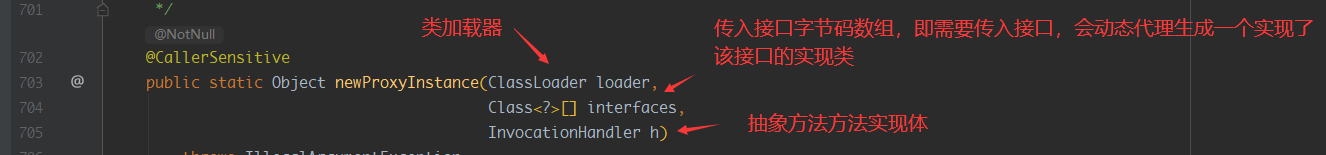
有三个参数,分别是:
类加载器:要创建一个类的实例(在类构造器被执行之前),需要通过类加载器将这个类的字节码文件加载到JVM中(也可以说是从磁盘加载到内存中)
传入要代理类的接口的字节码文件,因为可以通过传入不同的字节码生成不同的对象,所以称之为动态代理
我们传入的是接口的字节码文件,生成的代理类势必需要实现接口里面的方法,那么这些方法被实现的方法体具体是什么内容呢?这恰恰就是由第三个参数决定的
可能有点蒙,我们看下面具体的代码
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class MyHandle implements InvocationHandler { @Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable { System.out.println("呵呵哒" ); return 0 ; } } public class AppTest { public static void main (String[] args) { Class<?>[] interfaceClass = {ICalculate.class}; ICalculate proxy = (ICalculate) Proxy.newProxyInstance(AppTest.class.getClassLoader(), interfaceClass, new MyHandle ()); System.out.println(proxy.add(1 , 3 )); } }
我们现在来思考,这样创建的代理对象在执行proxy.add(1, 3)时,是会执行ICalculate接口里面的add方法吗?还是MyHandle#invoke方法,我们运行一下就可以知道,是执行MyHandle#invoke里面的方法
1 2 3 4 5 6 7 8 9 proxy.add(1 , 3 ); proxy.reduce(1 , 3 ); proxy.multiply(1 , 3 ); proxy.divide(1 , 3 ); 呵呵哒 呵呵哒 呵呵哒 呵呵哒
小结一下这个api的使用,Proxy#newProxyInstance()一共有三个参数,分别是类加载器,用来加载接口类的字节码;接口类数组的字节码,用来动态代理生成不同的对象;接口中方法的实现方法体,即执行代理类的方法时,会调用传入的InvocationHandler
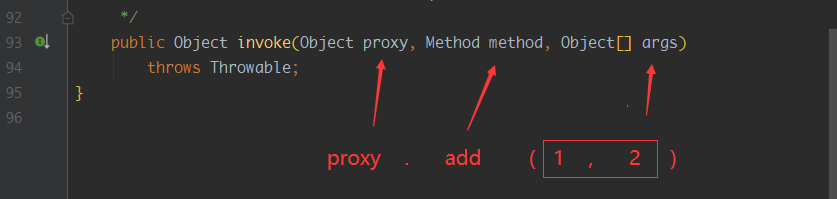
接下来我们看InvocationHandler的参数,这个参数就简单多了,例如我执行方法是proxy.add(1, 2),那么对应的就是:
证明一下:
1
2
3
4
5
6
7
8
9
10
@Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable { System.out.println(String.format("方法名为:%s,参数为:%s" , method.getName(), Arrays.toString(args))); return 0 ; } 方法名为:add,参数为:[1 , 3 ] 方法名为:reduce,参数为:[1 , 3 ] 方法名为:multiply,参数为:[1 , 3 ] 方法名为:divide,参数为:[1 , 3 ]
是不是感觉很简单!动态代理不过如此,我们可以通过反射调用方法,并且加入我们计算耗时的逻辑
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
class MyHandle implements InvocationHandler { private final Object target; public MyHandle (Object target) { this .target = target; } @Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable { System.out.println(String.format("方法名为:%s,参数为:%s" , method.getName(), Arrays.toString(args))); long start = System.currentTimeMillis(); Object result = method.invoke(target, args); System.out.println(String.format("耗时:%s ms" , System.currentTimeMillis() - start)); return result; } } public class AppTest { public static void main (String[] args) { ICalculate iCalculate = new CalculateImpl (); Class<?>[] interfaceClass = {ICalculate.class}; ICalculate proxy = (ICalculate) Proxy.newProxyInstance(AppTest.class.getClassLoader(), interfaceClass, new MyHandle (iCalculate)); System.out.println(proxy.add(1 , 3 )); System.out.println(proxy.reduce(1 , 3 )); System.out.println(proxy.multiply(1 , 3 )); System.out.println(proxy.divide(1 , 3 )); } }
输出:
1 2 3 4 5 6 7 8 9 10 11 12 方法名为:add,参数为:[1 , 3 ] 耗时:0 ms 4 方法名为:reduce,参数为:[1 , 3 ] 耗时:0 ms -2 方法名为:multiply,参数为:[1 , 3 ] 耗时:0 ms 3 方法名为:divide,参数为:[1 , 3 ] 耗时:0 ms 0.0
好代理模式讲完了
怎么可能,就学了一个api就完了???这搞得比工厂模式还简单了。当然不是,这才学了一个API,这都还没到模式的这一步,这才哪到哪,六分之一的内容都还没到
我们来想想这样的缺点是什么?
太复杂了,有的用户不会使用动态代理
代码耦合了,每次需要去修改代理类里面的处理逻辑
那我们再封装封装,让用户开箱即用
3.3.3 封装jdk动态代理帮助类 我们来封装封装上面的代码
我们定义一个接口,用来描述代理类对应方法执行前后需要拓展执行的方法,其实这种接口我们喜欢将其称之为:切面,也可以定义为Interceptor拦截器
1
2
3
4
5
interface Aspect { void before (Object target, Method method, Object[] args) ; void after (Object target, Method method, Object[] args, Object returnVal) ; }
在我们的handle上添加切面
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
class MyHandle implements InvocationHandler { private final Object target; private final Aspect aspect; public MyHandle (Object target, Aspect aspect) { this .target = target; this .aspect = aspect; } @Override public Object invoke (Object proxy, Method method, Object[] args) throws Throwable { aspect.before(target, method, args); Object result = method.invoke(target, args); aspect.after(target, method, args, result); return result; } }
代理类:
1
2
3
4
5
6
7
class MyProxy { public static Object getProxy (Object cls, Aspect aspect) { Class<?>[] interfaceClass = cls.getClass().getInterfaces(); return Proxy.newProxyInstance(cls.getClass().getClassLoader(), interfaceClass, new MyHandle (cls, aspect)); } }
使用:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
public class AppTest { public static void main (String[] args) { ICalculate iCalculate = new CalculateImpl (); ICalculate proxy = (ICalculate) MyProxy.getProxy(iCalculate, new Aspect () { @Override public void before (Object target, Method method, Object[] args) { System.out.println(String.format("方法名为:%s,参数为:%s" , method.getName(), Arrays.toString(args))); } @Override public void after (Object target, Method method, Object[] args, Object returnVal) { System.out.println(String.format("返回结果为:%s" , returnVal.toString())); } }); System.out.println(proxy.add(1 , 3 )); System.out.println(proxy.reduce(1 , 3 )); System.out.println(proxy.multiply(1 , 3 )); System.out.println(proxy.divide(1 , 3 )); } } 方法名为:add,参数为:[1 , 3 ] 返回结果为:4 4 方法名为:reduce,参数为:[1 , 3 ] 返回结果为:-2 -2 方法名为:multiply,参数为:[1 , 3 ] 返回结果为:3 3 方法名为:divide,参数为:[1 , 3 ] 返回结果为:0.0 0.0
可以看到这样就简单了很多,应对不同的需求我们就去定制不同的代理类和切面类,实现不同的需求。有兴趣的同学可以去看hutool工具包下面封装的代理工具类,那个工具类封装更多的方法,而且中文注释,挺好理解的
好代理模式讲完了(梅开二度😜),上面只是简单的封装,其实还没有到代理模式的核心,我们来看看上面代理模式的缺点:
首先jdk动态代理基于接口,如果想要代理的对象没有并没有实现接口,就无法代理
你会发现,代理类的所有方法都被加强了,也就是说任何一个方法执行都会调用Aspect里面的逻辑,没有选择的余地了
首先第二个问题,读者可以将MyHandle也单独拆出来,如果只想要执行一个或多个方法,通过打标记的方式,例如传入add方法后拿着执行方法比较一下,再执行,或者使用适配器模式做适配类,再或者在Aspect里面做判断,这些都比较简单,这里不演示了,需要注意的是:
一般框架中切面都是将职责进行细分了的,并用集合存起来,实现某个接口就能拿到这个集合,再将自己的切面或者说拦截器放进去,就能执行响应的功能
但是其实无论怎么做,还是会依赖于具体类里面具体的方法,还不是不够理想,读者写别急,解决方案其实是SpringAOP里面的Spring动态代理,通过用注解给需要执行的方法做标记的方式执行代理,有点类似于简单工厂中Spring解决的问题
我们来看第一个问题如何解决
3.3.4 Cglib动态代理 其实没有实现接口就无法代理的问题,也是jdk动态代理的问题,解决方法就是换成cglib动态代理,cglib是基于类的动态代理,它的原理是对指定的目标类生成一个子类, 并覆盖其中方法实现增强,但因为采用的是继承,所 以不能对final修饰的类进行代理。
在pom.xml文件中引入cglib的相关依赖
1
2
3
4
5
6
7
<!-- https: <dependency> <groupId>cglib</groupId> <artifactId>cglib</artifactId> <version>2.2 .2 </version> </dependency>
定义类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
public class CglibInterceptor implements MethodInterceptor { private Object target; public CglibInterceptor (Object target) { this .target = target; } public Object getProxy () { Enhancer enhancer=new Enhancer (); enhancer.setSuperclass(target.getClass()); enhancer.setCallback(this ); return enhancer.create(); } @Override public Object intercept (Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable { System.out.println("intercept方法执行前的增强行为" ); Object object = methodProxy.invoke(target, objects); System.out.println("intercept方法执行后的增强行为" ); return object; } }
可以看到其实都只是API的调用,多看几遍就能够理解清楚
3.3.5 JDK动态代理和CGLIB代理的区别
JDK动态代理实现接口,Cglib动态代理继承思想 JDK动态代理( 目标对象存在接口时)执行效率高于Ciglib
如果目标对象有接口实现,选择JDK代理, 如果没有接口实现选择Cglib代理
最优选择:如果目标对象存在接口实现,优先选择JDK动态代理,反之这选择cglib动态代理
3.3.6 Spring中的代理模式 TODO
3.3.7 Dubbo中的代理模式 TODO
3.3.8 代理模式总结
3.4 桥接模式
桥接模式
桥接(Bridge)是用于把抽象化与实现化解耦,使得二者可以独立变化。这种类型的设计模式属于结构型模式,它通过提供抽象化和实现化之间的桥接结构,来实现二者的解耦。
4. 行为型模式
行为型模式
4.1 策略模式
策略模式
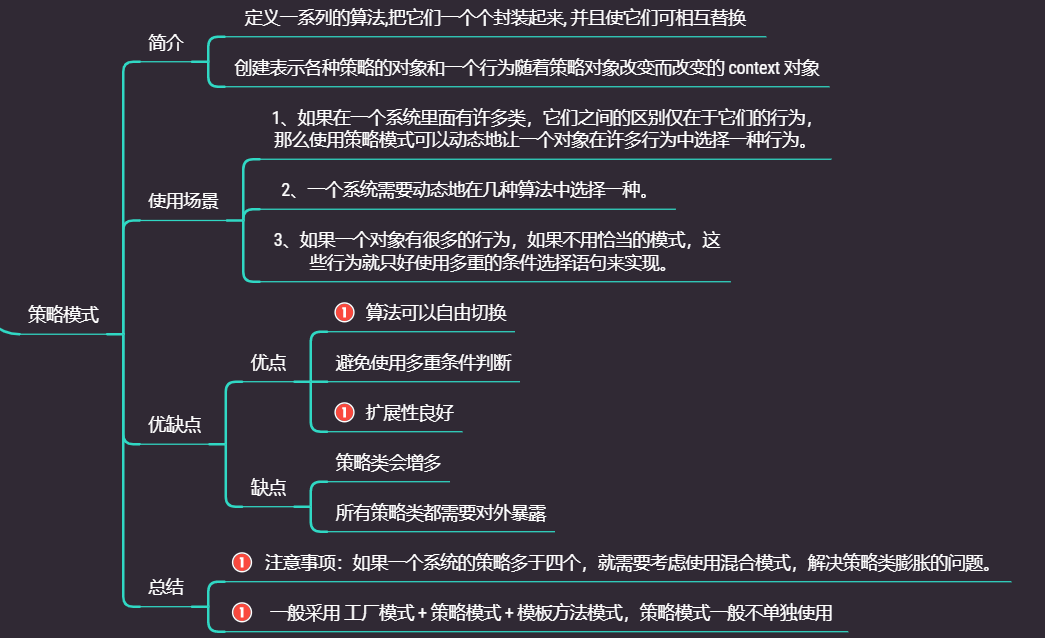
策略模式(Strategy Pattern)中,定义算法族,分别封装起来,让他们之间可以互相替换,此模式让算法的变化独立于使用算法的客户
4.1.1 问题引入 现在我们有一个Duck抽象类,它有四个方法:
1
2
3
4
5
6
7
8
9
10
11
12
13
public abstract void display () ; public void quack () { System.out.println("鸭子嘎嘎叫~~" ); } public void swim () { System.out.println("鸭子会游泳~~" ); } public void fly () { System.out.println("鸭子会飞翔~~" ); }
现在我们给其添加三个子类
WildDuck 野鸭
PekingDuck 北京鸭
ToyDuck 玩具鸭
现在问题产生了:
野鸭不需要重写父类的方法
北京鸭需要重写父类的fly方法,因为北京鸭不会飞
ToyDuck需要重写父类的所有方法,这跟我们想要通过继承来复用代码的想法背道相驰
问题总结:由于继承带来的问题,对类的局部改动,尤其是超类的改动,会影响其他部分。会有溢出效应
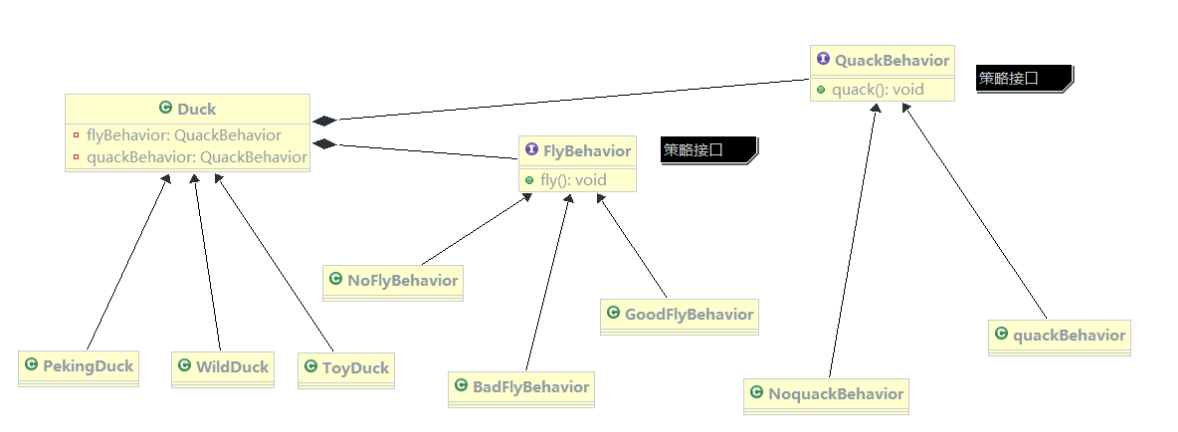
4.1.2 策略模式解决问题的核心 通过将继承改成组合+聚和的方式,来减少溢出效应
把变化的代码从不变的代码中分离出来
针对接口编程而不是具体类(定义策略接口)
多用组合/聚和,少用继承(客户通过组合方式使用策略)
4.1.3 策略模式原理 从下面的类图可以看到,客户context有成员便令strategy或者其他的策略接口,至于需要使用到哪个策略,我们可以在构造器中指定
栗子代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
public abstract class Duck { FlyBehavior flyBehavior; public Duck () { } public void setFlyBehavior (FlyBehavior flyBehavior) { this .flyBehavior = flyBehavior; } public abstract void display () ; public void quack () { System.out.println("鸭子嘎嘎叫~~" ); } public void swim () { System.out.println("鸭子会游泳~~" ); } public void fly () { if (flyBehavior != null ) { flyBehavior.fly(); } }
1
2
3
4
5
6
7
8
9
10
11
12
public class PekingDuck extends Duck { public PekingDuck () { flyBehavior = new NoFlyBehavior (); } @Override public void display () { System.out.println("北京鸭~~" ); } }
测试类:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
public class Client { public static void main (String[] args) { new WildDuck ().fly(); PekingDuck pekingDuck = new PekingDuck (); pekingDuck.fly(); pekingDuck.setFlyBehavior(new BadFlyBehavior ()); pekingDuck.fly(); new ToyDuck ().fly(); } } 打印结果: 飞翔技术很好 不能飞翔 飞翔技术不好 不能飞翔
4.1.4 策略模式在JDK中的应用
JDK的Arrays的Comparator就使用了策略模式
代码分析+Debug源码+模式角色分析
在JDK中的Comparator中运用到了策略接口(策略模式)
1
2
3
4
5
6
7
8
9
10
11
12
Integer[] data={9 ,1 ,2 ,8 ,4 ,3 }; Comparator<Integer> comparator= (o1, o2) -> { if (o1 > o2) { return 1 ; }else if (o1 < o2){ return -1 ; }else { return 0 ; } };
4.1.5 策略模式总结
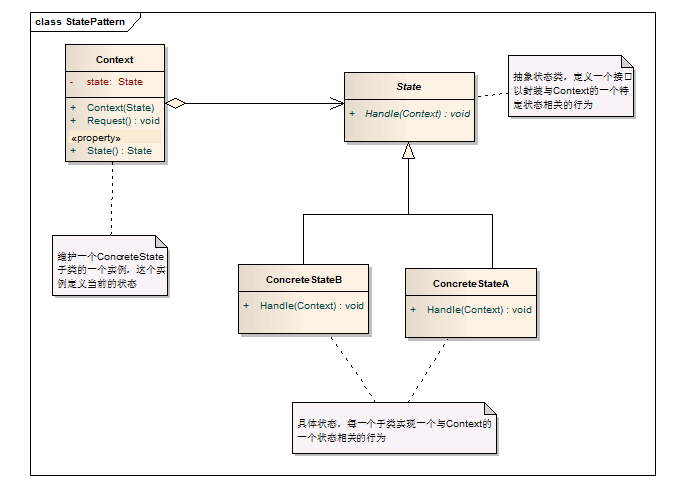
在状态模式(State Pattern)中,类的行为是基于它的状态改变的。这种类型的设计模式属于行为型模式。
在状态模式中,我们创建表示各种状态的对象和一个行为随着状态对象改变而改变的 context 对象。
4.2 观察者模式
观察者模式
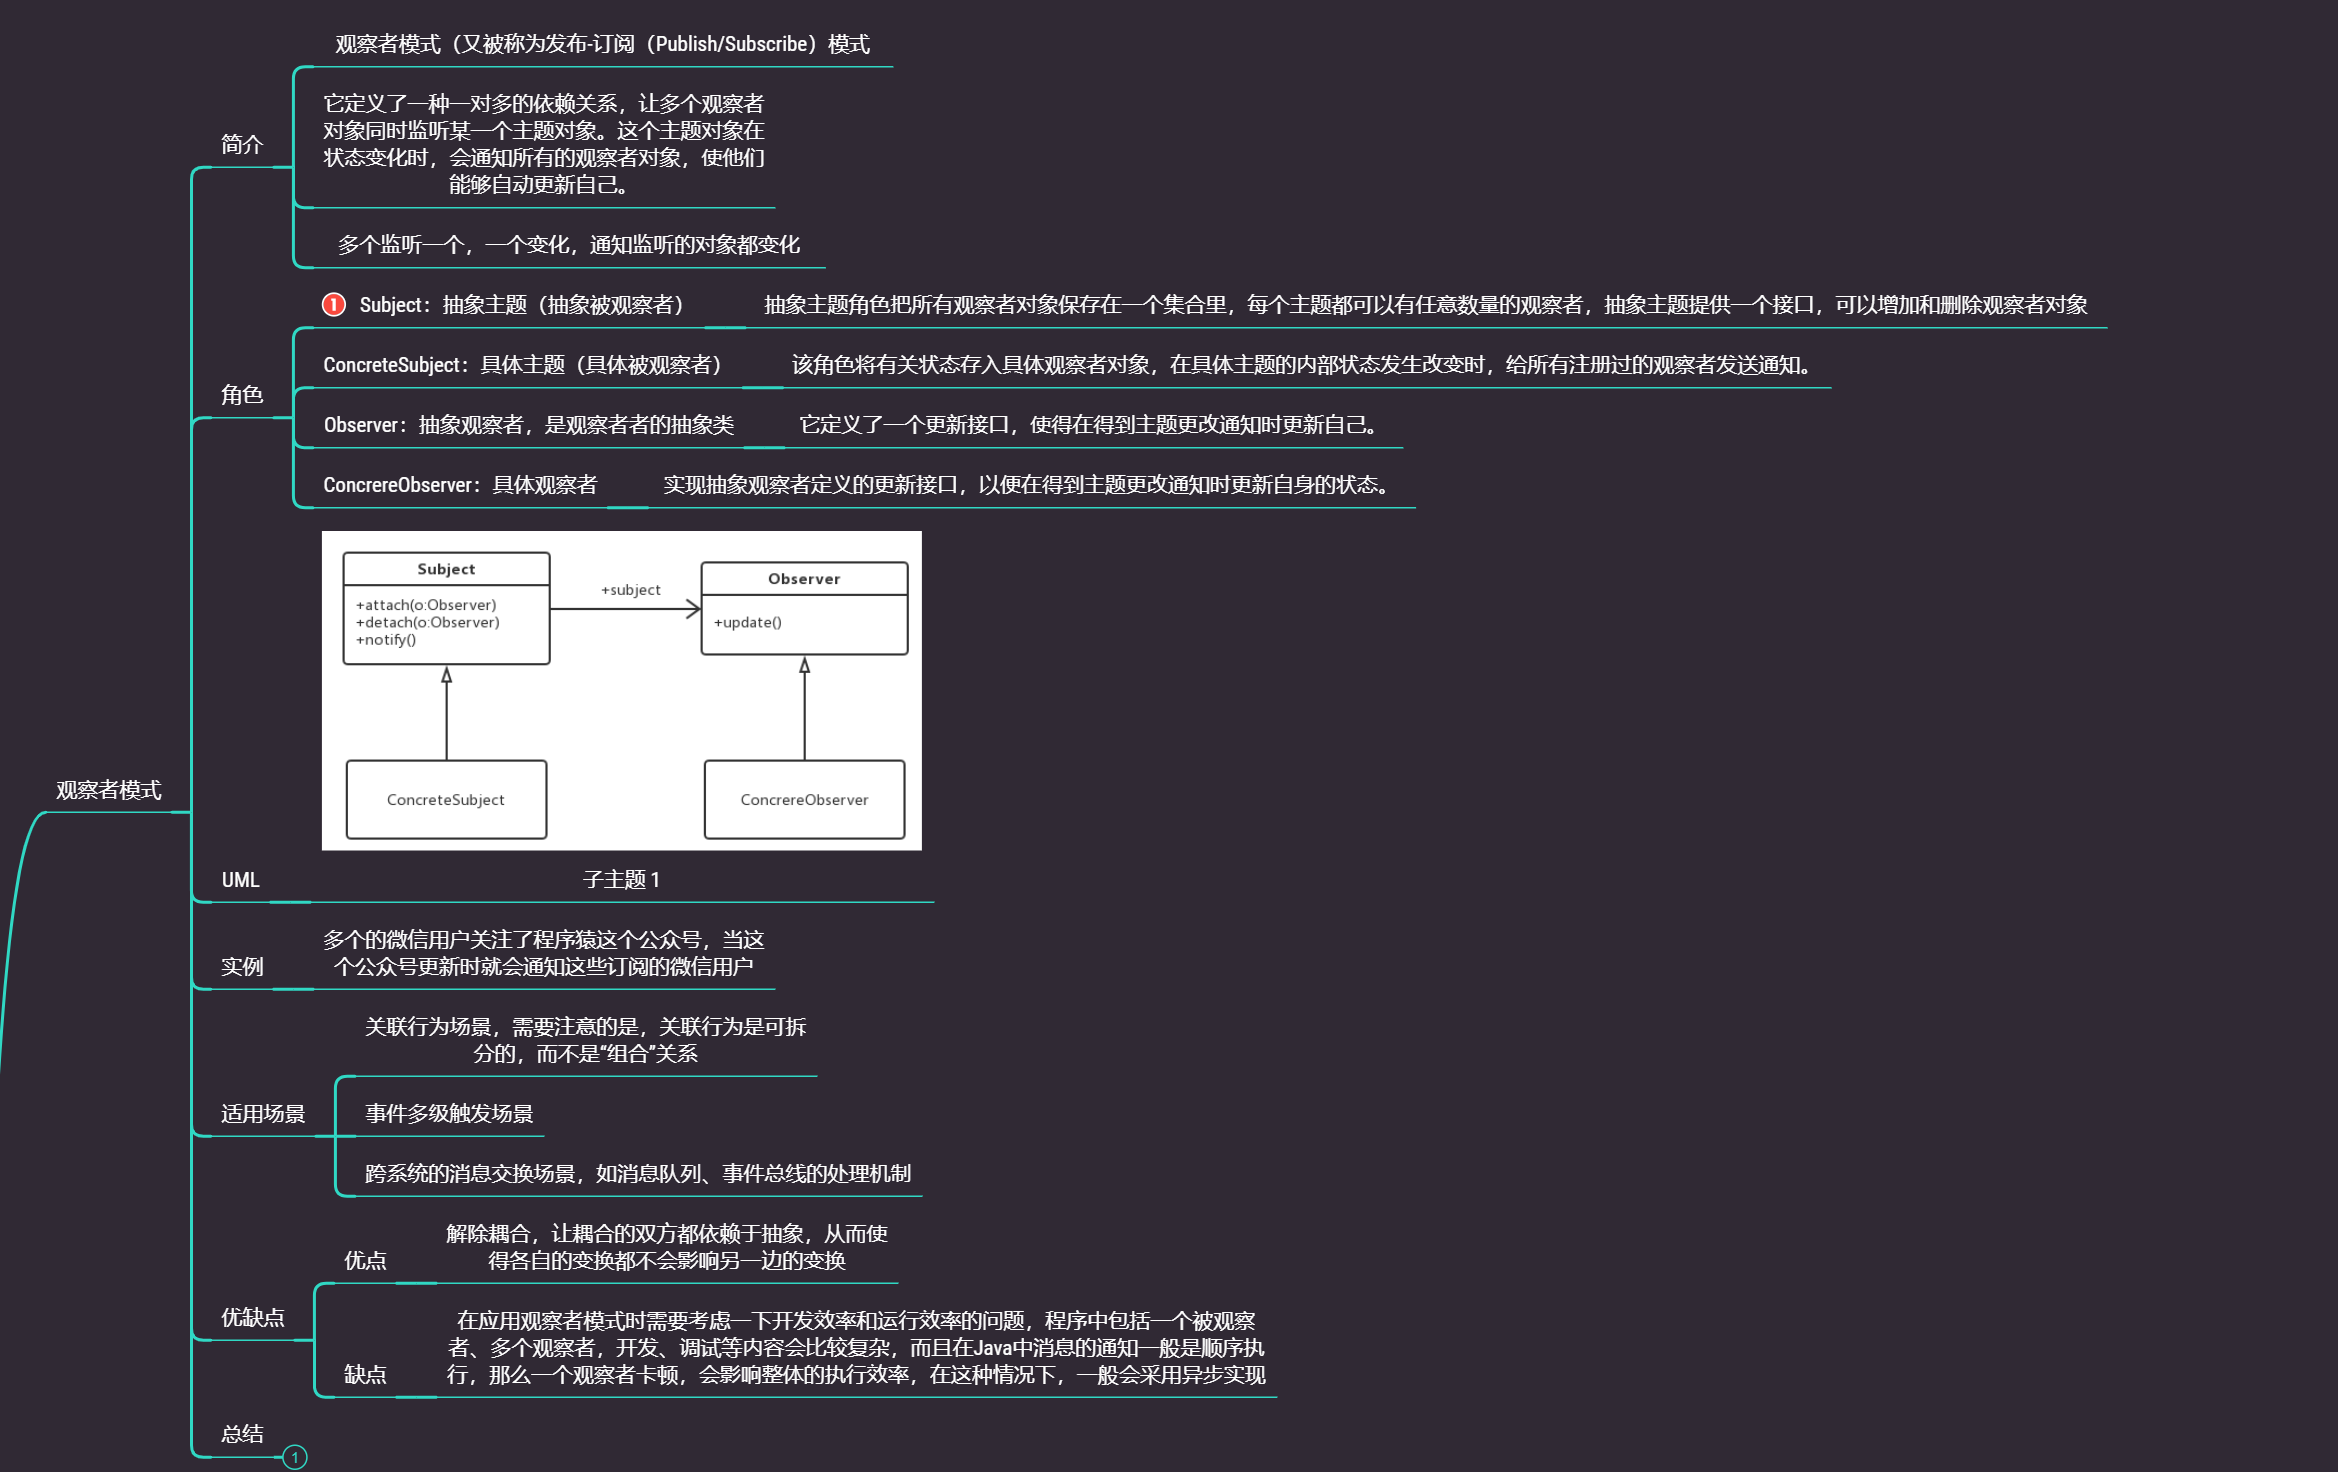
观察者模式又被称为发布-订阅(Publish/Subscribe),当对象间存在一对多关系时,则使用观察者模式(Observer Pattern)。比如,当一个对象被修改时,则会自动通知依赖它的对象。观察者模式属于行为型模式。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
package com.fx.behaviorPattern.observer.d;import lombok.Data;import java.util.ArrayList;import java.util.List;public class Test { public static void main (String[] args) { Role role = new Role (); role.setName("角色" ); role.setHp(100 ); Panel panel = new Panel (role); role.addObserver(panel); BallPanel ballPanel = new BallPanel (role); role.addObserver(ballPanel); HeadPanel headPanel = new HeadPanel (role); role.addObserver(headPanel); Monster monster = new Monster (); monster.attack(role); monster.attack(role); monster.attack(role); } } @Data class Role { private String name; private int hp; private int mp; private List<Observer> observers = new ArrayList <>(); public void addObserver (Observer obj) { observers.add(obj); } public void removeObserver (Observer obj) { observers.remove(obj); } public void notifyObservers () { observers.forEach(Observer::notifyObserver); } public void setHp (int hp) { this .hp = hp; System.out.println("血条更新为:" + hp); System.out.println("球形更新为:" + hp); System.out.println("面板更新为:" + hp); } @Override public String toString () { return "Role{" + "name='" + name + '\'' + ", hp=" + hp + ", mp=" + mp + '}' ; } } class Monster { public void attack (Role r) { r.setHp(r.getHp() - 10 ); r.notifyObservers(); } } interface Observer { void notifyObserver () ; } class Panel implements Observer { private final Role r; public Panel (Role r) { this .r = r; } @Override public void notifyObserver () { System.out.printf("Panel 更新血条了值为:%d\n" , r.getHp()); } } class BallPanel implements Observer { private final Role r; public BallPanel (Role r) { this .r = r; } @Override public void notifyObserver () { System.out.printf("Panel 更新血条了值为:%d\n" , r.getHp()); } } class HeadPanel implements Observer { private final Role r; public HeadPanel (Role r) { this .r = r; } @Override public void notifyObserver () { System.out.printf("Panel 更新血条了值为:%d\n" , r.getHp()); } }
4.2.3 观察者模式总结
4.3 访问者模式
访问者(Visitor)模式 :封装一些作用于某种数据结构中的各元素的操作,它可以在不改变这个数据结构的前提下定义作用于这些元素的新的操作
🧨访问者模式的本质是想实现多重派发 (multiple dispatch),由于Java中只有函数参数重载实现的单派发(single dispatch),所以需要这个模式去模拟,如果用支持多派发的语言如clojue或者common lisp、js,就不需要访问者模式了,在golang中也可以通过接口和类型断言来模拟实现多派发。
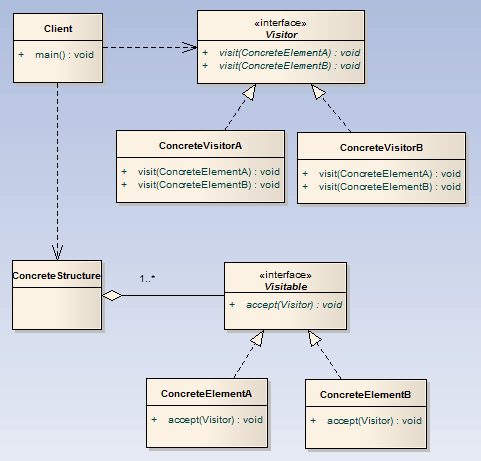
抽象访问者(Visitor)角色 :定义接口,声明一个或多个访问操作。具体访问者(ConcreteVisitor)角色 :实现抽象访问者所声明的接口,也就是抽象访问者所声明的各个访问操作。抽象元素(Visitable)角色 :声明一个接受操作,接受一个访问者对象作为一个参数。具体元素结点(ConcreteElement)角色 :实现抽象结点所规定的接受操作。数据结构对象(ObjectStructure)角色 :可以遍历结构中的所有元素,提供一个接口让访问者对象都可以访问每一个元素。
下面用一个经典的墨子骑马🏇的故事来描述java遇到的多派发的问题
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
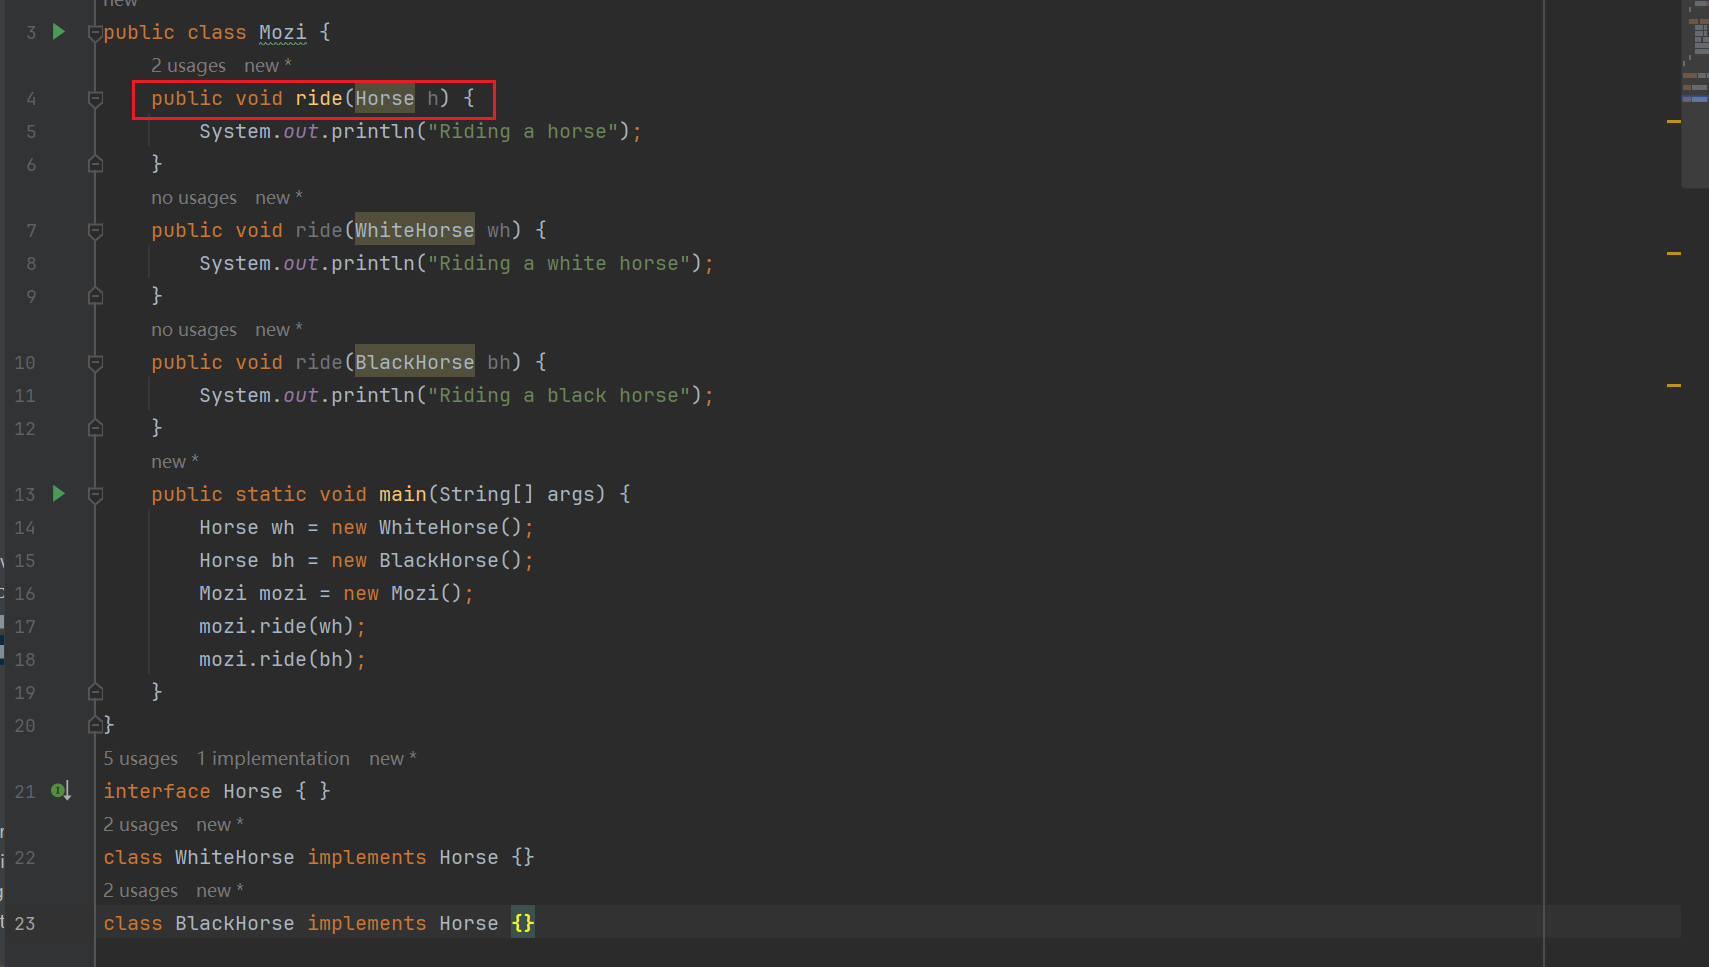
public class Mozi { public void ride (Horse h) { System.out.println("Riding a horse" ); } public void ride (WhiteHorse wh) { System.out.println("Riding a white horse" ); } public void ride (BlackHorse bh) { System.out.println("Riding a black horse" ); } public static void main (String[] args) { Horse wh = new WhiteHorse (); Horse bh = new BlackHorse (); Mozi mozi = new Mozi (); mozi.ride(wh); mozi.ride(bh); } } interface Horse { }class WhiteHorse implements Horse {}class BlackHorse implements Horse {}
运行后输出两次Riding a horse
明显只有第一个方法被调用到了
我们来思考一下问题出在那里,并且想想实际工作中什么场景会遇到这样的问题
问题很明显,我们使用了多态,虽然具有不同的真实类型,但是它们的静态类型都是一样的,均是Horse类型,并且重载方法的分派是根据静态类型进行 的。这个分派过程在编译时期 就完成了
现在让我们来完善一些概念🎃
变量被声明时的类型叫做变量的静态类型(Static Type) 又叫明显类型(Apparent Type)
变量所引用的对象的真实类型又叫做变量的实际类型(Actual Type)
上面例子中Horse就是静态类型,编译期就确认了;那两匹🐎就是实际类型
根据对象的类型而对方法进行的选择,就是分派(Dispatch)。根据分派发生的时期,可以将分派分为两种,即静态分派和动态分派
静态分派(Static Dispatch) 发生在编译时期,分派根据静态类型信息发生。方法重载(Overload)就是静态分派。(所谓的:编译时多态)
动态分派(Dynamic Dispatch) 发生在运行时期,动态分派动态地置换掉某个方法。面向对象的语言利用动态分派来实现方法置换产生的多态性。(所谓的:运行时多态)
我们上面墨子骑马🏇的例子其实就是java使用方法重载的方式来支持静态分派
当然java也支持动态分派 ,在java中通过方法的置换(Overriding)支持动态分派,举个例子
1 2 3 4 >String s1 = "ab" ; >Object o = s1 +"c" ; >String s = "abc" ; >boolean b = o.equals(s);
上面的代码输出为true,让我们分析一下,其实调用 o.equals的时候,o的类型是Object,按道理调用的应该是Object.equals,我们都知道比较的是内存地址,肯定和s的地址不一样(别给我扯什么串池复用对象啥的,可以看字节码,这里不是一个对象),但是这里返回true了,是因为调用的其实不是Object.equals,而是String.equals,这样是java中所谓的通过Overriding实现的动态分发
分派的类型
一个方法所属的对象叫做方法的接收者,方法的接收者与方法的参量统称做方法的宗量。根据分派可以基于多少种宗量,可以将面向对象的语言划分为单分派语言和多分派语言
单元分派语言根据一个宗量的类型(真实类型)进行对方法的选择(C++、Java以及Smaltalk)
多分派语言根据多于一个的宗量的类型对方法进行选择(CLOS和Cecil)
通过上面的例子我们可以看出:
C++和Java就是动态的单分派语言,因为这两种语言的动态分派仅仅会考虑到方法的接收者的类型 ,同时又是静态的多分派语言,因为这两种语言对重载方法的分派 会考虑到方法的接收者的类型和方法所有参量的类型。
在一个支持动态单分派的语言里面,有两个条件决定了一个请求会调用哪一个操作:一是请求的名字 ,二是接收者的真实类型 。单分派限制了方法的选择过程,使得只有一个宗量可以被考虑到,这个宗量通常就是方法的接收者。在JAVA语言里面,如果一个操作是作用于某个类型不明的对象上面的。那么这个对象的真实类型测试仅会发生一次。这个就是动态的单分派的特征。
一言以蔽之,JAVA语言支持静态的多分派和动态的单分派
回到之前出现的问题上,如果一个方法根据两个宗量的类型来决定执行不同的代码,这就是“双分派”或者“多重分派”。Java不支持动态的多分派。但可以通过使用设计模式,在Java语言里面实现动态的双重分派(ps:就是伪双重分派 是由两次的单分派组成)。
如果解决呢?一般有两种做法
4.3.1 类型判断解决多派分发问题 在方法里使用instanceof判断真实类型,比如(java.awt.Component的源码)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
java.awt.Component#processEvent protected void processEvent (AWTEvent e) { if (e instanceof FocusEvent) { processFocusEvent((FocusEvent)e); } else if (e instanceof MouseEvent) { switch (e.getID()) { case MouseEvent.MOUSE_PRESSED: case MouseEvent.MOUSE_RELEASED: case MouseEvent.MOUSE_CLICKED: case MouseEvent.MOUSE_ENTERED: case MouseEvent.MOUSE_EXITED: processMouseEvent((MouseEvent)e); break ; case MouseEvent.MOUSE_MOVED: case MouseEvent.MOUSE_DRAGGED: processMouseMotionEvent((MouseEvent)e); break ; case MouseEvent.MOUSE_WHEEL: processMouseWheelEvent((MouseWheelEvent)e); break ; } } else if (e instanceof KeyEvent) { processKeyEvent((KeyEvent)e); } else if (e instanceof ComponentEvent) { processComponentEvent((ComponentEvent)e); } else if (e instanceof InputMethodEvent) { processInputMethodEvent((InputMethodEvent)e); } else if (e instanceof HierarchyEvent) { switch (e.getID()) { case HierarchyEvent.HIERARCHY_CHANGED: processHierarchyEvent((HierarchyEvent)e); break ; case HierarchyEvent.ANCESTOR_MOVED: case HierarchyEvent.ANCESTOR_RESIZED: processHierarchyBoundsEvent((HierarchyEvent)e); break ; } } }
这种方法实现的双重分派都格外的冗长、复杂和容易出错,也不符合开闭原则
4.3.2 反转球实现动态分发 通过两次的调用来实现,比如下面剪刀石头布的游戏:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
public enum Outcome { WIN, LOSE, DRAW } interface Item { Outcome compete (Item it) ; Outcome eval (Paper p) ; Outcome eval (Scissors s) ; Outcome eval (Rock r) ; } class Paper implements Item { public Outcome compete (Item it) { return it.eval(this ); } public Outcome eval (Paper p) { return DRAW; } public Outcome eval (Scissors s) { return WIN; } public Outcome eval (Rock r) { return LOSE; } public String toString () { return "Paper" ; } } class Scissors implements Item { public Outcome compete (Item it) { return it.eval(this ); } public Outcome eval (Paper p) { return LOSE; } public Outcome eval (Scissors s) { return DRAW; } public Outcome eval (Rock r) { return WIN; } public String toString () { return "Scissors" ; } } class Rock implements Item { public Outcome compete (Item it) { return it.eval(this ); } public Outcome eval (Paper p) { return WIN; } public Outcome eval (Scissors s) { return LOSE; } public Outcome eval (Rock r) { return DRAW; } public String toString () { return "Rock" ; } } public class RoShamBo1 { static final int SIZE = 20 ; private static Random rand = new Random (47 ); public static Item newItem () { switch (rand.nextInt(3 )) { default : case 0 : return new Scissors (); case 1 : return new Paper (); case 2 : return new Rock (); } } public static void match (Item a, Item b) { System.out.println(a + " vs. " + b + ": " + a.compete(b)); } public static void main (String[] args) { for (int i = 0 ; i < SIZE; i++) match(newItem(), newItem()); } }
RoshamBol.match()有2个item参数,通关过Item.compete()方法开始2路分发,要判定a的类型,分发机制会在a的实际类型的compete()内部起到分发作用。compete()方法通关过eval()来为另一个类型实现第二次分发, 将自身(this)作为参数调用eval(),能够调用重载过的eval()方法,这能够保留第一次分发的类型信息,第二次分发完成时,就能知道两个Item对象的具体类型了。
这种实现也就是“访问者模式”的精华。
4.3.4 golang实现多派发 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 package mainimport ( "fmt" ) type Shape interface { Area() float64 } type Circle struct { Radius float64 } func (c Circle) float64 { return 3.14 * c.Radius * c.Radius } type Rectangle struct { Width float64 Height float64 } func (r Rectangle) float64 { return r.Width * r.Height } func CalculateArea (shape Shape) area := shape.Area() fmt.Printf("Area: %.2f\n" , area) } func main () circle := Circle{Radius: 5 } rectangle := Rectangle{Width: 4 , Height: 3 } CalculateArea(circle) CalculateArea(rectangle) }
4.3.5 js实现多派发 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 class Shape { area ( throw new Error ('Method not implemented' ); } } class Circle extends Shape { constructor (radius ) { super (); this .radius = radius; } area ( return Math .PI * this .radius * this .radius ; } } class Rectangle extends Shape { constructor (width, height ) { super (); this .width = width; this .height = height; } area ( return this .width * this .height ; } } function calculateArea (shape ) { const area = shape.area (); console .log (`Area: ${area.toFixed(2 )} ` ); } const circle = new Circle (5 );const rectangle = new Rectangle (4 , 3 );calculateArea (circle); calculateArea (rectangle);
4.3.6 java需要借助观察者模式或者访问者模式实现 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 interface Shape { void accept (ShapeVisitor visitor) ; } class Circle implements Shape { private double radius; public Circle (double radius) { this .radius = radius; } public double getRadius () { return radius; } public void accept (ShapeVisitor visitor) { visitor.visit(this ); } } class Rectangle implements Shape { private double width; private double height; public Rectangle (double width, double height) { this .width = width; this .height = height; } public double getWidth () { return width; } public double getHeight () { return height; } public void accept (ShapeVisitor visitor) { visitor.visit(this ); } } interface ShapeVisitor { void visit (Circle circle) ; void visit (Rectangle rectangle) ; } class AreaCalculator implements ShapeVisitor { public void visit (Circle circle) { double area = Math.PI * circle.getRadius() * circle.getRadius(); System.out.printf("Area of circle: %.2f\n" , area); } public void visit (Rectangle rectangle) { double area = rectangle.getWidth() * rectangle.getHeight(); System.out.printf("Area of rectangle: %.2f\n" , area); } } public class Main { public static void main (String[] args) { Shape circle = new Circle (5 ); Shape rectangle = new Rectangle (4 , 3 ); ShapeVisitor areaCalculator = new AreaCalculator (); circle.accept(areaCalculator); rectangle.accept(areaCalculator); } }
4.4 状态机模式
状态机模式
在状态模式(State Pattern)中,类的行为是基于它的状态改变的。这种类型的设计模式属于行为型模式
在状态模式中,我们创建表示各种状态的对象和一个行为随着状态对象改变而改变的 context 对象
在状态模式中有三个主要角色:
环境类(Context)角色 :也称上下文,它定义了客户端需要的接口 ,内部维护一个当前的状态,并负责具体状态的切换抽象状态(State)角色 :定义一个接口,用以封装环境对象中的特定状态所对应的行为,可以有一个或多个行为具体状态(Concrete State)角色 :实现抽象状态所对应的行为,并且在需要的情况下进行状态切换
开发中用的最多的是:当状态变化时,其内部形态也要跟着变化,从而使其行为也发生改变
打个比方,当订单的状态由待支付变成已支付时,我们需要它能够自动完成例如订单持久化等操作
4.4.1 问题引入 在没有状态机模式之前,我们大概率是直接搞个字段status放到表里面,然后在业务代码里面去修改里面的状态,然后在需要用到状态的地方再去查一下db,我们想想这样有哪些弊端?
4.4.3 状态模式解决问题 例如在
4.4.3 市面上的状态机 目前开源的状态机实现方案有:
spring-statemachine(1.4k star)
squirrel-foundation (2k star)
stateless4j (790 star)
cola stateMachine(9.3k star)
上述的状态机也有一些问题:
1️⃣ 太复杂
由于基本实现了UML State Machine中所有的功能,搞得体积非常庞大、臃肿、重量级。很多方法根本用不到,例如:状态的嵌套(substate)、状态的并行(parallel、fork、join)、子状态机等等
2️⃣ 性能差
这些状态机都是有状态的(Stateful),有状态意味着多线程并发情况下如果同时操控单个实例,很容易出现线程安全问题
微服务盛行的今天,如果一个请求创建一个状态机实例,会导致内存占用过高 。如果状态机创建过程复杂,也可能会造成性能瓶颈
其中用的比较多的spring-statemachine的缺点还有:
StateMachine对spring事务不支持(关键很致命)
stateMachine无法抛出异常,异常会被状态机给消化掉
这里推荐阿里开源的状态机(https://github.com/alibaba/COLA):
代码简单,易于学习,便于根据我们的业务线基础上做二次开发。
无状态,减少内存消耗,线程先天安全。
先天支持事务
先天会自己抛出异常,不会像spring stateMachine出现将异常吃掉情况(当然通过反射确实可以将异常抛出)。
包小,摒弃了spring stateMachine中没有必要的功能,功能相对单一,包自然就小了。同时减少了资源的浪费
4.4.4 spring状态机 https://www.cnblogs.com/Zero-Jo/p/13891075.html
4.4.5阿里状态机-cola stateMachine https://www.cnblogs.com/Zero-Jo/p/14622937.html


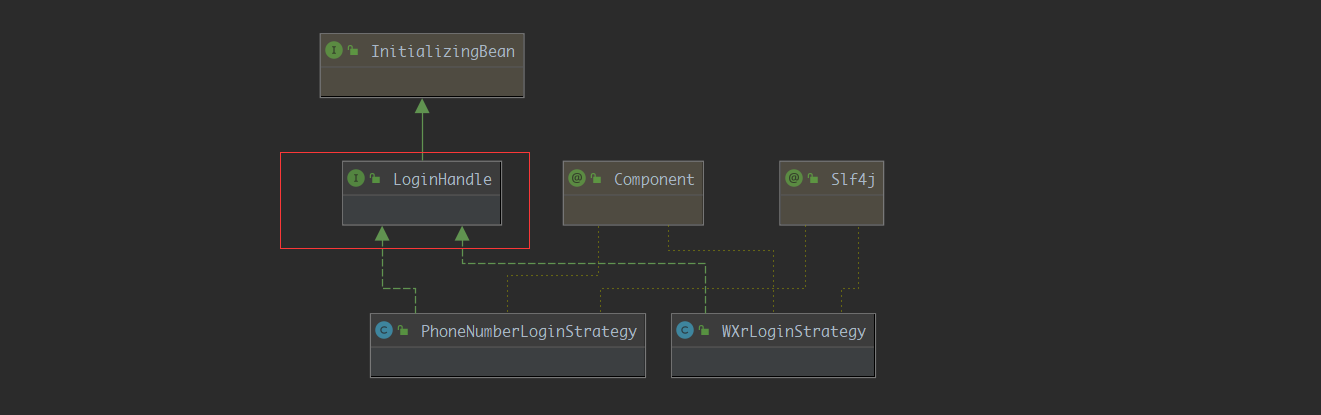
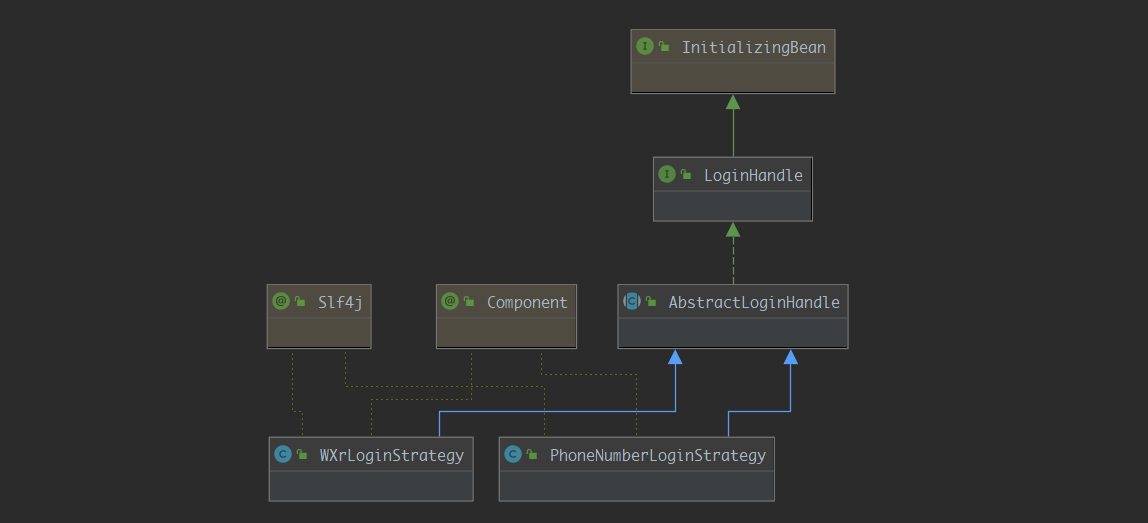
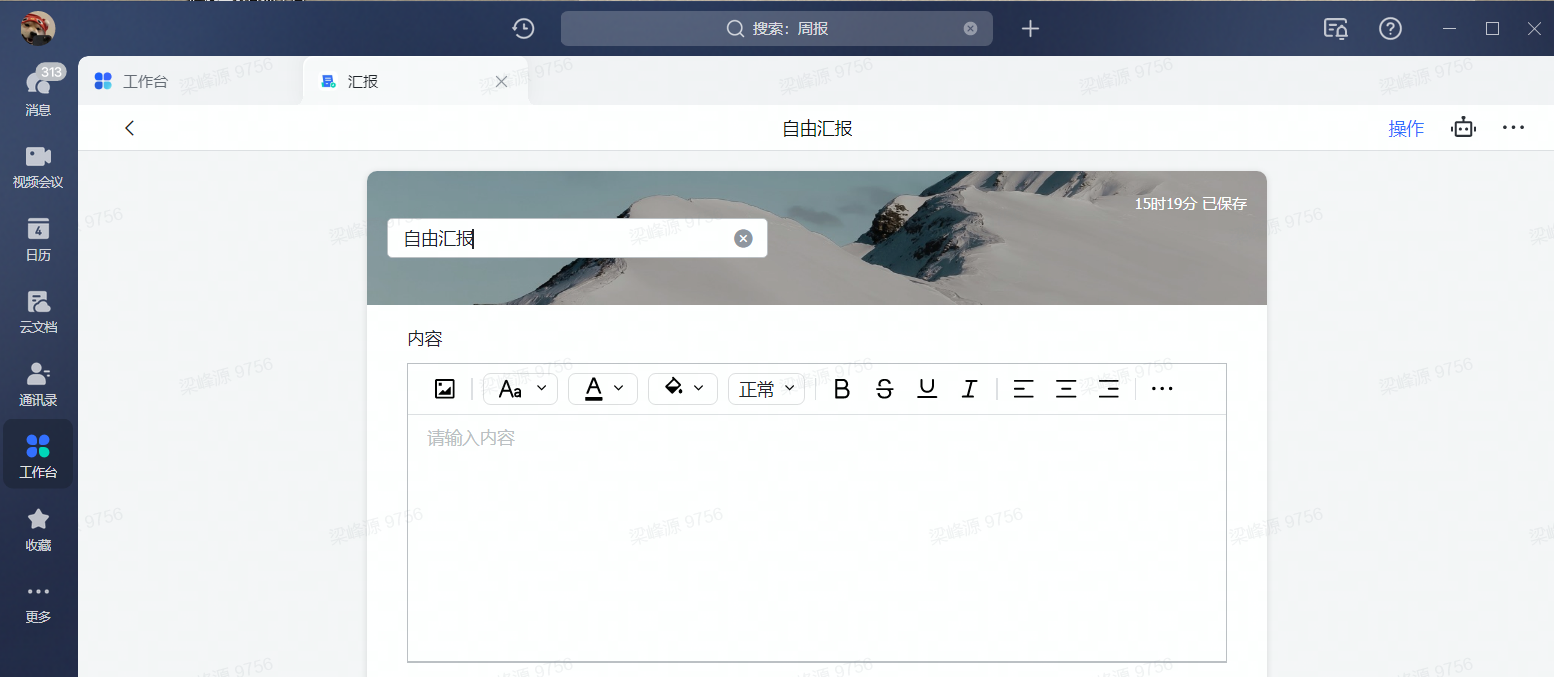
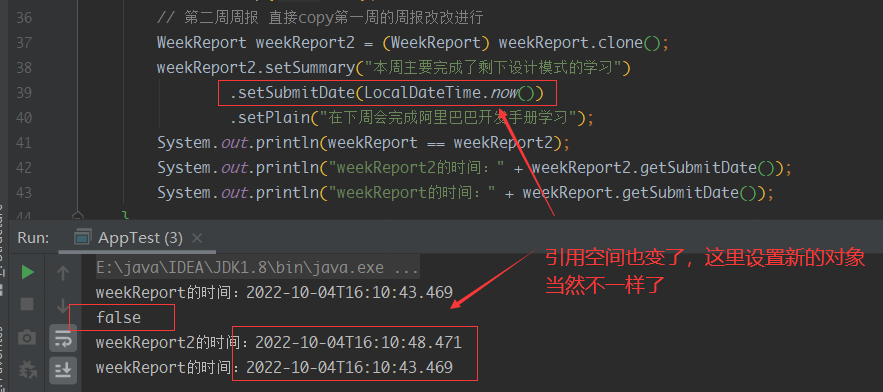
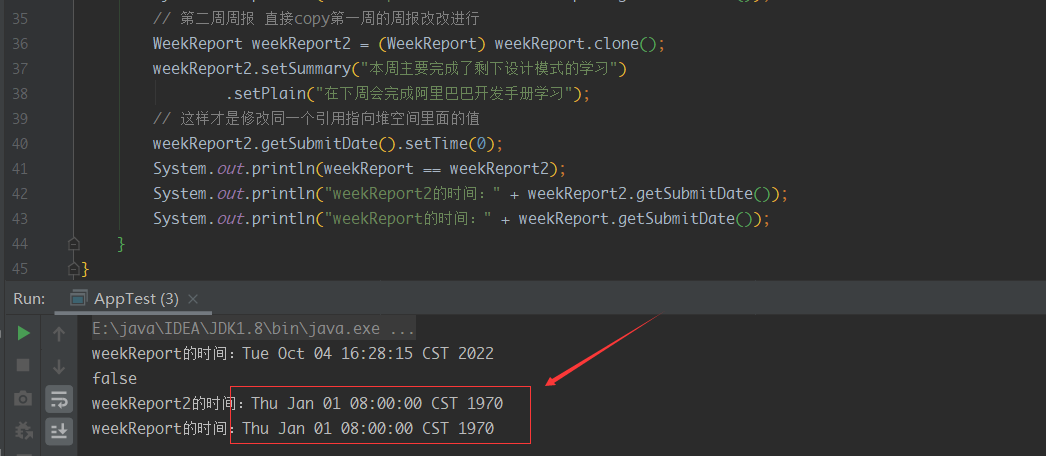
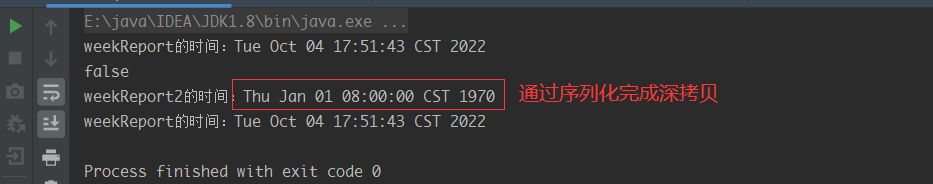
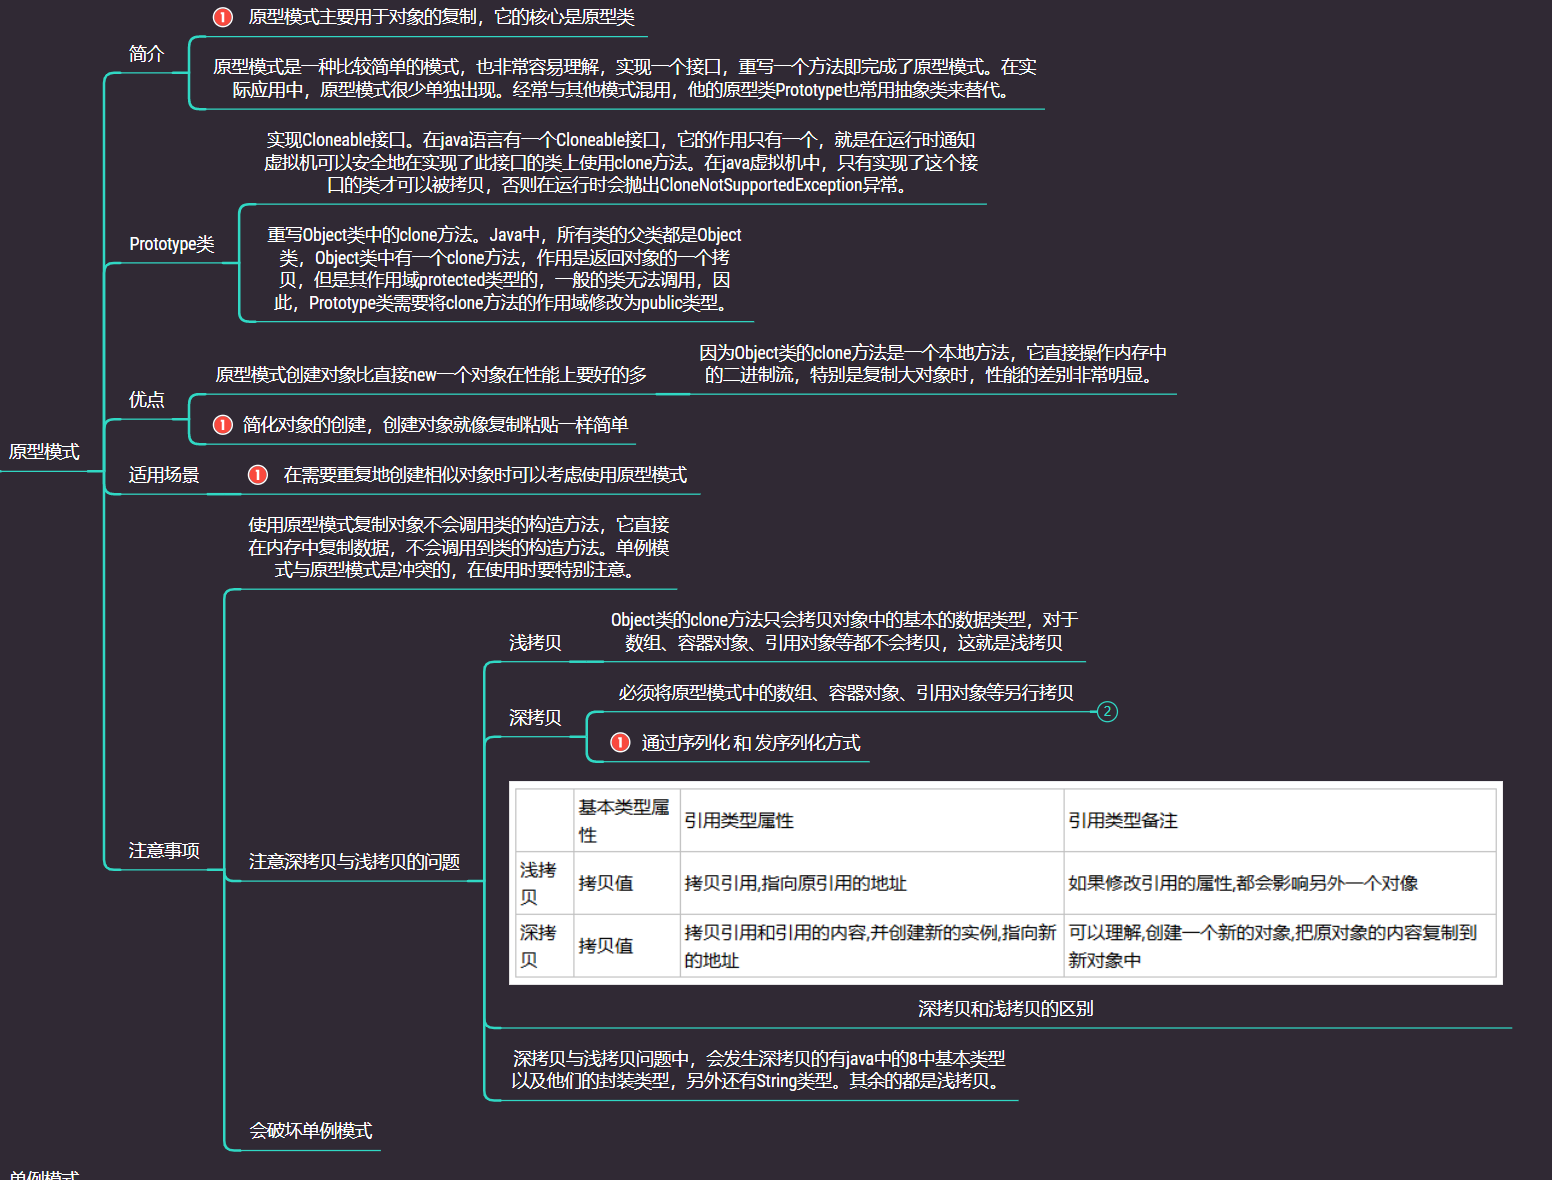
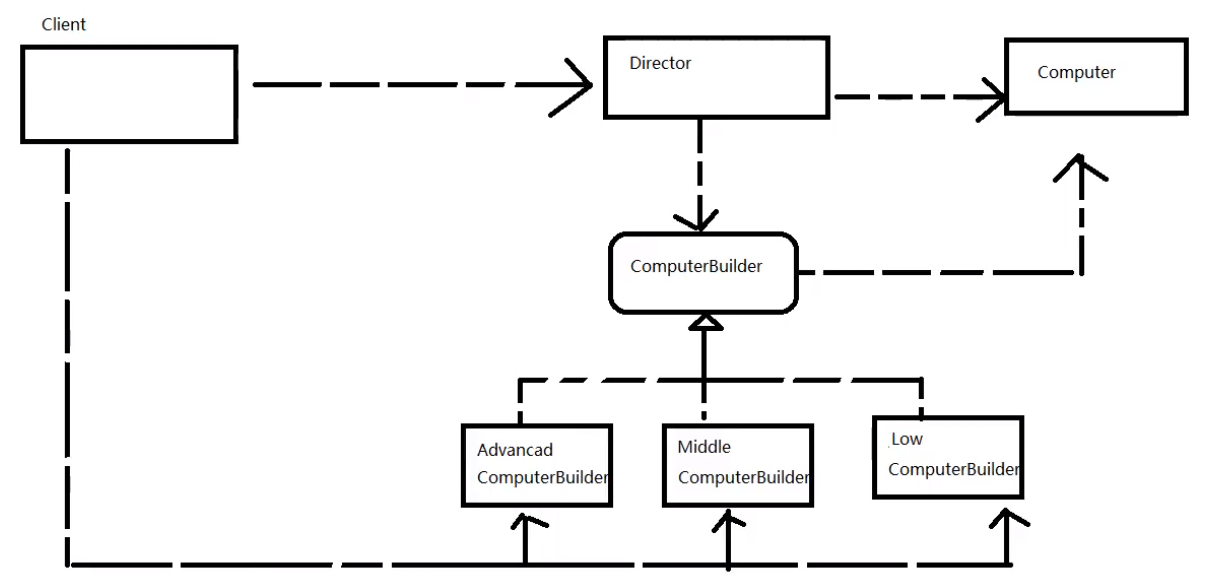
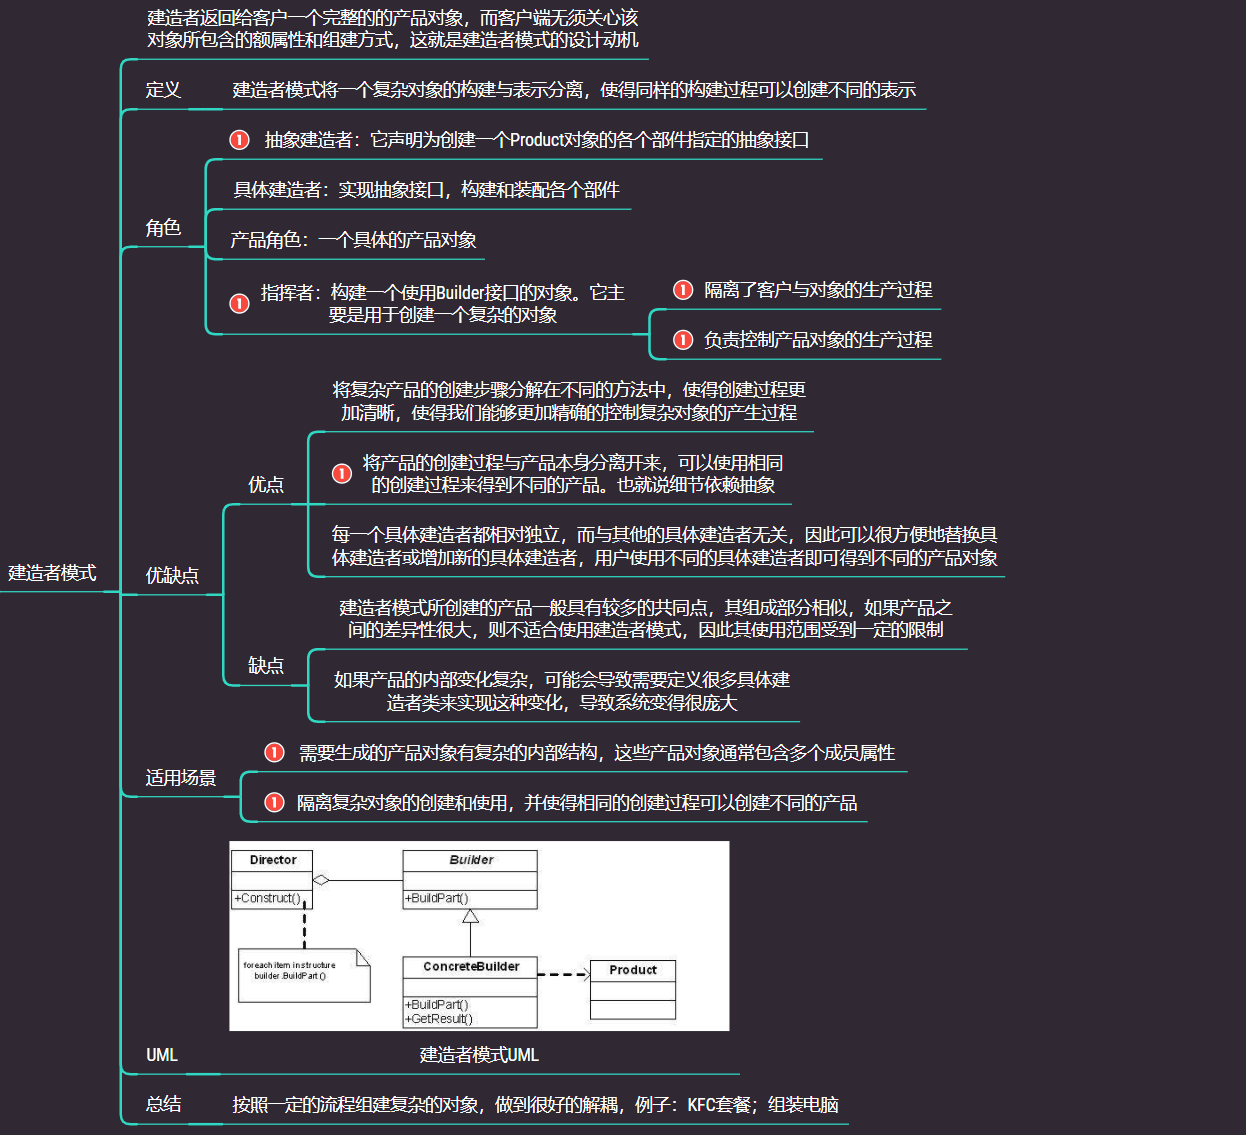
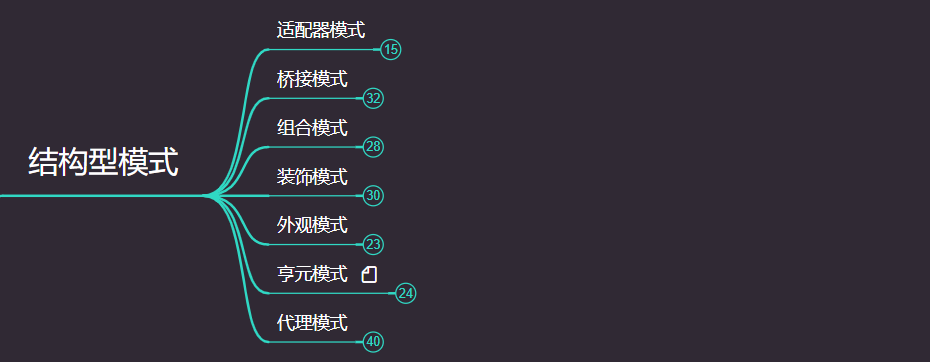
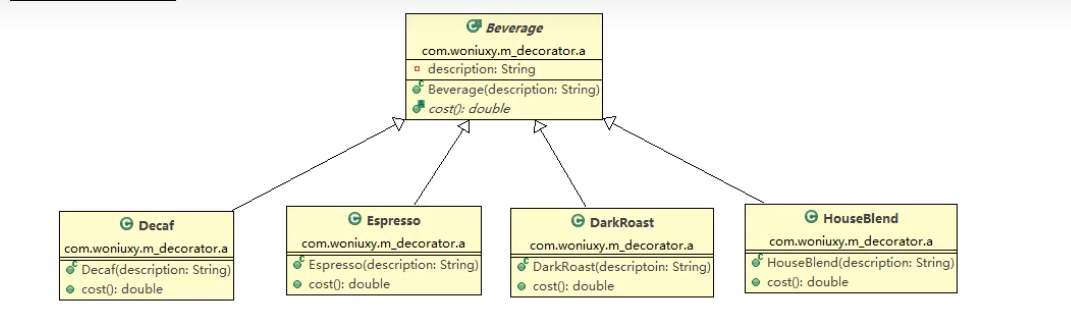
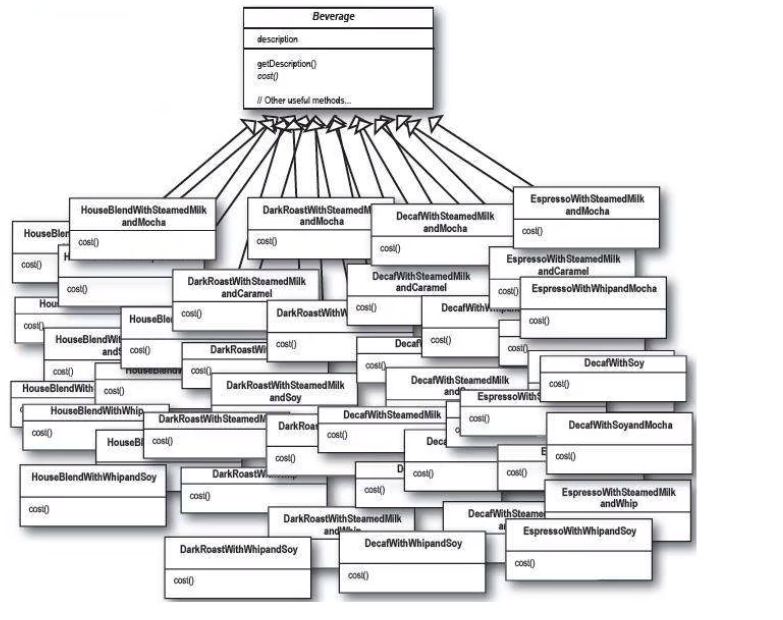
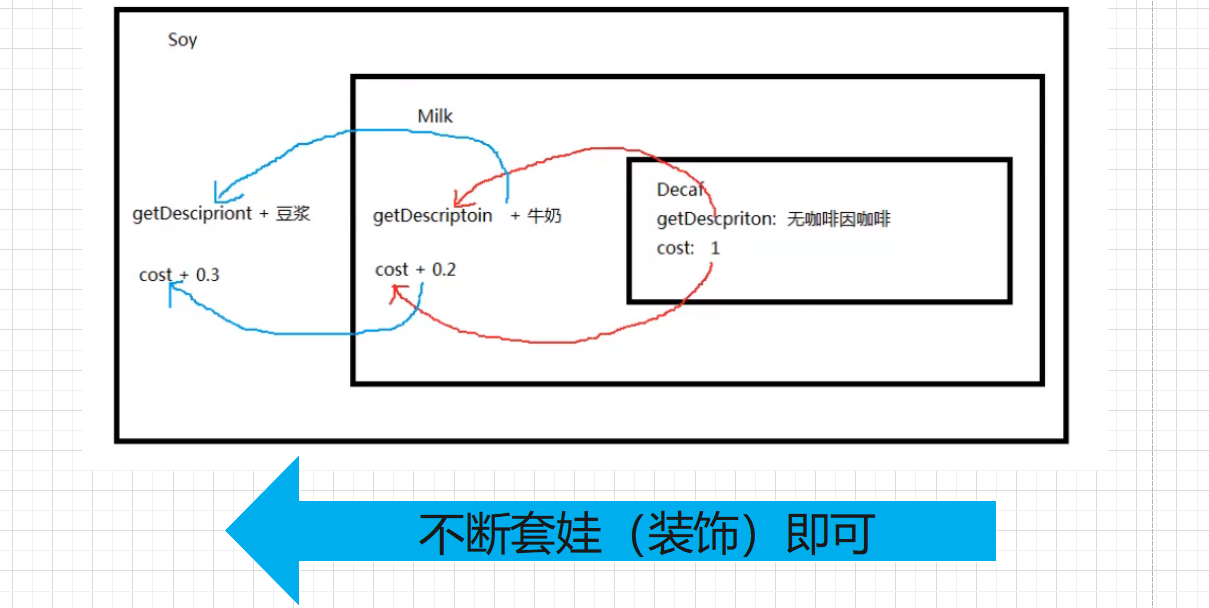
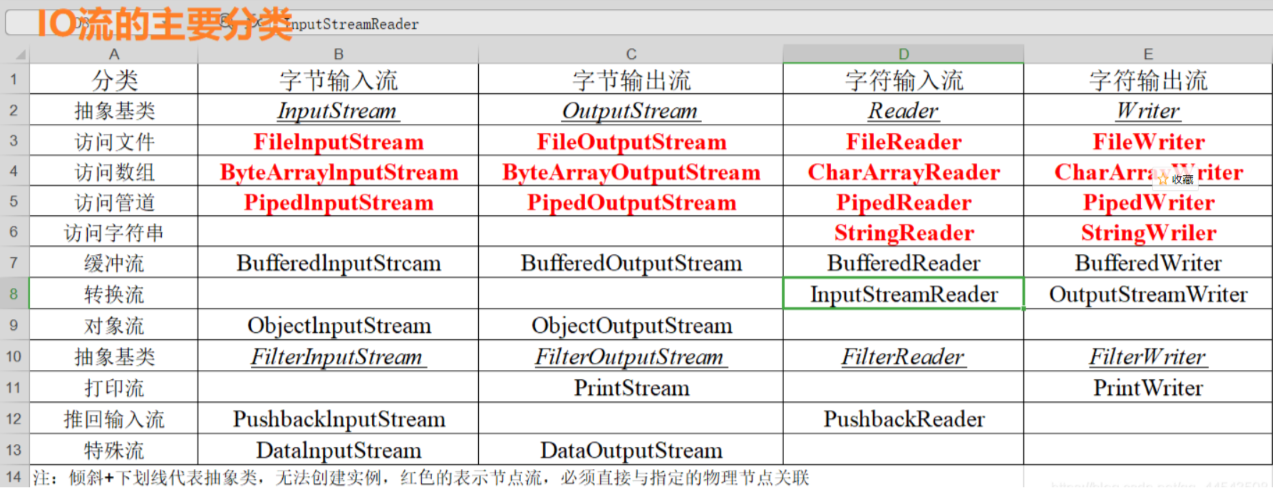
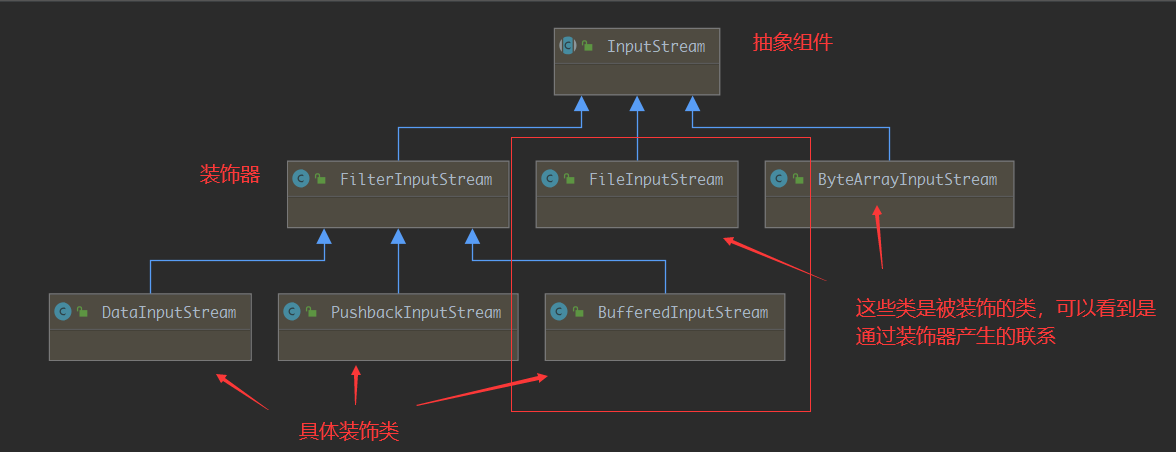 可以看到我们通过装饰器