java内存模型1

一、为什么有java内存模型?

  • 背景

    1. 现有计算机往往是多核的,每个核心下会有高速缓存。高速缓存的诞生是由于「CPU 与内存(主存)的速度存在差异」,L1 和 L2 缓存一般是「每个核心独占」一份的。
    2. 为了让 CPU 提高运算效率,处理器可能会对输入的代码进行「乱序执行」,也就是所谓的「指令重排序」。
    3. 一次对数值的修改操作往往是非原子性的(比如计实际上在计算机执行时就会分成多个指令)

    即:可见性、有序性、原子性

  • 单线程不存在以上问题

    1. 在永远单线程下,上面所讲的均不会存在什么问题,因为单线程意味着无并发。并且在单线程下,编译器/runtime/处理器都必须遵守as-if-serial语义,遵守as-if-serial意味着它们不会对「数据依赖关系的操作」做重排序。
    2. CPU为了效率,有了高速缓存、有了指令重排序等等,整块架构都变得复杂了。我们写的程序肯定也想要「充分」利用CPU的资源啊!于是乎,我们使用起了多线程
  • 多线程线程安全问题

    1. 缓存数据不一致:多个线程同时修改「共享变量」,CPU核心下的高速缓存是「不共享」的,那多个cache与内存之间的数据同步该怎么做?
    2. CPU指令重排序在多线程下会导致代码在非预期下执行,最终会导致结果存在错误的情况。
  • 缓存不一致问题

    1. 使用「总线锁」:某个核心在修改数据的过程中,其他核心均无法修改内存中的数据。(类似于独占内存的概念,只要有CPU在修改,那别的CPU就得等待当前CPU释放)
    2. 缓存一致性协议(MESI协议,其实协议有很多,只是举个大家都可能见过的)。MESI拆开英文是(Modified(修改状态)、Exclusive(独占状态)、Share(共享状态)、Invalid(无效状态))

    缓存一致性协议我认为可以理解为「缓存锁」,它针对的是「缓存行」(CacheIine)进行”加锁”,所谓「缓存行」其实就是高速缓存存储的最小单位。MESI协议的原理大概就是:当每个CPU读取共享变量之前,会先识别数据的「对象状态」(是修改、还是共享、还是独占、还是无效)。如果是独占,说明当前CPU将要得到的变量数据是最新的,没有被其他CPU所同时读取。如果是共享,说明当前CPU将要得到的变量数据还是最新的,有其他的CPU在同时读取,但还没被修改。如果是修改,说明当前CPU正在修改该变量的值,同时会向其他CPU发送该数据状态为invalid(无效)的通知,得到其他CPU响应后(其他CPU将数据状态从共享(share)变成invalid(无效)),会当前CPU将高速缓存的数据写到主存,并把自己的状态从modify(修改)变成exclusive (独占)。如果是无效,说明当前数据是被改过了,需 要从主存重新读取最新的数据。

    其实MESI协议做的就是判断「对象状态」,根据「对象状态」做不同的策略。

    关键就在于某个CPU在对数据进行修改时,需要「同步」通知其他CPU,表示这个数据被我修改了,你们不能用了。
    比较于「总线锁」,MESI协议的”锁粒度”更小了,性能那肯定会更高咯

  • cpu还有优化

    1. 优化思路就是从「同步」变成「异步」。
      在修改时会「同步」告诉其他CPU,而现在则把最新修改的值写到「store buffe r」中,并通知其他CPU记得要改状态,随后CPU就直接返回干其他事了。等到收到其它CPU发过来的响应消息,再将数据更新到高速缓存中。其他CPU接收到invalid(无效)通知时,也会把接收到的消息放入「invalid queue」中,只要写到「invalid queue」就会直接返回告诉修改数据的CPU已经将状态置为「invalid」

二、什么是java内存模型

  1. 由于不同CPU架构的缓存体系不一样、缓存一致性协议不一样、重排序的策略不一样、所提供的内存屏障指令也有差异,为了简化Java开发人员的工作。Java封装了一套规范,这套规范就是「Java 内存模型」
  2. 再详细地说,「Java内存模型」希望屏蔽各种硬件和操作系统的访问差异,保证了Java程序在各种平台下对内存的访问都能得到一致效果。
  3. 目的是解决多线程存在的原子性、可见性(缓存一致性)以及有序性问题。

java内存模型它是一种规范,java虚拟机会实现这种规范

三、java内存模型的内容

  1. java内存模型的抽象结构

    定义:

    • java内存模型定义了:java线程对内存数据进行交互的规范。

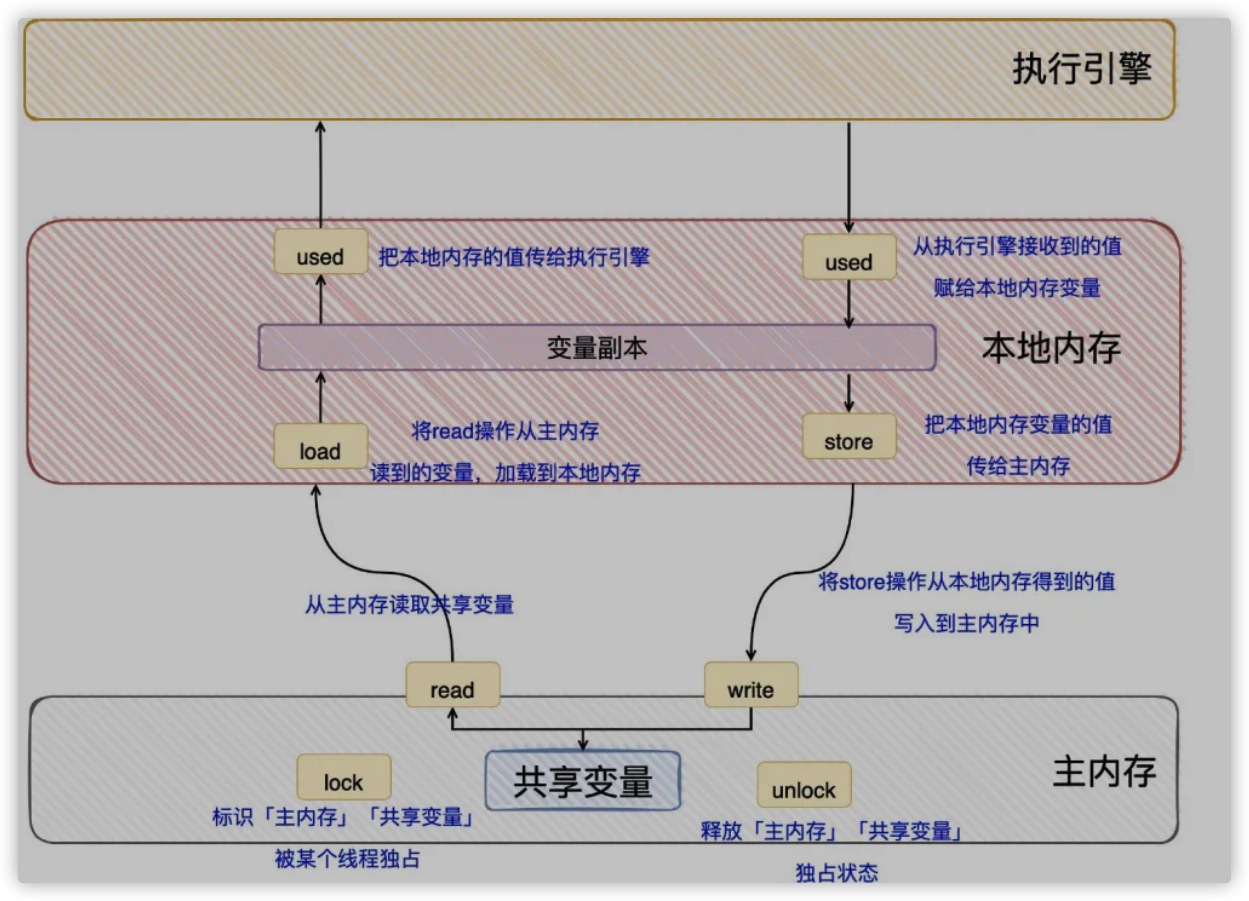
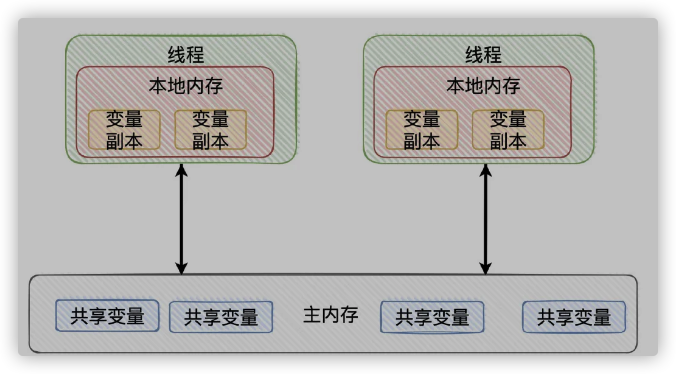
    • 线程之间的「共享变量」存储在「主内存」中,每个线程都有自己私有的「本地内存」,「本地内存」存储了该线程以读/写共享变量的副本。

    • 本地内存是Java内存模型的抽象概念,并不是真实存在的。

    规定:

    • Java内存模型规定了:线程对变量的所有操作都必须在「本地内存」进行,「不能直接读写主内存」的变量
    • Java内存模型定义了8种操作来完成「变量如何从主内存到本地内存,以及变量如何从本地内存到主内存」,分别是read/load/use/assign/store/write/lock/unlock操作
    • 看着8个操作很多,对变量的一次读写就涵盖了这些操作了,我再画个图给你讲讲

  2. happen-beforeguize

    • 按我的理解下,happen-before实际上也是一套「规则」。Java内存模型定义了这套规则,目的是为了阐述「操作之间」的内存「可见性」。

    • 从上次讲述「指令重排」就提到了,在CPU和编译器层面上都有指令重排的问题。

      指令重排虽然是能提高运行的效率,但在并发编程中,我们在兼顾「效率」的前提下,还希望「程序结果」能由我们掌控的。
      说白了就是:在某些重要的场景下,这一组操作都不能进行重排序,「前面一个操作的结果对后续操作必须是可见的」

    • 于是,Java内存模型 happen-就提出了-b efore这套规则,规则总共有8条:比如传递性、 volatile变量规则、程序顺序规则、监视器锁的规则(具体看规则的含义就好了,这块不难)

    • 只要记住,有了 happen-before-这些规则。我们写的代码只要在这些规则下,前一个操作的结果对后续操作是可见的,是不会发生重排序的。

  3. 对volatile内存语义的探讨

  • 嗯,volatile是Java的一个关键字
    为什么讲Java内存模型往往就会讲到volatile这个关键字呢,我觉得主要是它的特性:可见性和有序性(禁止重排序

  • Java内存模型这个规范,很大程度下就是为了解决可见性和有序性的问题。

  • Java内存模型为了实现volatile有序性和可见性,定义了4种内存屏障的「规范」,分别是LoadLoad/LoadStore/StoreLoad/StoreStore

  • 回到volatile上,说白了,就是在volatile「前后」加上「内存屏障」,使得编译器和CPU无法进行重排序,致使有序,并且写volatile变量对其他线程可见。

  • Java内存模型定义了规范,那Java虚拟机就得实现啊,是不是?

    • 之前看过Hotspot虚拟机的实现,在「汇编」层面上实际是通过Lock前缀指令来实现的,而不是各种fence指令(主要原因就是简便。因为大部分平台都支持lock指令,而fence指令是x86平台的)。
    • lock指令能保证:禁止CPU和编译器的重排序(保证了有序性)、保证CPU写核心的指令可以立即生效且其他核心的缓存数据失效(保证了可见性)
  • volatile和MESI协议有啥关系?

    • 没啥关系:Java内存模型关注的是编程语言层面上,它是高维度的抽象。

    • MESI是CPU缓存一致性协议,不同的CPU架构都不一样,可能有的CPU压根就没用MESI协议..

    • 只不过MESI名声大,大家就都拿他来举例子了。

    • MESI可能只是在「特定的场景下」为实现volatile的可见性/有序性而使用到的一部分罢了

    • 为了让Java程序员屏蔽上面这些底层知识,快速地入门使用volatile变量

    • Java内存模型的happen-before规则中就有对volatile变量规则的定义:
      这条规则的内容其实就是:对一个volatil e变量的写操作相对于后续对这个volatile变量的读操作可见

      它通过happen-before规则来规定:只要变量声明了volatile关键字,写后再读,读必须可见写的值。(可见性、有序性)

l

java垃圾回收

一、jvm内存结构

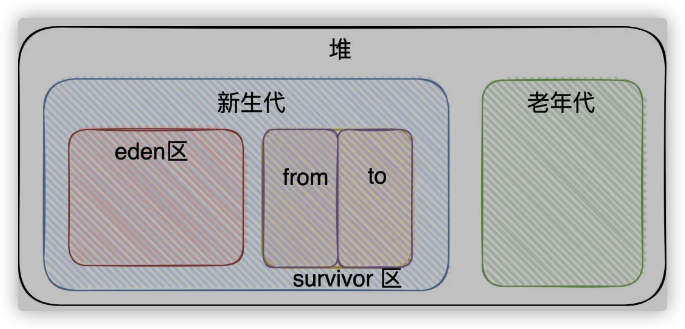
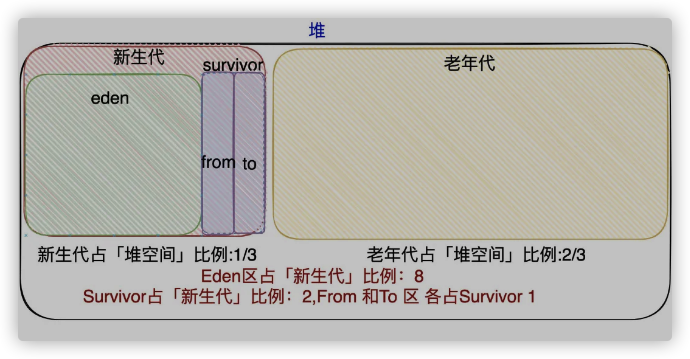
嗯,前面提到了堆分了「新生代」和 「老年代」,「新生代」又分为「Eden」和「Survivor」区,「Survivor」区又分为「From Survivor」和「To Survivor」区

二、垃圾回收机制

  • 背景

我们使用Java的时候,会创建很多对象,但我们未曾「手动」将这些对象进行清除;
而如果用C/C++语言的时候,用完是需要自己free(释放)掉的;
那为什么在写Java的时候不用我们自己手动释放”垃圾”呢?原因很简单,JVM帮我们做了(自动回收垃圾)

  • 垃圾定义

我个人对垃圾的定义:只要对象不再被使用了,那我们就认为该对象就是垃圾,对象所占用的空间就可以被回收

  • 判断垃圾不再被使用

    常用算法有2个:引用计数法、可达性分析法

  1. 引用计数法思路很简单:当对象被引用则+1,但对象引用失败则-1。当计数器为0时,说明对象不再被引用,可以被可回收
    缺点:引用计数法最明显的缺点就是:如果对象存在循环依赖,那就无法定位该对象是否应该被回收(A依赖B,B依赖A)

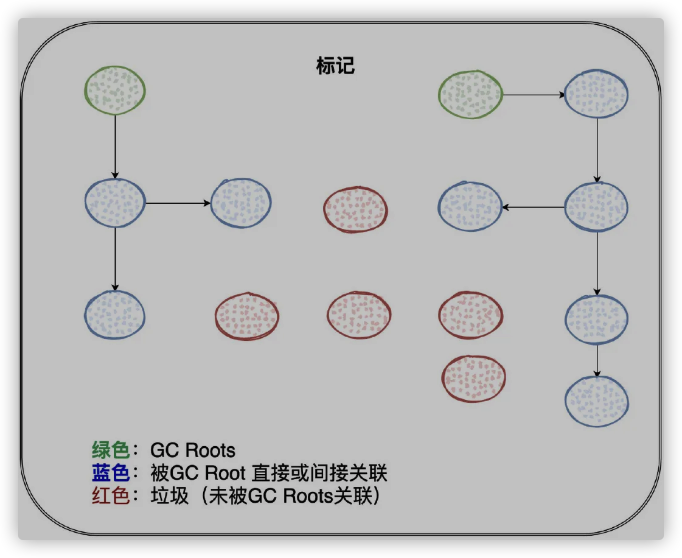
  2. 另一种就是可达性分析法:它从「GCR oots」开始向下搜索,当对象到「GCRoots」都没有任何引用相连时,说明对象是不可用的,可以被回收。
    「GC Roots」是一组必须「活跃」的引用。
    从「GC Root」出发,程序通过直接引用或者间接引用,能够找到可能正在被使用的对象。

    例子:比如我们上次不是聊到JVM内存结构中的虚拟机栈吗,虚拟机栈里不是有栈帧吗,栈帧不是有局部变量吗?局部变量不就存储着引用嘛。
    那如果栈帧位于虚拟机栈的栈顶,是不是说明这个栈帧是活跃的(换言之,是线程正在被调用的)
    既然是线程正在调用的,那栈帧里的指向「堆」的对象引用,是不是一定是「活跃」的引用?

    所以,当前活跃的栈帧指向堆里的对象引用就可以是「GCRoots」

    当然,比如类的静态变量引用是「GCRootS」,被「Java本地方法」所引用的对象也是「GCRoots」等等。。。
    即:回到理解的重点:「GCRoots」是一组必须「活跃」的「引用」,只要跟「GCRoots」没有直接或者间接引用相连,那就是垃圾
    JVM用的就是「可达性分析算法」来判断对象是否为垃圾

  • 垃圾回收第一步就是标记

标记哪些没有被「GC Roots」引用的对象

  • 标记完后就可以清除了

    • 标记完之后,我们就可以选择直接「清除」,只要不被「GCRoots」关联的,都可以干掉过程非常简单粗暴。

      但也存在很明显的问题
      直接清除会有「内存碎片」的问题:可能我有10M的空余内存,但程序申请9M内存空间却申请不下来(10M的内存空间是垃圾清除后的,不连续的)

    • 那解决「内存碎片」的问题也比较简单粗暴,「标记」完,不直接「清除」
      我把「标记」存活的对象「复制」到另一块空间,复制完了之后,直接把原有的整块空间给干掉!这样就没有内存碎片的问题了
      这种做法缺点又很明显:内存利用率低,得有一块新的区域给我复制(移动)过去

    • 还有一种「折中」的办法,我未必要有一块「大的完整空间」才能解决内存碎片的问题,我只要能在「当前区域」内进行移动
      把存活的对象移到一边,把垃圾移到一边,那再将垃圾一起删除掉,不就没有内存碎片了嘛,专业术语叫做整理。

  • 年轻代、老年代
    「垃圾回收」是会导致「stop the word」 (应用停止访问)
    理解「stop the word」应该很简单吧:回收垃圾的时候,程序是有短暂的时间不能正常继续运作啊。不然JVM在回收的时候,用户线程还「不停止」继续分配修改引用,JVM怎么搞(:

    经过研究表明:大部分对象的生命周期都很短,而只有少部分对象可能会存活很长时间

    • 为了使「stop the word」持续的时间尽可能短以及提高并发式GC所能应付的内存分配速率
      在很多的垃圾收集器上都会在「物理」或者「逻辑」上,把这两类对象进行区分司P
      死得快的对象所占的区域叫做「年轻代」,活得久的对象所占的区域叫做「老年代」

      (jdk8及以下分年轻代、老年代;高版本的垃圾收集器ZGC,是没有分代的概念的)

  • 垃圾回收过程:对应几种垃圾回收算法

    其实在前面更前面提到了垃圾回收的过程,其实就对应着几种「垃圾回收算法」分别是:
    标记清除算法、标记复制算法和标记整理算法【「标记」「复制」「整理」】

  • jdk8生产环境下常见垃圾回收器

    「年轻代」的垃圾收集器有:Serial、Parallel Scavenge、 ParNew
    「老年代」的垃圾收集器有:Serial Old、 Parallel Old、CMS

    • 看着垃圾收集器有很多,其实还是非常好理解的。Serial是单线程的,Parallel是多线程
    • 这些垃圾收集器实际上就是「实现了」垃圾回收算法(标记复制、标记整理以及标记清除算法)
    • CMS是比较新的垃圾收集器,它的特点是能够尽可能减少「stopthe word」时间。在垃圾回收时让用户线程和GC线程能够并发执行!
    • 「年轻代」的垃圾收集器使用的都是「标记复制算法」
      所以在「堆内存」划分中,将年轻代划分出Survivor区(Survivor From和Survivor To),目的就是为了有一块完整的内存空间供垃圾回收器进行拷贝(移动),而新对象都是放入Eden区的。
    • 我下面重新画下「堆内存」的图,因为它们的大小是有默认的比例的

  • 新生代何时会变老年代
    分2种情况:

    1. 如果对象太大了,就会直接进入老年代(对象创建时就很大 || Survivor区没办法存下该对象)
    2. 如果对象太老了,那就会晋升至老年代(每发生一次MinorGC,存活的对象年龄+1,达到默认值15则晋升老年代 || 动态对象年龄判定可以进入老年代)
      • 当Eden区空间不足时,就会触发MinorGC
      • 那在「年轻代」GC的时候,从GC Roots出发,那不也会扫描到「老年代」的对象吗?那那那..不就相当于全堆扫描吗?
        • 这JVM里也有解决办法的。下我的看法
          HotSpot虚拟机「老的GC」(G1以下) 是要求整个GC堆在连续的地址空间上
          所以会有一条分界线(一侧是老年代,另一侧是年轻代),所以可以通过「地址」就可以判断对象在哪个分代上如
        • 当做MonorGC的时候,从GCRoots出发,如果发现「老年代」的对象,那就不往下走了(MonorGC对老年代的区域毫无兴趣)
      • 但又有个问题,那如果年轻代」的对象被「老年代」引用了呢?(老年代对象持有年轻代对象的引用),这时候肯定是不能回收掉「年轻代」的对象的?
        • HotSpot虚拟机下有「card table」(卡表)来避免全局扫描「老年代」对象
        • 「堆内存」的每一小块区域形成「卡页」,卡表实际上就是卡页的集合。当判断一个卡页中有存在对象的跨代引用时,将这个页标记为「脏页」
        • 那知道了「卡表」之后,就很好办了。每次MinorGC的时候只需要去「卡表」找到「脏页」,找到后加入至GCRoot,而不用去遍历整个「老年代」的对象了。
l

java学习路线图

项目地址:

这篇回答不会涉及到学习方法以及学习网站的推荐,我不想让篇幅太长,内容太杂,我希望留着下一篇文章专门来谈一谈。

另外,这篇回答也不会涉及到计算机基础,也是为了保证内容的不至于太杂。计算基础相关的内容我也已经写好,预计会在五一同步给小伙伴们。
imgimg

多说一句,对于编程初学者,我不太建议上来通过做项目学习。实践确实很重要,如果你没有编程基础的话,直接上手实战,很容易最后学个四不像。

建议你在学习编程的初期尽量多看一些优质视频。跟着视频一步一步走,可以让你少踩很多坑,学习编程的信心也会增加。

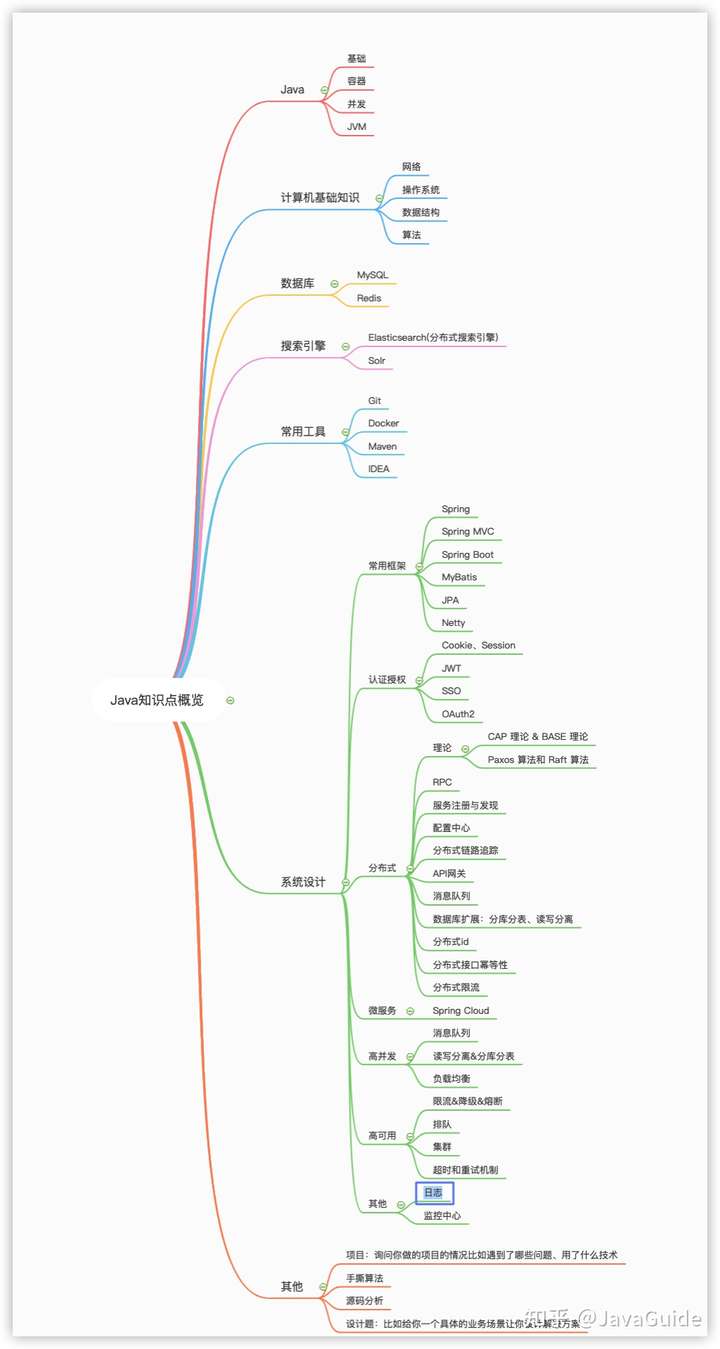
概览:
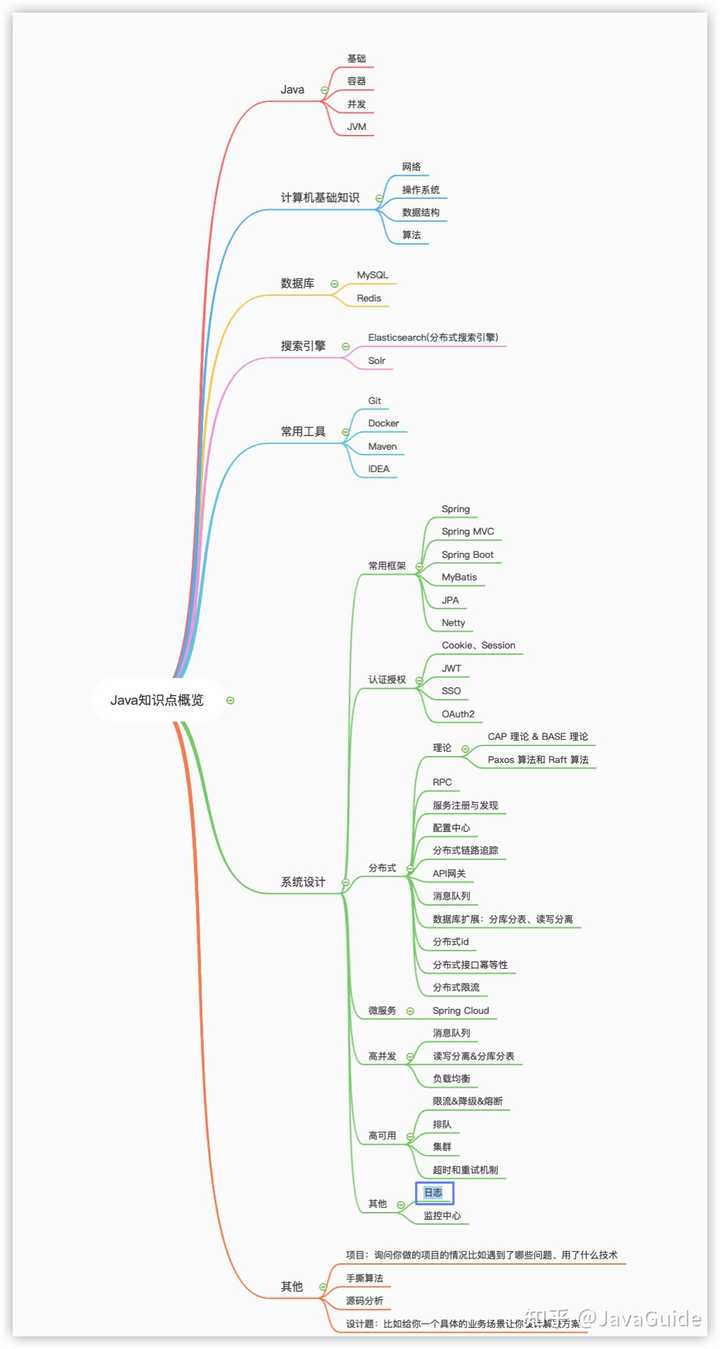
imgimg

回答中的相关书籍我也已经同步到了 Github和Gitee上(有PDF版本可供下载),欢迎小伙伴们一起完善。

Java 基础

如果你之前没有学习过编程的话,我建议你可以看看视频教程。

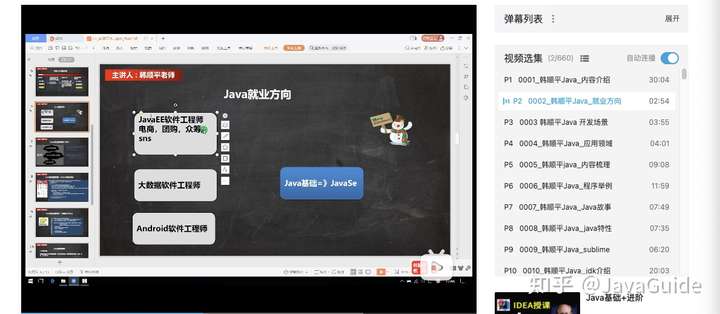
像尚硅谷的 《 Java 基础教程系列》和韩顺平老师的《零基础 30 天学会 Java》就很不错。
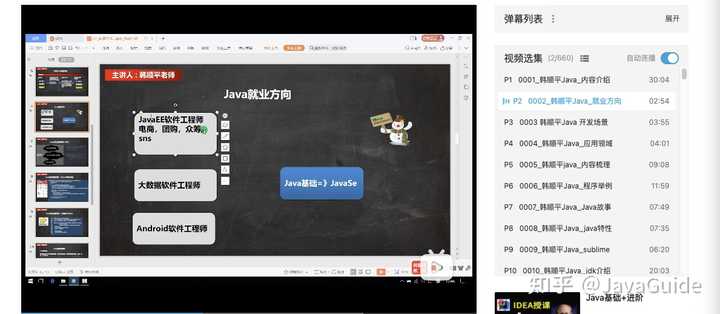
imgimg

学习过 Java 的朋友,大部分应该都看过韩老师的课程吧!韩老师毕业于清华大学,录制的视频课程质量都非常高。内容易懂,并且不失严谨。

韩老师的《零基础 30 天学会 Java》系列不光会教你 Java 基础,还会帮你建立编程思想,让你知道学习了 Java 之后,你可以从事什么工作。

看视频的同时,配套一本好书也是非常有作用的。

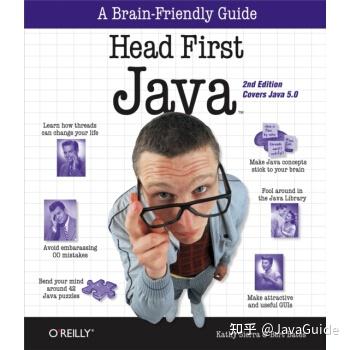
《Head First Java》 这本书在是入门 Java 的很不错的书籍 。
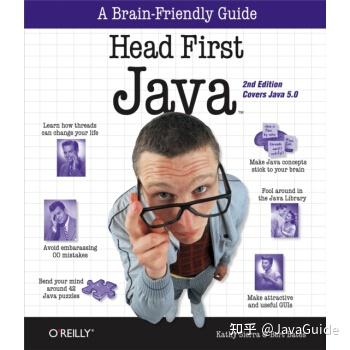
imgimg

《Head First Java》这本书的内容很轻松有趣,可以说是我学习编程初期最喜欢的几本书之一了。同时,这本书也是我的 Java 启蒙书籍。我在学习 Java 的初期多亏了这本书的帮助,自己才算是跨进 Java 语言的大门。

我觉得我在 Java 这块能够坚持下来,这本书有很大的功劳。我身边的的很多朋友学习 Java 初期都是看的这本书。

有很多小伙伴就会问了:这本书适不适合编程新手阅读呢?

我个人觉得这本书还是挺适合编程新手阅读的,毕竟是 “Head First” 系列。
imgimg

《Java 核心技术卷 1+卷 2》 这两本书也非常不错。不过,这两本书的内容很多,全看的话比较费时间。我现在是把这两本书当做工具书来用,就比如我平时写文章的时候,碰到一些 Java 基础方面的问题,经常就翻看这两本来当做参考!

我当时在大学的时候就买了两本放在寝室,没事的时候就翻翻。建议有点 Java 基础之后再读,介绍的还是比较深入和全面的,非常推荐。
imgimg

《Java 编程思想 》 这本书被很多人称之为 Java 领域的圣经(*感觉有点过了~~~*)。不太推荐编程初学者阅读,有点劝退的味道,稍微有点基础后阅读更好。

我第一次看的时候还觉得有点枯燥,那时候还在上大二,看了 1/3 就没看下去了。
imgimg

另外,Java 8 算是一个里程碑式的版本,现在一般企业还是用 Java 8 比较多。掌握 Java 8 的一些新特性比如 Lambda、Strean API 还是挺有必要的。这块的话,我推荐 《Java 8 实战》 这本书。

学完 Java 基础之后,你可以用自己学的东西实现一个简单的 Java 程序,也可以尝试用 Java 解决一些编程问题,以此来将自己学到的东西付诸于实践。

不太建议学习 Java 基础的之后通过做游戏来巩固。为什么培训班喜欢通过这种方式呢?说白点就是为了找到你的 G 点。新手学习完 Java 基础后做游戏一般是不太现实的,还不如找一些简单的程序问题解决一下比如简单的算法题。

记得多总结!打好基础!把自己重要的东西都记录下来。 API 文档放在自己可以看到的地方,以备自己可以随时查阅。为了能让自己写出更优秀的代码,《Effective Java》、《重构》 这两本书没事也可以看

并发

多线程这部分内容稍微会比较难以理解和实践。如果你刚学完 Java 基础的话,我建议你学习并发这部分内容的时候,可以先简单地了解一下基础知识比如线程和进程的对比。到了后面,你对于 Java 了解的更深了之后,再回来仔细看看这部分的内容。

下面是一些我比较推荐的书籍。

《Java 并发编程之美》
imgimg

这本书还是非常适合我们用来学习 Java 多线程的。这本书的讲解非常通俗易懂,作者从并发编程基础到实战都是信手拈来。

另外,这本书的作者加多自身也会经常在网上发布各种技术文章。这本书也是加多大佬这么多年在多线程领域的沉淀所得的结果吧!他书中的内容基本都是结合代码讲解,非常有说服力!

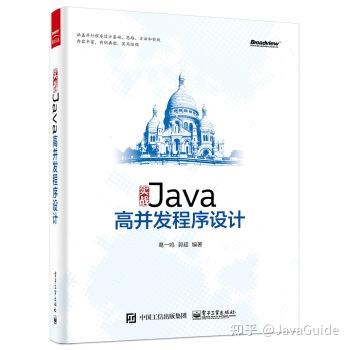
《实战 Java 高并发程序设计》
imgimg

这个是我第二本要推荐的书籍,比较适合作为多线程入门/进阶书籍来看。这本书内容同样是理论结合实战,对于每个知识点的讲解也比较通俗易懂,整体结构也比较清。

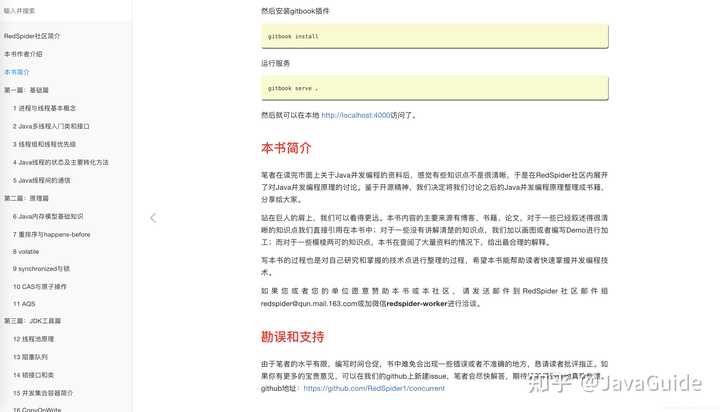
《深入浅出 Java 多线程》
imgimg

这本书是几位大厂的大佬开源的。

这几位作者为了写好《深入浅出 Java 多线程》这本书阅读了大量的 Java 多线程方面的书籍和博客,然后再加上他们的经验总结、Demo 实例、源码解析,最终才形成了这本书。

这本书的质量也是非常过硬!给作者们点个赞!这本书有统一的排版规则和语言风格、清晰的表达方式和逻辑。并且每篇文章初稿写完后,作者们就会互相审校,合并到主分支时所有成员会再次审校,最后再通篇修订了三遍。

《Java 并发实现原理:JDK 源码剖析》
imgimg

这本书是去年也就是 2020 年新出的,所以,现在知道的人还不是很多。

这本书主要是对 Java Concurrent 包中一些比较重要的源码进行了讲解,另外,像 JMM、happen-before、CAS 等等比较重要的并发知识这本书也都会一并介绍到。

不论是你想要深入研究 Java 并发,还是说要准备面试,你都可以看看这本书。

下面是我总结的一些关于并发的小问题,你可以拿来自测:

  1. 什么是线程和进程? 线程与进程的关系,区别及优缺点?
  2. 说说并发与并行的区别?
  3. 为什么要使用多线程呢?
  4. 使用多线程可能带来什么问题?(内存泄漏、死锁、线程不安全等等)
  5. 创建线程有哪几种方式?(a.继承 Thread 类;b.实现 Runnable 接口;c. 使用 Executor 框架;d.使用 FutureTask)
  6. 说说线程的生命周期和状态?
  7. 什么是上下文切换?
  8. 什么是线程死锁?如何避免死锁?
  9. 说说 sleep() 方法和 wait() 方法区别和共同点?
  10. Java 内存模型(JMM)、重排序与 happens-before 原则了解吗?
  11. synchronized 关键字、volatile 关键字
  12. ThreadLocal 有啥用(解决了什么问题)?怎么用?原理了解吗?内存泄露问题了解吗?
  13. 为什么要用线程池?ThreadPoolExecutor 类的重要参数了解吗?ThreadPoolExecutor 饱和策略了解吗?线程池原理了解吗?几种常见的线程池了解吗?为什么不推荐使用FixedThreadPool?如何设置线程池的大小?
  14. AQS 了解么?原理?AQS 常用组件:Semaphore (信号量)、CountDownLatch (倒计时器) CyclicBarrier(循环栅栏)
  15. ReentrantLock 、 ReentrantReadWriteLock 、StampedLock(JDK8)
  16. CAS 了解么?原理?
  17. Atomic 原子类
  18. 并发容器:ConcurrentHashMap 、 CopyOnWriteArrayList 、 ConcurrentLinkedQueue BlockingQueue 、ConcurrentSkipListMap
  19. Future 和 CompletableFuture
  20. ……

JVM

对于 Java 程序员来说,JVM 帮助我们做了很多事情比如内存管理、垃圾回收等等。在 JVM 的帮助下,我们的程序出现内存泄漏这些问题的概率相对来说是比较低的。但是,这并不代表我们在日常开发工作中不会遇到。万一你在工作中遇到了 OOM 问题,你至少要知道如何去排查和解决问题吧!

并且,就单纯从面试角度来说,JVM 是 Java 后端面试(大厂)中非常重要的一环。不论是应届还是社招,面试国内的一些大厂,你都会被问到很多 JVM 相关的问题(应届的话侧重理论,社招实践)。

只有搞懂了 JVM 才有可能真正把 Java 语言“吃透”。学习 JVM 这部分的内容,一定要注意要实战和理论结合。

书籍的话,**《深入理解 Java 虚拟机》** 这本书是首先要推荐的。
imgimg

这本书就一句话形容:国产书籍中的战斗机,实实在在的优秀! (真心希望国内能有更多这样的优质书籍出现!加油! )

这本书的第三版去年年底已经出来了,新增了很多实在的内容比如 ZGC 等新一代 GC 的原理剖析。目前豆瓣上是 9.6 的高分, 不 我就不多说了!

不论是你面试还是你想要在 Java 领域学习的更深,你都离不开这本书籍。这本书不光要看,你还要多看几遍,里面都是干货。这本书里面还有一些需要自己实践的东西,我建议你也跟着实践一下。

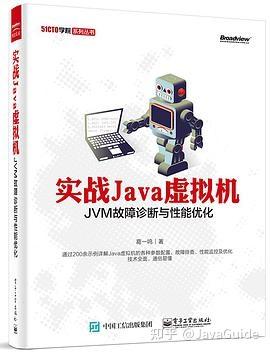
类似的书籍还有 《实战 Java 虚拟机》、《虚拟机设计与实现:以 JVM 为例》 ,这两本都是非常不错的!
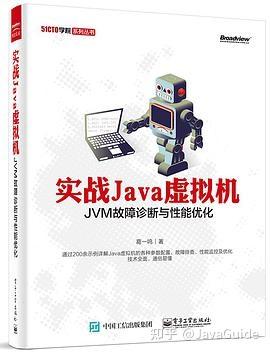
imgimg

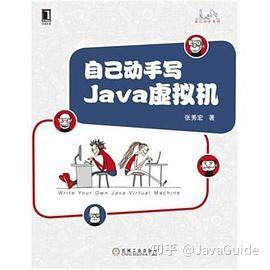
如果你对实战比较感兴趣,想要自己动手写一个简易的 JVM 的话,可以看看 《自己动手写 Java 虚拟机》 这本书。
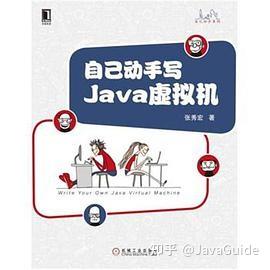
imgimg

书中的代码是基于 Go 语言实现的,搞懂了原理之后,你可以使用 Java 语言模仿着写一个,也算是练练手! 如果你当前没有能力独立使用 Java 语言模仿着写一个的话,你也可以在网上找到很多基于 Java 语言版本的实现,比如《zachaxy 的手写 JVM 系列》 。

这本书目前在豆瓣有 8.2 的评分,我个人觉得张秀宏老师写的挺好的,这本书值得更高的评分。

另外,R 大在豆瓣发的《从表到里学习 JVM 实现》这篇文章中也推荐了很多不错的 JVM 相关的书籍,推荐小伙伴们去看看。

再推荐两个视频给喜欢看视频学习的小伙伴。

第 1 个是尚硅谷的宋红康老师讲的《JVM 全套教程》。这个课程的内容非常硬,一共有接近 400 小节。

课程的内容分为 3 部分:

  1. 《内存与垃圾回收篇》
  2. 《字节码与类的加载篇》
  3. 《性能监控与调优篇》

imgimg

第 2 个是你假笨大佬的 《JVM 参数【Memory 篇】》 教程,很厉害了!
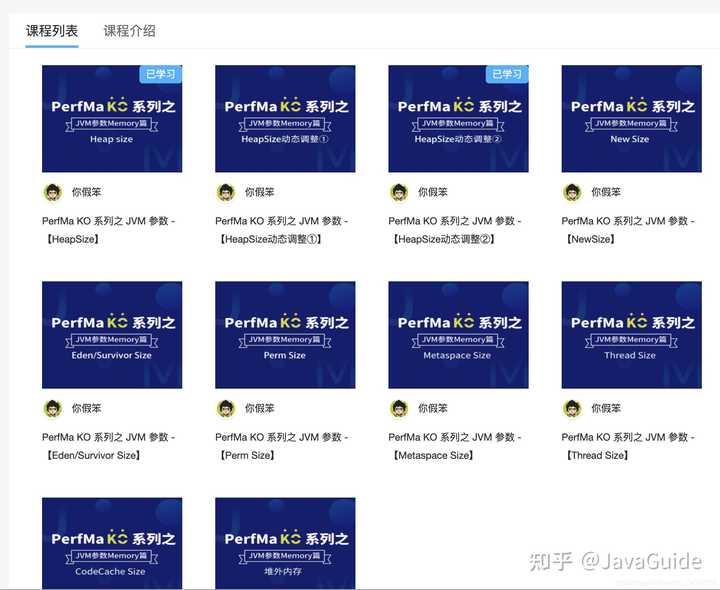
imgimg

下面是我总结的一些关于 JVM 的小问题,你可以拿来自测:

  1. 什么是虚拟机?
  2. Java 内存区域是怎么划分的?大对象放在哪个内存区域?
  3. 垃圾回收有哪些算法?GC 的流程
  4. 什么是类加载?何时类加载?类加载流程?
  5. 知道哪些类加载器。类加载器之间的关系?
  6. 类加载器的双亲委派了解么? 结合 Tomcat 说一下双亲委派(Tomcat 如何打破双亲委托机制?…)。
  7. 常见调优参数有哪些?
  8. ……

数据库

我们网站或 者 APP 的数据都是需要使用数据库来存储数据的。

MySQL

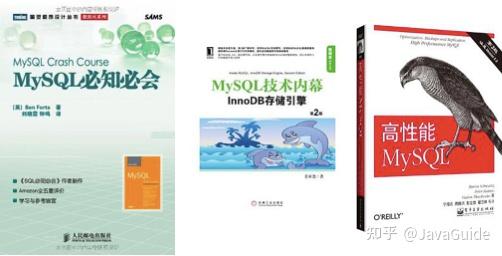
一般企业项目开发中,使用 MySQL 比较多。如果你要学习 MySQL 的话,可以看下面这 3 本书籍:

  • 《MySQL 必知必会》 :非常薄!非常适合 MySQL 新手阅读,很棒的入门教材。
  • 《高性能 MySQL》 : MySQL 领域的经典之作!学习 MySQL 必看!属于进阶内容,主要教你如何更好地使用 MySQL 。既有有理论,又有实践!如果你没时间都看一遍的话,拿我建议第 5 章(创建高性能的索引) 、第 6 章(查询性能优化) 你你一定要认真看一下。
  • 《MySQL 技术内幕》 :你想深入了解 MySQL 存储引擎的话,看这本书准没错!
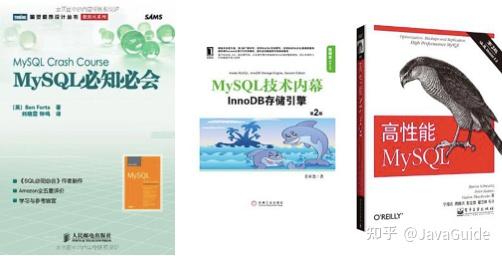
imgimg

视频的话,你可以看看动力节点的 《MySQL 数据库教程视频》。这个视频基本上把 MySQL 的相关一些入门知识给介绍完了。

学习了 MySQL 之后,务必确保自己掌握下面这些知识点:

  1. MySQL 常用命令 :
  • 安全:登录、增加/删除用户、备份数据和还原数据
  • 数据库操作: 建库建表/删库删表、用户权限分配
  • ……
  1. MySQL 中常用的数据类型、字符集编码
  2. MySQL 简单查询、条件查询、模糊查询、多表查询以及如何对查询结果排序、过滤、分组……
  3. MySQL 中使用索引、视图、存储过程、游标、触发器
  4. ……

如果你想让自己更加了解 MySQL ,同时也是为了准备面试的话,下面这些知识点要格外注意:

  1. 索引:索引优缺点、B 树和 B+树、聚集索引与非聚集索引、覆盖索引
  2. 事务:事务、数据库事务、ACID、并发事务、事务隔离级别
  3. 存储引擎(MyISAM 和 InnoDB)
  4. 锁机制与 InnoDB 锁算法

Redis

Redis 就是一个使用 C 语言开发的数据库,不过与传统数据库不同的是 Redis 的数据是存在内存中的 ,也就是它是内存数据库,所以读写速度非常快,因此 Redis 被广泛应用于缓存方向。

如果你要学习 Redis 的话,强烈推荐 《Redis 设计与实现》 和 《Redis 实战》 这两本书。另外,**《Redis 开发与运维》** 这本书也非常不错,既有基础介绍,又有一线开发运维经验分享。
imgimg

下面是我总结的一些关于并发的小问题,你可以拿来自测:

  1. Redis 和 Memcached 的区别和共同点
  2. 为什么要用 Redis/为什么要用缓存?
  3. Redis 常见数据结构以及使用场景分析
  4. Redis 没有使用多线程?为什么不使用多线程?Redis6.0 之后为何引入了多线程?
  5. Redis 给缓存数据设置过期时间有啥用?
  6. Redis 是如何判断数据是否过期的呢?
  7. 过期的数据的删除策略了解么?
  8. Redis 内存淘汰机制了解么?
  9. Redis 持久化机制(怎么保证 Redis 挂掉之后再重启数据可以进行恢复)
  10. Redis 缓存穿透、缓存雪崩?
  11. 如何保证缓存和数据库数据的一致性?
  12. ……

常用工具

非常重要!非常重要!特别是 Git 和 Docker。

除了下面这些工具之外,我强烈建议你一定要搞懂 Github 的使用。一些使用 Github 的小技巧,你可以看《Github 小技巧》这篇文章。

IDEA

俗话说:“工欲善其事,必先利其器 !”。选择一款好的开发工具对于我们高效率编码非常有帮助!

常用的 Java 开发工具就 Eclipse 和 IDEA。就我个人而言 IDEA 是最适合 Java 开发者的 IDE 。

建议你要熟悉 IDEA 的基本操作以及常用快捷。你可以通过 Github 上的开源教程 《IntelliJ IDEA 简体中文专题教程》 来学习 IDEA 的相关使用。

除了 IDEA 自身对编码优秀的支持(比如智能上下文提示)之外,IDEA 中还有丰富的插件来帮助我们高效开发。《IDEA 插件》 这个系列专辑中推荐了很多实用 IDEA 必备的插件!

Maven

强烈建议学习常用框架之前可以提前花几天时间学习一下Maven的使用。(到处找 Jar 包,下载 Jar 包是真的麻烦费事,使用 Maven 可以为你省很多事情)。

Git

Git 技能对于程序员来说也是必备的!试着在学习的过程中将自己的代码托管在 Github 上,有一个漂亮的 Github 主页在求职面试中是十分加分的。并且,现在的企业都是基于 Git 在 GitHub 或 GitLab 平台上做版本控制。

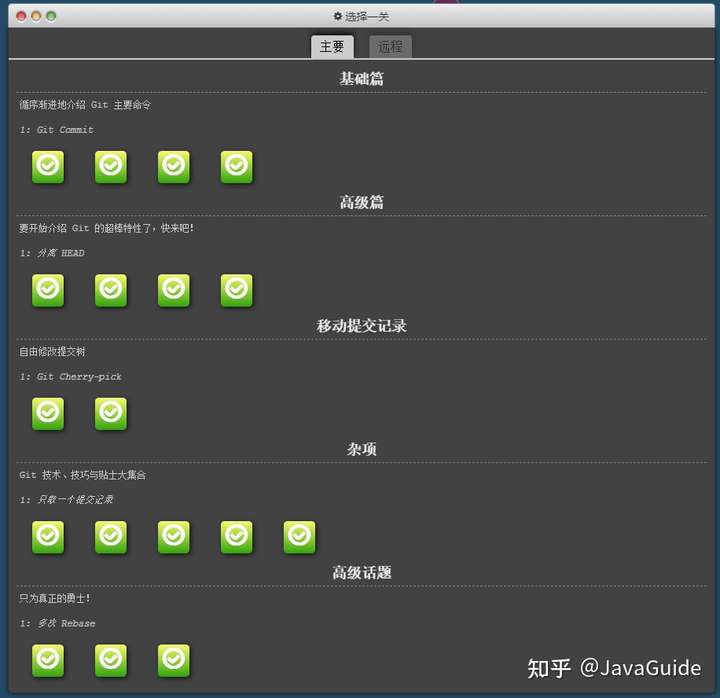
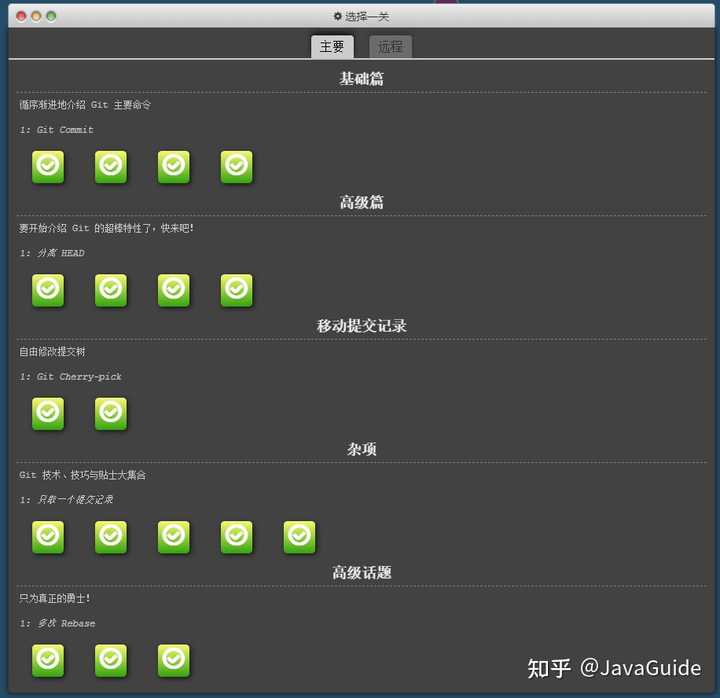
学习 Git 的话,强烈推荐给大家一个可以交互式学习 Git 的网站 Learn Git Branching。效果真的非常非常棒,通过游戏的方式让你学习 Git 的常见操作。

整个教程分为很多关,每一关都有非常详细的指导,还会有详细的动图展示结果。并且,你做错了之后还可以使用 reset 命令从头开始。
imgimg

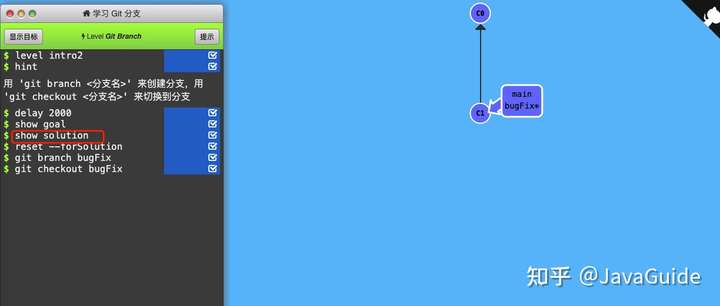
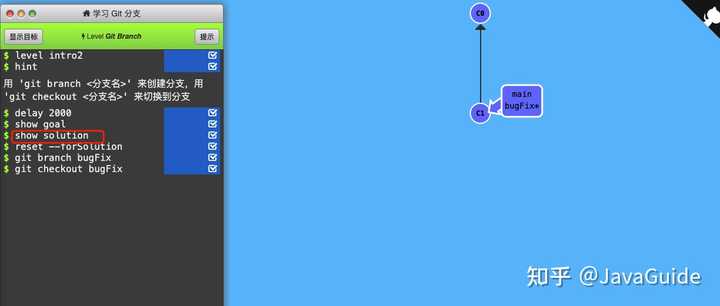
如果你是在不知道答案的话,还可以使用 show solution 命令查看答案。
imgimg

这种即时反馈的学习让过程变得有趣!真心感谢这个网站的作者,太爱了!

另外,你可以看看 Github 上开源的这篇 《Git 极简入门》 ,像版本控制和 Git 的相关概念、Git 常见操作这篇文章都有介绍到。

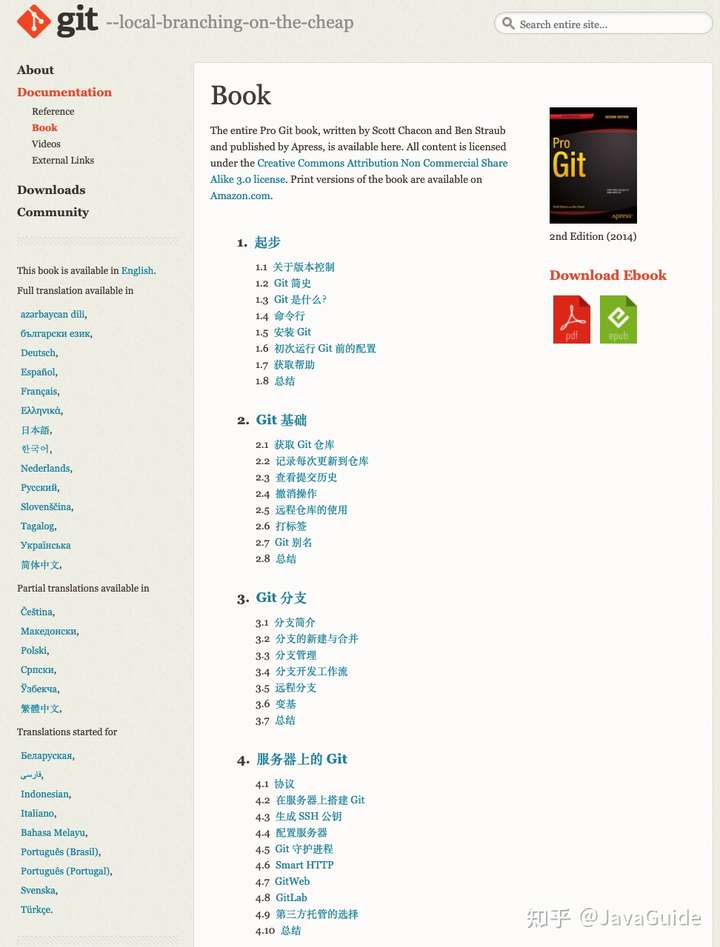
如果想要详细了解 Git 的话,Git 官方文档教程是肯定要看的,介绍的非常全面,并且有中文版!
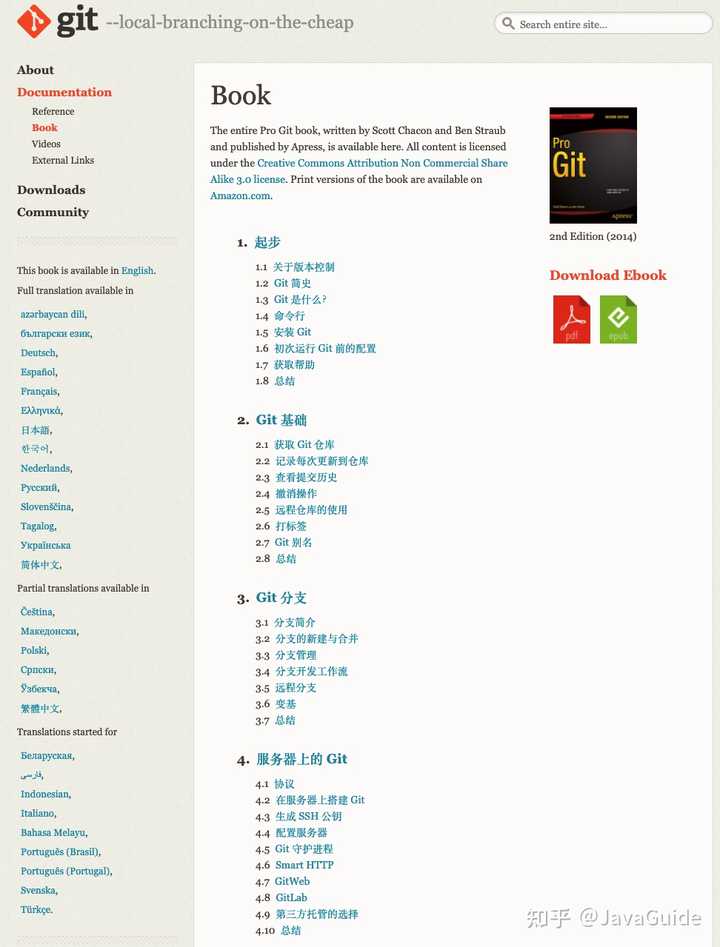
imgimg

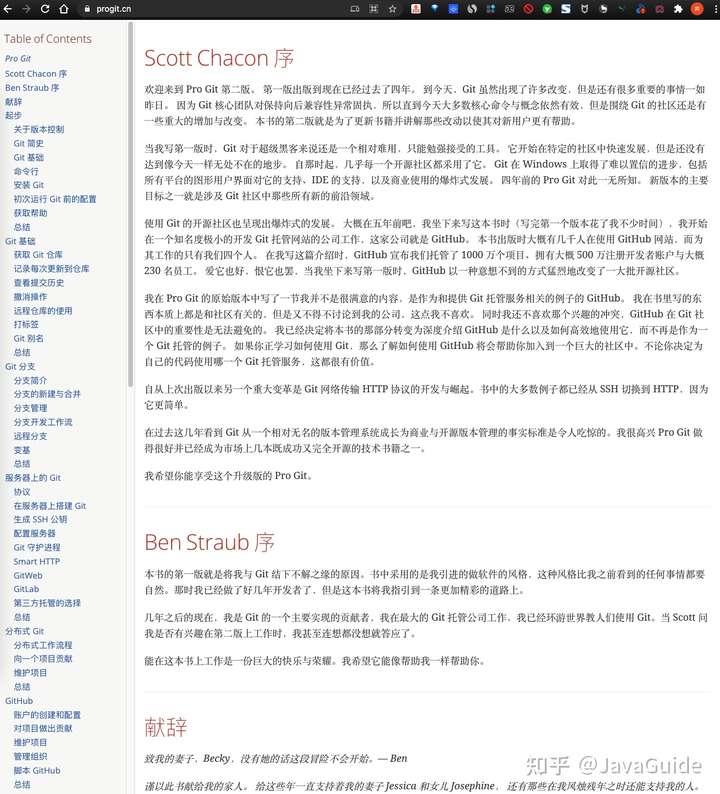
《Pro Git》这本书也非常不错,还有中文版,内容非常全面,硬核!
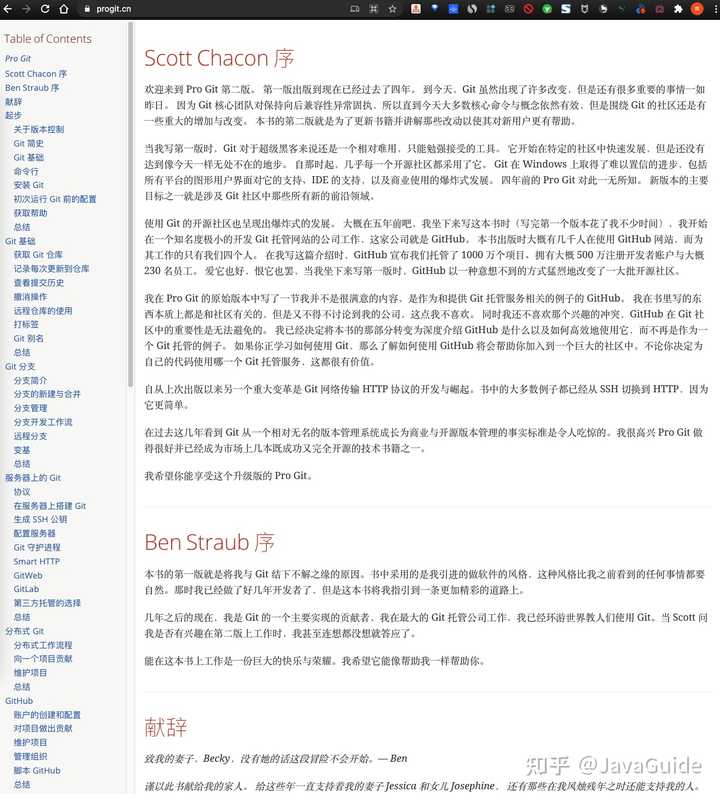
imgimg

imgimg

如果你比较喜欢看视频教程的话,可以看看极客时间的《玩转 Git 三剑客》,课程的作者是携程代码平台负责人苏玲,讲的挺不错的!

Docker

传统的开发流程中,我们的项目通常需要使用 MySQL、Redis、FastDFS 等等环境,这些环境都是需要我们手动去进行下载并配置的,安装配置流程极其复杂,而且不同系统下的操作也不一样。

Docker 的出现完美地解决了这一问题,我们可以在容器中安装 MySQL、Redis 等软件环境,使得应用和环境架构分开,它的优势在于:

  1. 一致的运行环境,能够更轻松地迁移
  2. 对进程进行封装隔离,容器与容器之间互不影响,更高效地利用系统资源
  3. 可以通过镜像复制多个一致的容器

Docker 常见概念解读,可以看这篇 Github 上开源的这篇《Docker 基本概念解读》 ,从零到上手实战可以看《Docker 从入门到上手干事》这篇文章,内容非常详细!

另外,再给大家推荐一本质量非常高的开源书籍《Docker 从入门到实践》 ,这本书的内容非常新,毕竟书籍的内容是开源的,可以随时改进。
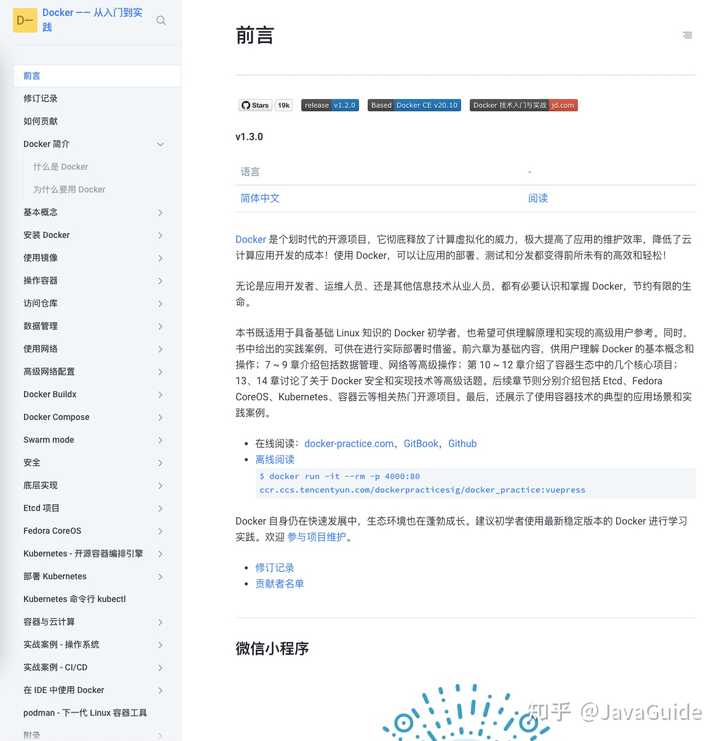
imgimg

常用框架

2021 最新Java实战项目源码打包下载t.1yb.co图标

Spring/SpringBoot

Spring 和 SpringBoot 真的很重要!

一定要搞懂 AOP 和 IOC 这两个概念。Spring 中 bean 的作用域与生命周期、SpringMVC 工作原理详解等等知识点都是非常重要的,一定要搞懂。

企业中做 Java 后端,你一定离不开 SpringBoot ,这个是必备的技能了!一定一定一定要学好!

像 SpringBoot 和一些常见技术的整合你也要知识怎么做,比如 SpringBoot 整合 MyBatis、 ElasticSearch、SpringSecurity、Redis 等等。

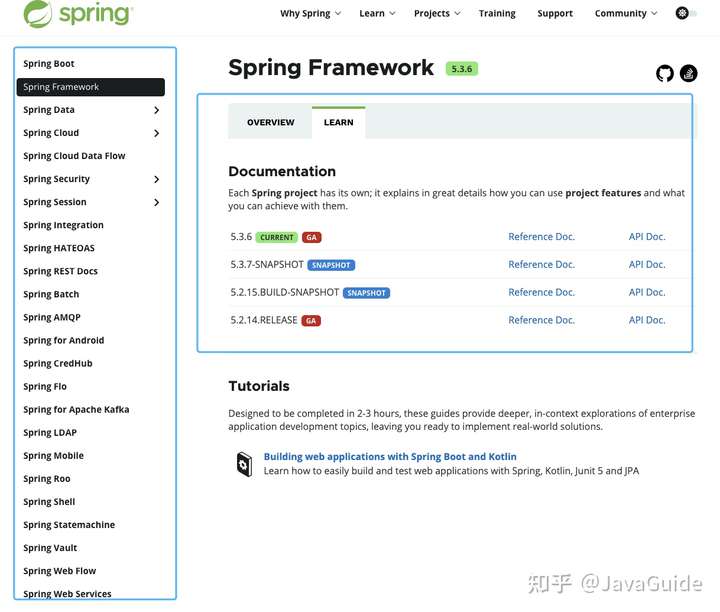
学习 Spring 的话,可以多看看 **《Spring 的官方文档》**,写的很详细。你可以在这里找到 Spring 全家桶的学习资源。
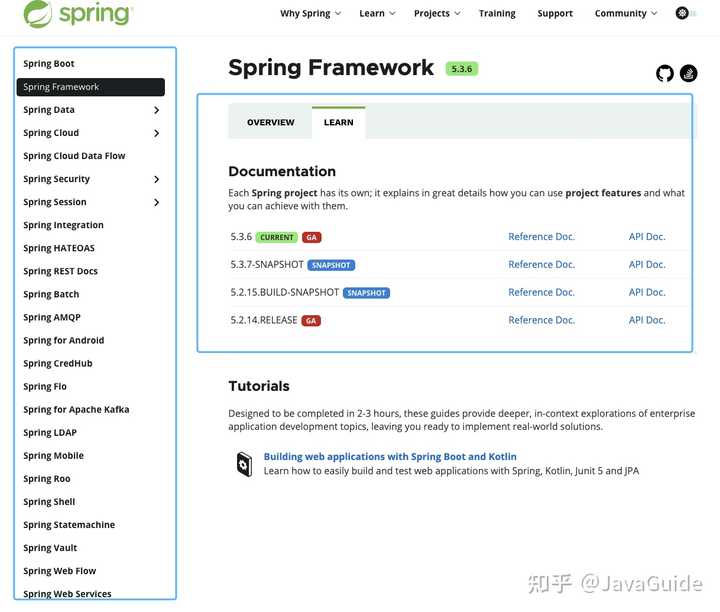
imgimg

你也可以把 《Spring 实战》 这本书作为学习 Spring 的参考资料。 这本书还是比较新的,目前已经出到了第 5 版,基于 Spring 5 来讲。
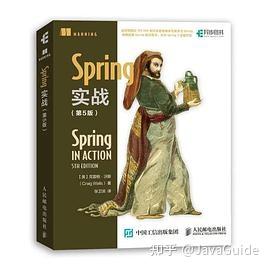
imgimg

了解了 Spring 中的一些常见概念和基本用法之后,你就可以开始学习 Spring Boot 了。

当然了,Spring 其实并不是学习 Spring Boot 的前置基础,相比于 Spring 来说,Spring Boot 要更容易上手一些!如果你只是想使用 Spring Boot 来做项目的话,直接学 Spring Boot 就可以了。

不过,我建议你在学习 Spring Boot 之前,可以看看 《Spring 常见问题总结》 。这些问题都是 Spring 比较重要的知识点,也是面试中经常会被问到的。

学习 Spring Boot 的话,还是建议可以多看看 **《Spring Boot 的官方文档》**,写的很详细。

你也可以把 《Spring Boot 实战》 这本书作为学习 Spring Boot 的参考资料。
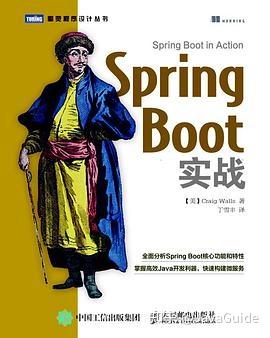
imgimg

这本书的整体质量实际一般,你当做参考书来看就好了!

相比于 《Spring Boot 实战》这本书,我更推荐国人写的 《Spring Boot 实战派》 。
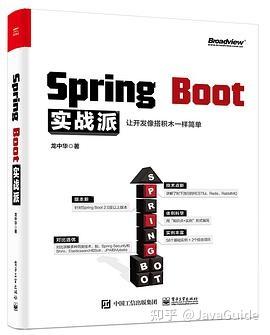
imgimg

这本书使用的 Spring Boot 2.0+的版本,还算比较新。整本书采用“知识点+实例”的形式编写,书籍的最后两章还有 2 个综合性的企业实战项目:

  • 开发企业级通用的后台系统
  • 实现一个类似“京东”的电子商务商城

作者在注意实战的过程中还不忘记对于一些重要的基础知识的讲解。

如果你想专研 Spring Boot 底层原理的话,可以看看 《Spring Boot 编程思想(核心篇)》 。
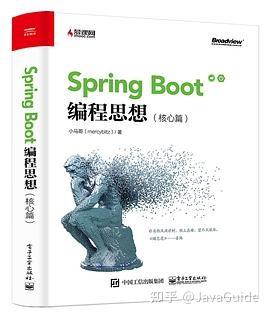
imgimg

这本书稍微有点啰嗦,不过,原理介绍的比较清楚(不适合初学者)。

如果你比较喜欢看视频的话,推荐尚硅谷雷神的**《2021 版 Spring Boot2 零基础入门》** 。
imgimg

这可能是全网质量最高并且免费的 Spring Boot 教程了,好评爆炸!

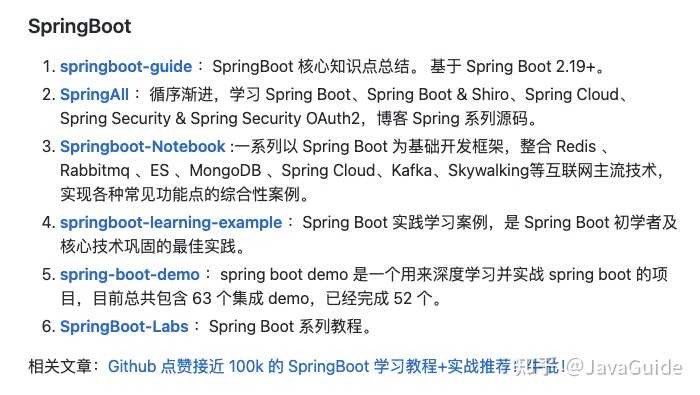
另外,Spring Boot 这块还有很多优质的开源教程,我已经整理好放到 awesome-java@SpringBoot 中了。
imgimg

Netty

但凡涉及到网络通信就必然必然离不开网络编程。 Netty 目前作为 Java 网络编程最热门的框架,毫不夸张地说是每个 Java 程序员必备的技能之一。

为什么说学好 Netty 很有必要呢?

  1. Netty 基于 NIO (NIO 是一种同步非阻塞的 I/O 模型,在 Java 1.4 中引入了 NIO )。使用 Netty 可以极大地简化并简化了 TCP 和 UDP 套接字服务器等网络编程,并且性能以及安全性等很多方面都非常优秀。
  2. 我们平常经常接触的 Dubbo、RocketMQ、Elasticsearch、gRPC、Spark、Elasticsearch 等等热门开源项目都用到了 Netty。
  3. 大部分微服务框架底层涉及到网络通信的部分都是基于 Netty 来做的,比如说 Spring Cloud 生态系统中的网关 Spring Cloud Gateway 。

下面是一些比较推荐的书籍/专栏。

《Netty 实战》
imgimg

这本书可以用来入门 Netty ,内容从 BIO 聊到了 NIO、之后才详细介绍为什么有 Netty 、Netty 为什么好用以及 Netty 重要的知识点讲解。

这本书基本把 Netty 一些重要的知识点都介绍到了,而且基本都是通过实战的形式讲解。

《Netty 进阶之路:跟着案例学 Netty》
imgimg

内容都是关于使用 Netty 的实践案例比如内存泄露这些东西。如果你觉得你的 Netty 已经完全入门了,并且你想要对 Netty 掌握的更深的话,推荐你看一下这本书。

《Netty 入门与实战:仿写微信 IM 即时通讯系统》
imgimg

通过一个基于 Netty 框架实现 IM 核心系统为引子,带你学习 Netty。整个小册的质量还是很高的,即使你没有 Netty 使用经验也能看懂。

搜索引擎

搜索引擎用于提高搜索效率,功能和浏览器搜索引擎类似。比较常见的搜索引擎是 Elasticsearch(推荐) 和 Solr。

如果你要学习 Elasticsearch 的话,Elastic 中文社区 以及 Elastic 官方博客 都是非常不错的资源,上面会分享很多具体的实践案例。

除此之外,极客时间的《Elasticsearch 核心技术与实战》这门课程非常赞!这门课基于 Elasticsearch 7.1 版本讲解,比较新。并且,作者是 eBay 资深技术专家,有 20 年的行业经验,课程质量有保障!
imgimg

如果你想看书的话,可以考虑一下 《Elasticsearch 实战》 这本书。不过,需要说明的是,这本书中的 Elasticsearch 版本比较老,你可以将其作为一个参考书籍来看,有一些原理性的东西可以在上面找找答案。
imgimg

如果你想进一步深入研究 Elasticsearch 原理的话,可以看看张超老师的《Elasticsearch 源码解析与优化实战》这本书。这是市面上唯一一本写 Elasticsearch 源码的书。
imgimg

分布式

下面我们开始学习分布式以及高并发、高可用了。

这块内容的话,对于每一个知识点没有特定的书籍。我就推荐 2 本我觉得还不错的书籍吧!这两把书籍基本把下面涉及到的知识点给涵盖了。

第一本是李运华老师的**《从零开始学架构》** 。
imgimg

这本书对应的有一个极客时间的专栏—《从零开始学架构》,里面的很多内容都是这个专栏里面的,两者买其一就可以了。

第二本是余老师的 《软件架构设计:大型网站技术架构与业务架构融合之道》 。
imgimg

事务与锁、分布式(CAP、分布式事务……)、高并发、高可用这本书都有介绍到。值得推荐!良心好书!

理论

CAP 理论

CAP 也就是 Consistency(一致性)、Availability(可用性)、Partition Tolerance(分区容错性) 这三个单词首字母组合。

关于 CAP 的详细解读请看:《CAP 理论解读》。

BASE 理论

BASE 是 Basically Available(基本可用) 、Soft-state(软状态) 和 Eventually Consistent(最终一致性) 三个短语的缩写。BASE 理论是对 CAP 中一致性和可用性权衡的结果,其来源于对大规模互联网系统分布式实践的总结,是基于 CAP 定理逐步演化而来的,它大大降低了我们对系统的要求。

关于 CAP 的详细解读请看:《BASE 理论解读》。

Paxos 算法和 Raft 算法

Paxos 算法诞生于 1990 年,这是一种解决分布式系统一致性的经典算法 。但是,由于 Paxos 算法非常难以理解和实现,不断有人尝试简化这一算法。到了 2013 年才诞生了一个比 Paxos 算法更易理解和实现的分布式一致性算法—Raft 算法。

RPC

RPC 让调用远程服务调用像调用本地方法那样简单。

Dubbo 是一款国产的 RPC 框架,由阿里开源。相关阅读:

服务注册与发现

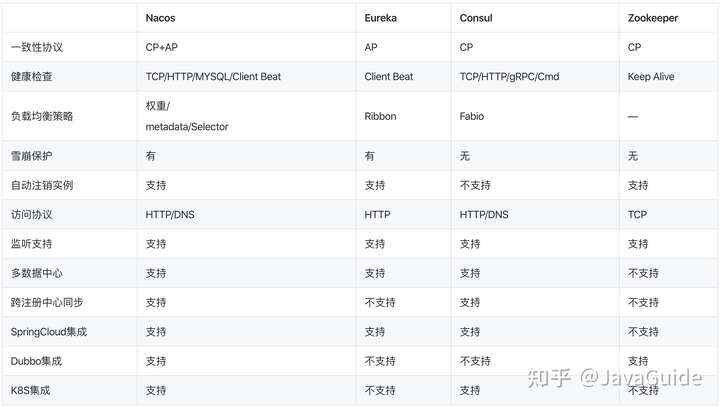
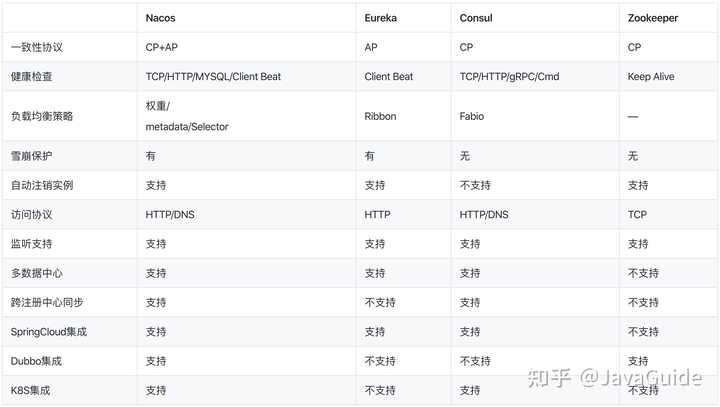
Eureka、Zookeeper、Consul、Nacos 都可以提供服务注册与发现的功能。
imgimg

API 网关

网关主要用于请求转发、安全认证、协议转换、容灾。

SpringCloud Gateway 是 Spring Cloud 的一个全新项目,为了取代 Netflix Zuul。

配置中心

微服务下,业务的发展一般会导致服务数量的增加,进而导致程序配置(服务地址、数据库参数等等)增多。

传统的配置文件的方式已经无法满足当前需求,主要有两点原因:一是安全性得不到保障(配置放在代码库中容易泄露);二是时效性不行 (修改配置需要重启服务才能生效)。

Spring Cloud Config、Nacos 、Apollo、K8s ConfigMap 都可以用来做配置中心。

Apollo 和 Nacos 我个人更喜欢。Nacos 使用起来更加顺手,Apollo 在配置管理方面做的更加全面。

分布式 id

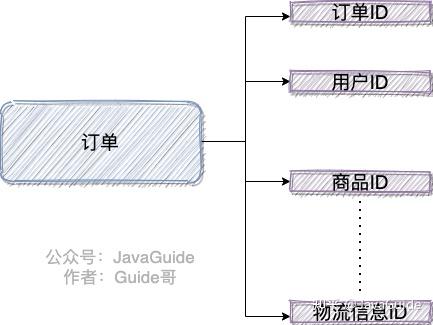
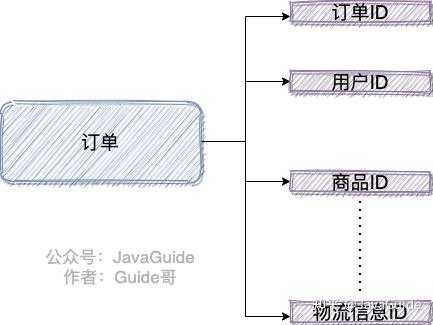
日常开发中,我们需要对系统中的各种数据使用 ID 唯一表示,比如用户 ID 对应且仅对应一个人,商品 ID 对应且仅对应一件商品,订单 ID 对应且仅对应一个订单。
imgimg

简单来说,ID 就是数据的唯一标识。

分布式 ID 是分布式系统下的 ID。分布式 ID 不存在与现实生活中,属于计算机系统中的一个概念。

我简单举一个分库分表的例子。

我司的一个项目,使用的是单机 MySQL 。但是,没想到的是,项目上线一个月之后,随着使用人数越来越多,整个系统的数据量将越来越大。

单机 MySQL 已经没办法支撑了,需要进行分库分表(推荐 Sharding-JDBC)。

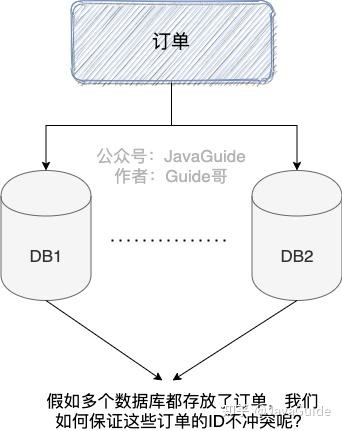
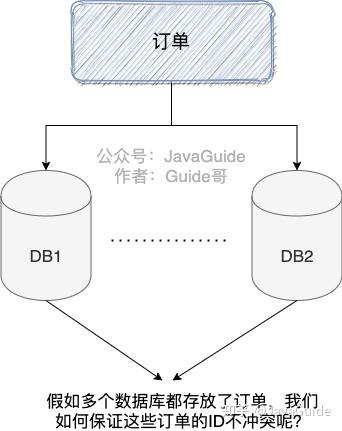
在分库之后, 数据遍布在不同服务器上的数据库,数据库的自增主键已经没办法满足生成的主键唯一了。我们如何为不同的数据节点生成全局唯一主键呢?
imgimg

这个时候就需要生成分布式 ID了。

分布式 ID 的解决方案有很多比如 :

  • 算法 :UUID、Snowflake
  • 开源框架 : UidGenerator、Leaf 、Tinyid

分布式事务

微服务架构下,一个系统被拆分为多个小的微服务。

每个微服务都可能存在不同的机器上,并且每个微服务可能都有一个单独的数据库供自己使用。这种情况下,一组操作可能会涉及到多个微服务以及多个数据库。

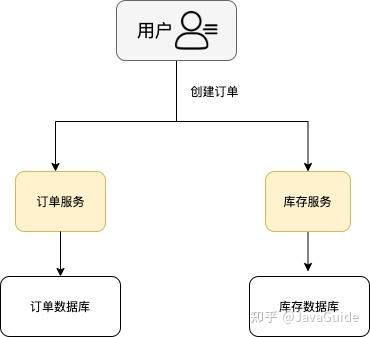
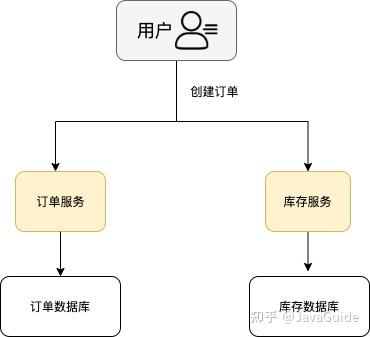
举个例子:电商系统中,你创建一个订单往往会涉及到订单服务(订单数加一)、库存服务(库存减一)等等服务,这些服务会有供自己单独使用的数据库。
imgimg

那么如何保证这一组操作要么都执行成功,要么都执行失败呢?

这个时候单单依靠数据库事务就不行了!我们就需要引入 分布式事务 这个概念了!

常用分布式事务解决方案有 Seata 和 Hmily。

  1. Seata :Seata 是一款开源的分布式事务解决方案,致力于在微服务架构下提供高性能和简单易用的分布式事务服务。
  2. Hmily : 金融级分布式事务解决方案

分布式链路追踪

不同于单体架构,在分布式架构下,请求需要在多个服务之间调用,排查问题会非常麻烦。我们需要分布式链路追踪系统来解决这个痛点。

目前分布式链路追踪系统基本都是根据谷歌的《Dapper 大规模分布式系统的跟踪系统》这篇论文发展而来,主流的有 Pinpoint,Skywalking ,CAT(当然也有其他的例如 Zipkin,Jaeger 等产品,不过总体来说不如前面选取的 3 个完成度高)等。

Zipkin 是 Twitter 公司开源的一个分布式链路追踪工具,Spring Cloud Sleuth 实际是基于 Zipkin 的。

SkyWalking 是国人吴晟(华为)开源的一款分布式追踪,分析,告警的工具,现在是 Apache 旗下开源项目

微服务

微服务的很多东西实际在分布式这一节已经提到了。

我这里就再补充一些微服务架构中,经常使用到的一些组件。

  • 声明式服务调用 : Feign
  • 负载均衡 : Ribbon
  • ……

高并发

消息队列

imgimg

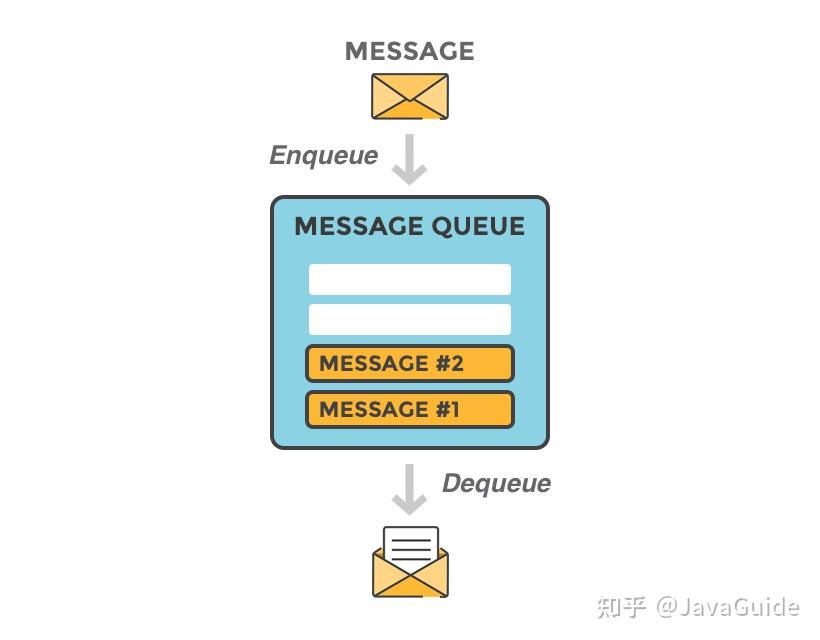
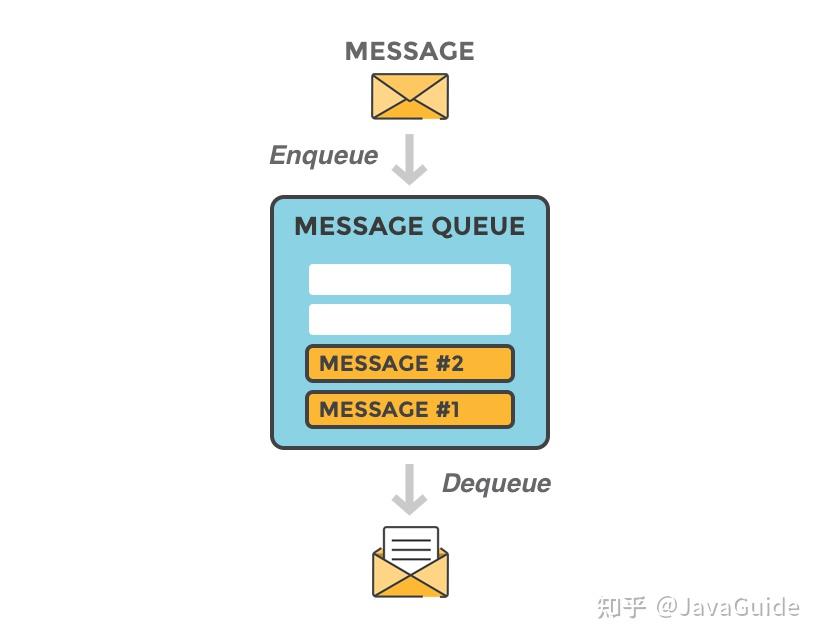
消息队列在分布式系统中主要是为了解耦和削峰。相关阅读:消息队列常见问题总结。

常用的消息队列如下:

  1. RocketMQ :阿里巴巴开源的一款高性能、高吞吐量的分布式消息中间件。
  2. Kafaka: Kafka 是一种分布式的,基于发布 / 订阅的消息系统。关于它的入门可以查看:Kafka 入门看这一篇就够了
  3. RabbitMQ :由 erlang 开发的基于 AMQP(Advanced Message Queue 高级消息队列协议)协议实现的消息队列。

读写分离&分库分表

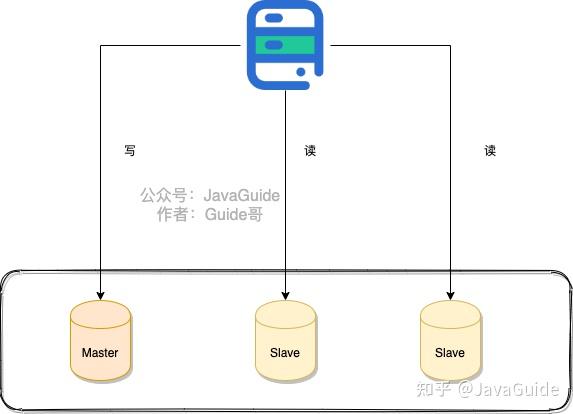
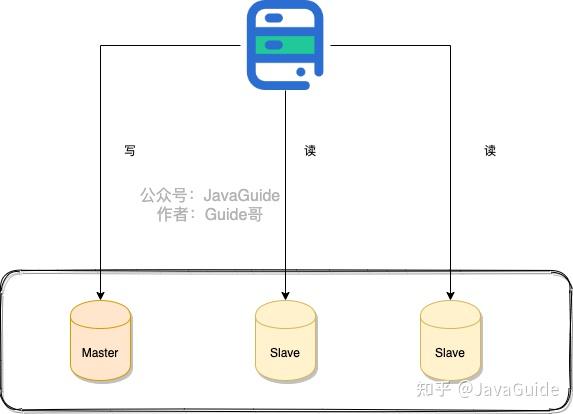
读写分离主要是为了将数据库的读和写操作分不到不同的数据库节点上。主服务器负责写,从服务器负责读。另外,一主一从或者一主多从都可以。

读写分离可以大幅提高读性能,小幅提高写的性能。因此,读写分离更适合单机并发读请求比较多的场景。
imgimg

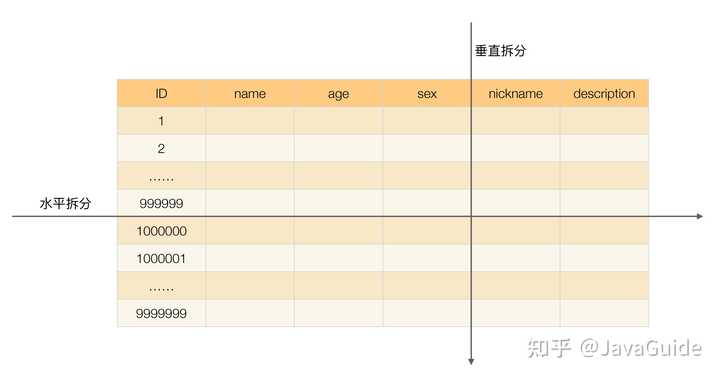
分库分表是为了解决由于库、表数据量过大,而导致数据库性能持续下降的问题。

常见的分库分表工具有:sharding-jdbc(当当)、TSharding(蘑菇街)、MyCAT(基于 Cobar)、Cobar(阿里巴巴)…。 推荐使用 sharding-jdbc。 因为,sharding-jdbc 是一款轻量级 Java 框架,以 jar 包形式提供服务,不要我们做额外的运维工作,并且兼容性也很好。
imgimg

相关阅读: 读写分离&分库分表常见问题总结

负载均衡

负载均衡系统通常用于将任务比如用户请求处理分配到多个服务器处理以提高网站、应用或者数据库的性能和可靠性。

常见的负载均衡系统包括 3 种:

  1. DNS 负载均衡 :一般用来实现地理级别的均衡。
  2. 硬件负载均衡 : 通过单独的硬件设备比如 F5 来实现负载均衡功能(硬件的价格一般很贵)。
  3. 软件负载均衡 :通过负载均衡软件比如 Nginx 来实现负载均衡功能。

高可用

高可用描述的是一个系统在大部分时间都是可用的,可以为我们提供服务的。高可用代表系统即使在发生硬件故障或者系统升级的时候,服务仍然是可用的 。

相关阅读: 《如何设计一个高可用系统?要考虑哪些地方?》 。

限流&降级&熔断

限流是从用户访问压力的角度来考虑如何应对系统故障。限流为了对服务端的接口接受请求的频率进行限制,防止服务挂掉。比如某一接口的请求限制为 100 个每秒, 对超过限制的请求放弃处理或者放到队列中等待处理。限流可以有效应对突发请求过多。相关阅读:限流算法有哪些?

降级是从系统功能优先级的角度考虑如何应对系统故障。服务降级指的是当服务器压力剧增的情况下,根据当前业务情况及流量对一些服务和页面有策略的降级,以此释放服务器资源以保证核心任务的正常运行。

熔断和降级是两个比较容易混淆的概念,两者的含义并不相同。

降级的目的在于应对系统自身的故障,而熔断的目的在于应对当前系统依赖的外部系统或者第三方系统的故障。

Hystrix 和 Sentinel 都能实现限流、降级、熔断。

Hystrix 是 Netflix 开源的熔断降级组件,Sentinel 是阿里中间件团队开源的一款不光具有熔断降级功能,同时还支持系统负载保护的组件。

两者都是主要做熔断降级 ,那么两者到底有啥异同呢?该如何选择呢?

Sentinel 的 wiki 中已经详细描述了其与 Hystrix 的区别,你可以看看。

排队

另类的一种限流,类比于现实世界的排队。玩过英雄联盟的小伙伴应该有体会,每次一有活动,就要经历一波排队才能进入游戏。

集群

相同的服务部署多份,避免单点故障。

超时和重试机制

一旦用户的请求超过某个时间得不到响应就结束此次请求并抛出异常。 如果不进行超时设置可能会导致请求响应速度慢,甚至导致请求堆积进而让系统无法在处理请求。

另外,重试的次数一般设为 3 次,再多次的重试没有好处,反而会加重服务器压力(部分场景使用失败重试机制会不太适合)。
l

jvm调优

一、优化系统的思路

没有jvm调优经历

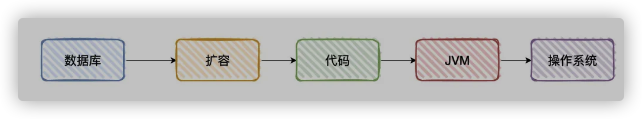
  1. 一般来说关系型数据库是先到瓶颈,首先排查是否为数据库的问题
    (这个过程中就需要评估自己建的索引是否合理、是否需要引入分布式缓存、是否需要分库分表等等
  2. 然后,我们会考虑是否需要扩容(横向和纵向都会考虑)
    (这个过程中我们会怀疑是系统的压力过大或者是系统的硬件能力不足导致系统频繁出现问题)
  3. 接着,应用代码层面上排查并优化
    (扩容是不能无止境的,里头里外都是钱阿,这个过程中我们会审视自己写的代码是否存在资源浪费的问题,又或者是在逻辑上可存在优化的地方,比如说通过并行的方式处理某些请求)
  4. 再接着,JVM层面上排查并优化
    (审视完代码之后,这个过程我们观察J VM是否存在多次GC问题等等)
  5. 最后,网络和操作系统层面排查
    (这个过程查看内存/CPU/网络/硬盘读写指标是否正常等等)

绝大多数情况下,到第三步就结束了,一般经过「运维团队」给我们设置的JVM和机器上的参数,已经满足绝大多数的需求了。

二、举例子

之前有过其他团队在「大促」发现接口处理超时的问题,那时候查各种监控怀疑是FULLGC频率稍大所导致的

  1. 第一想法不是说去调节各种JVM参数来进行优化,而是直接加机器(用最粗暴的方法,解决问题是最简单的,扩容YYDS)
  2. 不过,我是学过JVM相关的调优命令和思路的。
    在我的理解下,调优JVM其实就是在「理解」JVM内存结构以及各种垃圾收集器前提下,结合自己的现有的业务来「调整参数」,使自己的应用能够正常稳定运行。
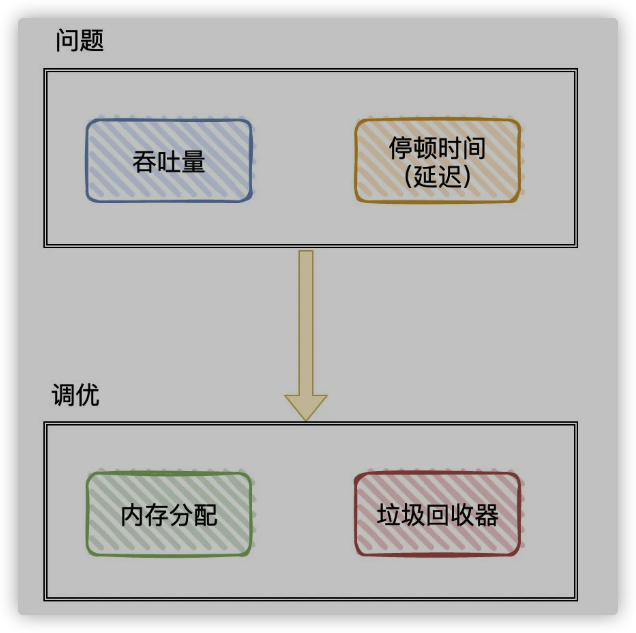
    • 一般调优JVM我们认为会有几种指标可以参考:「吞吐量」、「停顿时间」和「垃圾回收频率」
    • 基于这些指标,我们就有可能需要调整:
      1. 内存区域大小以及相关策略(比如整块堆内存占多少、新生代占多少、老年代占多少、Survivor占多少、晋升老年代的条件等等)
        比如(-Xmx:设置堆的最大值、-Xms:设置堆的初始值、-Xmn:表示年轻代的大小、-XX:SurvivorRatio:伊甸区和幸存区的比例等等)
        按经验来说:I0密集型的可以稍微把「年轻代」空间加大些,因为大多数对象都是在年轻代就会灭亡。内存计算密集型的可以稍微把「老年代」空间加大些,对象存活时间会更长些)
      2. 垃圾回收器(选择合适的垃圾回收器,以及各个垃圾回收器的各种调优参数)
        比如(-XX:+UseG1GC:指定JVM使用的垃圾回收器为G1、-XX:MaxGCPause Millis:设置目标停顿时间、-XX:InitiatingHeapOccupancyPercent:当整个堆内存使用达到一定比例,全局并发标记阶段就会被启动等等)
        没错,这些都是因地制宜,具体问题具体分析(前提是得懂JVM的各种基础知识,基础知识都不懂,谈何调优)
        在大多数场景下,JVM已经能够达到「开箱即用」

三、调优工具

一般我们是「遇到问题」之后才进行调优的,而遇到问题后需要利用各种的 「工具」 进行排查

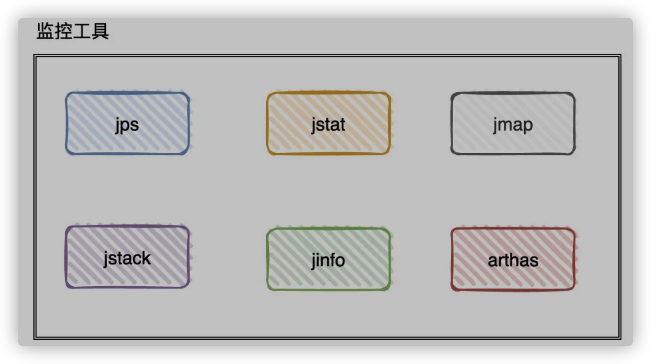
  1. 通过jps命令查看Java进程「基础」信息(进程号、主类)。这个命令很常用的就是用来看当前服务器有多少Java进程在运行,它们的进程号和加载主类是啥
  2. 通过jstat命令查看Java进程「统计类」相关的信息(类加载、编译相关信息统计,各个内存区域GC概况和统计)。这个命令很常用于看GC的情况
  3. 通过jinfo命令来查看和调整Java进程的「运行参数」
  4. 通过jmap命令来查看Java进程的「内存信息」。这个命令很常用于把JVM内存信息dump到文件,然后再用MAT(Memory Analyzer tool内存解析工具)把文件进行分析
  5. 通过jstack命令来查看JVM「线程信息」。这个命令用常用语排查死锁相关的问题
  6. 还有近期比较热门的Arthas(阿里开源的诊断工具),涵盖了上面很多命令的功能且自带图形化界面。这也是我这边常用的排查和分析工具

四、jvm的jit优化技术

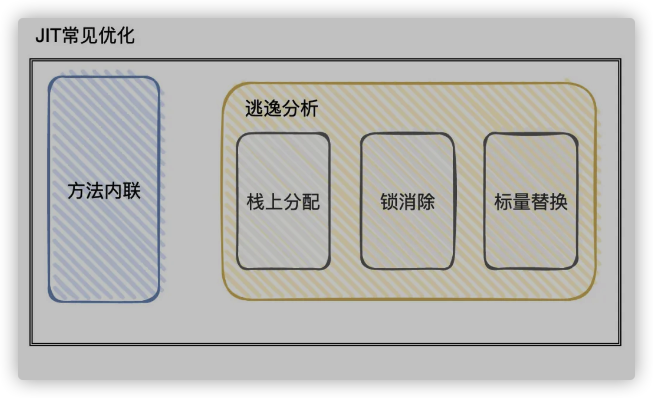
JIT优化技术比较出名的有两种:方法内联和逃逸分析

  1. 所谓方法内联就是把「目标方法」的代码复制到「调用的方法」中,避免发生真实的方法调用因为每次方法调用都会生成栈帧(压栈出栈记录方法调用位置等等)会带来一定的性能损耗,所以「方法内联」的优化可以提高一定的性能
    在JVM中也有相关的参数给予我们指定 (-XX:MaxFreqlnlineSize、 -XX:MaxInli neSize等等)
  2. 而「逃逸分析」则是判断一个对象是否被外部方法引用或外部线程访问的分析技术,如果「没有被引用」,就可以对其进行优化
    下面我举几个可优化的例子(思路):
    • 1.锁消除(同步忽略):该对象只在方法内部被访问,不会被别的地方引用,那么就一定是线程安全的,可以把锁相关的代码给忽略掉0
    • 2.栈上分配:该对象只会在方法内部被访问,直接将对象分配在「栈」中(Java默认是将对象分配在「堆」中,是需要通过JVM垃圾回收期进行回收,需要损耗一定的性能,而栈内分配则快很多)
    • 3.标量替换/分离对象:当程序真正执行的时候可以不创建这个对象,而直接创建它的成员变量来代替。将对象拆分后,可以分配对象的成员变量在栈或寄存器上,原本的对象就无需分配内存空间了

不过扯了这么多,不同的JVM版本对JIT的优化都不太相同

这里也只能算是一个参考

线上在使用的JVM也不知道有没有做了这么些优化.

l

使用java8实现List中对象属性的去重

今天在工作的时候遇到了一个问题,就是List的去重,不想用双重for,感觉太low,不想用for+Map,感觉应该有更好的方法,于是,google之。发现java8的stream流能完美解决这个问题。

1
List<BookInfoVo> list

比如在 BookInfoVo 中有一个 recordId 属性,现在需要对此去重.

怎么办呢?

有两种方法:

  • 第一种: 不使用java8 的 Stream
    1
    2
    3
    4
    5
    private List<BookInfoVo> removeDupliByRecordId(List<BookInfoVo> books) {
    Set<BookInfoVo> bookSet = new TreeSet<>((o1, o2)->o1.getRecordId().compareTo(o2.getRecordId()));
    personSet.addAll(books);
    return new ArrayList<BookInfoVo>(bookSet);
    }
    这也是大多数人第一想到的,借助 TreeSet 去重,其中 TreeSet 的其中一个构造函数接收一个排序的算法,同时这也会用到 TreeSet 的去重策略上.
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    /**
    * Constructs a new, empty tree set, sorted according to the specified
    * comparator. All elements inserted into the set must be <i>mutually
    * comparable</i> by the specified comparator: {@code comparator.compare(e1,
    * e2)} must not throw a {@code ClassCastException} for any elements
    * {@code e1} and {@code e2} in the set. If the user attempts to add
    * an element to the set that violates this constraint, the
    * {@code add} call will throw a {@code ClassCastException}.
    *
    * @param comparator the comparator that will be used to order this set.
    * If {@code null}, the {@linkplain Comparable natural
    * ordering} of the elements will be used.
    */
    public TreeSet(Comparator<? super E> comparator) {
    this(new TreeMap<>(comparator));
    }
  • 第二种: 炫酷的java8写法]
    1
    2
    3
    4
    5
    6
    /*方法二:炫酷的java8写法*/
    ArrayList<BookInfoVo> distinctLiost = list.stream()
    .collect(
    Collectors.collectingAndThen(
    Collectors.toCollection(() -> new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))), ArrayList::new)
    );
    当然也可以根据多个属性去重
    1
    2
    ArrayList<BookInfoVo> distinctLiost = list.stream().collect(Collectors.collectingAndThen(
    Collectors.toCollection(() -> new TreeSet<>(Comparator.comparing(o -> o.getName() + ";" + o.getAuthor()))), ArrayList::new)
    如果没有第一种方法做铺垫,我们很可能一脸懵逼.

其实理解起来也不难:

关键在于Collectors.collectingAndThen( Collectors.toCollection(() -> new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))), ArrayList::new)的理解,

collectingAndThen 这个方法的意思是: 将收集的结果转换为另一种类型: collectingAndThen,

因此上面的方法可以理解为,把 new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))这个set转换为 ArrayList,这个结合第一种方法不难理解.

可以看到java8这种写法真是炫酷又强大!!!

l

双亲委派机制

一、双亲委派机制

  1. class文件是通过类加载器加载到jvm中的

  2. 为了防止内存中存在多份同样的字节码,使用了双亲委派机制(不会自己加载类,而是把请求委托给父加载器去完成,依次向上)

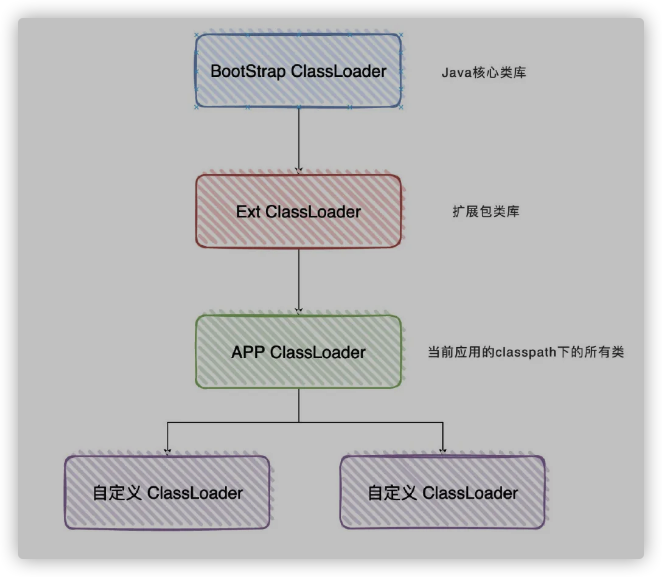
  3. jdk本地方法类一般有根加载器(BootStrap Loader) 装载,jdk内部实现的扩展类一般由扩展加载器(ExtClassLoader),程序中的类文件则有系统加载器(AppClassLoader)装载

二、如何打破双亲委派机制

  1. 只要我加载类的时候,不是从AppClassLoader→ExtClassLoader→BootStrap Loader这个顺序找,那就是打破了。
  2. 因为加载class核心的方法在LoaderClass类的loadClass()方法上(双亲委派机制的核心实现上)
  3. 只要我自定义个ClassLoader,重写loadClass方法(不依照往上开始寻找类加载器),那就算是打破双亲委派机制了。

三、破坏双亲委派机制的场景

  1. tomcat:初学部署项目时,我们是把war包放到tomcat的webapp下,意味着tomcat可以运行多个web应用程序
  2. 那假设我现在有2个web应用程序,都有一个类,叫做User,并且它们的类全限定名都一样,比如:都是com.xxxxx.User。但是它们的具体实现是不一样的
  3. 那么tomcat是如何保证它们不会冲突的呢?
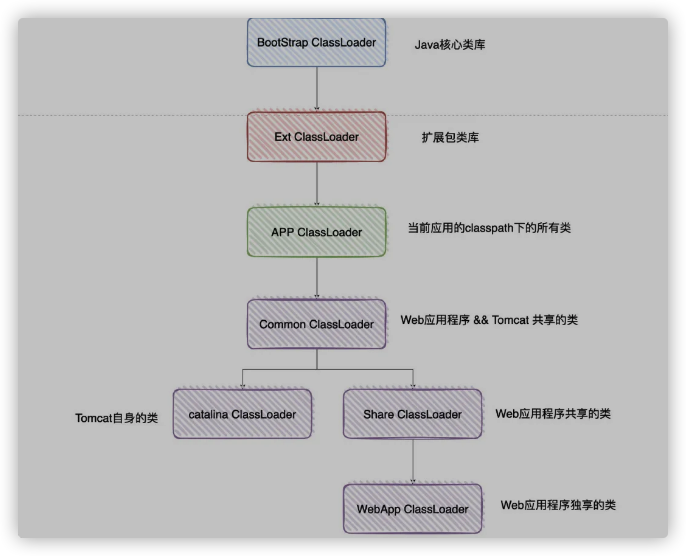
  4. 答案就是:tomcat给每个web应用创建了一个类加载器实例(WebAppClassLoader),该加载器重写了loadClass方法,优先加载当前应用目录下的类,如果当前找不到,才一层一层往上找。这样就做到了web应用层级的隔离。

四、tomcat还有别的类加载器吗

  1. 并不是web应用下的所有依赖都是需要隔离的,比如redis就是可以web应用之间共享的

  2. 因为如果版本相同,没必要每个web应用都独自加载一份

  3. 做法很简单,tomcat就在WebAppClassLoader上加了个父类加载器(SharedClassLoader),如果WebAppClassLoader自身没有加载到某个类,那就委托ShaerClassLoader去加载。(无非就是把需要应用程序之间需要共享的类放到一个共享目录下,SharedClassLoader)读共享目录的类就好了

  4. 为了隔离web应用与tomcat本身的类,又有类加载器(CatalinaClassLoader)来装载tomcat本身的依赖

  5. 如果tomcat本身的类的依赖和web应用还需要共享,那么还有类加载器(CommonClassLoader)来装载进而达到共享

  6. 各个类加载器的加载目录可以到tomcat的catalina.properties配置文件上查看

五、jdbc

  1. 有没有破坏双亲委派机制,见仁见智
  2. jdbc定义类接口,具体实现类由各个厂商进行实现(比如Mysql)
  3. 类加载有个规则:如果一个类由类加载器A加载,那么这个类的依赖类也是有相同的类加载器加载
  4. 我们用jdbc的时候,是使用DriverManager进而获取Connection,DriverManager在java.sql包下,显然是有BootStrap类加载器进行装载
  5. 当我们使用DriverManager.getConnection()时,得到的是一定是厂商实现的类
  6. 但BootStrap 加载器显然不可以加载各个厂商实现的类,这些实现类又没在java包中,怎么可能加载到呢
  7. DriverManager的解决方案是:在DriverManager初始化时,得到上下文加载器,去获取Connection时,是使用上下文加载器去加载Connection的,而这里的线程上下文加载器实际上还是(AppClassLoader)
  8. 在获取Connection的时候,还是先找到ExtClassLoader和B o o t S t ra p C la s sLoader,只不过这两加载器肯定是加载不到的,最终会有AppClassLoader进行加载
  9. 那这种情况,有的人觉得破坏了双亲委派机制,因为本来明明应该是有BootStrapClassLoader进行加载的,结果你来了一手线程上下文加载器,改掉了类加载器
  10. 有的人觉得没破坏双亲委派机制,只是改成了由线程上下文加载器进行类加载,但是还是遵守依次往上找父类加载,都找不到时才由自身加载。认为原则上没有改变。
  11. 我觉得这不重要,重要的是弄懂底层原理
l

java8类型互转

List< Integer >、int[ ]、Integer[ ]相互转换

[toc]

下文中出现的list、ints、integers分别代表一个列表、一个int数组、一个Integer数组。
它们之间所谓的转化,其实是 复制数据,互不干扰,可以理解为深拷贝。

int[ ] 转 List< Integer >

1
List<Integer> list = Arrays.stream(ints).boxed().collect(Collectors.toList());

Arrays.stream(ints) 之后返回的类型是 IntStream,IntStream 是一个接口继承自 BaseStream,BaseStream 又继承自AutoCloseable。所以我把IntStream看成一个方便对每个整数做操作的数据流。

之后调用了 boxed(),它的作用是对每个整数进行装箱,基本类型流转换为对象流,返回的是 Stream,Stream 也是继承自 BaseStream。所以这一步的作用是把 IntStream 转换成了 Stream。

最后通过collect方法将数据流 (Stream) 收集成了集合 ( List),这里 collect 方法里传入的是一个收集器 (Collector),它通过 Collectors.toList() 产生。

小结:

  1. Arrays.stream(ints) 将基本类型数组转换为基本类型流。 int[ ] => IntStream
  2. .boxed() 将基本类型流转换为对象流。 => Stream< Integer >
  3. .collect(Collectors.toList()) 将对象流收集为集合。 => List< Integer >

int[ ] [ ] 转 List< List < Integer > >

1
2
String temp = Arrays.deepToString(fooArr).replaceAll("\\[","").replaceAll("\\]","");
List<String> fooList = new ArrayList<>(Arrays.asList(",")); //不对
1
List<List<Integer>> collect2 = Arrays.Stream(ints1).map(ar -> Arrays.stream(ar).boxed().collect(Collectors.toList())).collect(Collectors.toList());

int[ ] 转 Integer[ ]

1
Integer[] integers = Arrays.stream(ints).boxed().toArray(Integer[]::new);

一样的内容就不重复了,toArray(T[ ] :: new) 方法返回基本类型数组。
小结:

  1. Arrays.stream(ints) 将基本类型数组转换为基本类型流。 int[ ] => IntStream
  2. .boxed() 将基本类型流转换为对象流。=> Stream< Integer >
  3. .toArray(Integer[ ]::new) 将对象流转换为对象数组。=> Integer[ ]

int[ ] [ ]转 Integer[ ] [ ]

1
Integer[][] integers3 = Arrays.stream(ints1).map(ints -> Arrays.stream(ints).boxed().toArray(Integer[]::new)).toArray(Integer[][]::new);

Integer[ ] 转 List< Integer >

1
List<Integer> list = Arrays.asList(integers);

这个就很简单了,通过Arrays类里的asList方法将数组装换为List。值得注意:

asList 返回的是 Arrays 里的静态私有类 ArrayList,而不是 java.util 里的 ArrayList,它无法自动扩容。

可以用下面2种方法生成可扩容的ArrayList:

1
List<Integer> list = new ArrayList<>(Arrays.asList(integers)); 

或者

1
2
List<Integer> list = new ArrayList<>(); 
Collections.addAll(list, integers);

Integer[ ] [ ]转 List< List < Integer > >

1
2
Integer[][] a = {{1,2,3},{1,2,3}};
List<List<Integer>> lists = Arrays.stream(a).map(Arrays::asList).collect(Collectors.toList());

Integer[ ] 转 int[ ]

1
int[] ints = Arrays.stream(integers).mapToInt(Integer::valueOf).toArray();

map的意思是把每一个元素进行同样的操作。mapToInt的意思是把每一个元素转换为int。mapToInt(Integer::valueOf)方法返回的是IntStream。
小结:

  1. Arrays.stream(integers) 将对象数组转换为对象流。 Integer[ ] => Stream< Integer >
  2. .mapToInt(Integer::valueOf) 将对象流转换成基本类型流。=> IntStream
  3. .toArray() 将基本类型流转换为基本类型数组。 => int[ ]

Integer[ ] [ ]转 int[ ] [ ]

1
2
Integer[][] a = {{1,2,3},{1,2,3}};      
int[][] ints1 = Arrays.stream(a).map(a1 -> Arrays.stream(a1).mapToInt(Integer::valueOf).toArray()).toArray(int[][]::new);

List< Integer > 转 int[ ]

1
int[] ints = list.stream().mapToInt(Integer::valueOf).toArray();

经过上面的说明,相信这里已经很好理解了,直接小结。
小结:

  1. list.stream() 将列表转换为对象流。List< Integer > => Stream< Integer >
  2. .mapToInt(Integer::valueOf) 将对象流转换为基本数据类型流。=> IntStream
  3. .toArray() 将基本数据类型流转换为基本类型数组。=>int[ ]

List< List < Integer > > 转 int[ ] [ ]

1
2
3
4
List<List<Integer>> lists = ...;
int[][] arrays = lists.stream() // Stream<List<Integer>>
.map(list -> list.stream().mapToInt(i -> i).toArray()) // Stream<int[]>
.toArray(int[][]::new);

List< Integer > 转 Integer[ ]

1
Integer[] integers = list.toArray(new Integer[list.size()]);
1
Integer[] integers = list.stream().toArray(Integer[]::new); //不推荐

这个也很简单,方法里的参数是一个数组,所以要规定长度。也有无参的方法,但是要进行转型,所以不推荐使用。

List< List < Integer > > 转 Integer[ ] [ ]

1
2
3
4
List<List<Integer>> lists = ...;
Integer[][] arrays = lists.stream() // Stream<List<Integer>>
.map(list -> list.toArray(new Integer[list.size()])) // Stream<Integer[]>
.toArray(Integer[][]::new);
1
2
3
Integer[][] arrays = lists.stream()                                // Stream<List<Integer>>
.map(l -> l.stream().toArray(String[]::new)) // Stream<Integer[]>
.toArray(Integer[][]::new);
1
Integer[][] arrays = lists.stream().map(List::toArray).toArray(Integer[][]::new);

List< Character >、char[ ]、Character[ ]相互转换

char[ ] 转 List< Character >

1
2
char[] chars = {'a', 'b', 'c'};
List<Character> collect = new String(chars).chars().mapToObj(i -> (char) i).collect(Collectors.toList());

char[ ] [ ] 转 List< List < Character > >

1
List<List<Character>> collect2 = Arrays.stream(ints1).map(chars1 -> new String(chars1).chars().mapToObj(i -> (char) i).collect(Collectors.toList())).collect(Collectors.toList());

char[ ] 转 Character[ ]

1
2
char[] chars = {'a', 'b', 'c'};
Character[] characters1 = new String(chars).chars().mapToObj(i -> (char) i).toArray(Character[]::new);

char[ ] [ ]转 Character[ ] [ ]

1
Character[][] integers3 = Arrays.stream(ints1).map(chars -> new String(chars).chars().mapToObj(i->(char)i).toArray(Character[]::new)).toArray(Character[][]::new);

Character[ ] 转 List< Character >

1
List<Character> collect2 = Arrays.stream(characters).collect(Collectors.toList());

Character[ ] [ ]转 List< List < Character > >

1
List<List<Character>> lists = Arrays.stream(a).map(Arrays::asList).collect(Collectors.toList());

Character[ ] 转 char[ ]

1
2
char[] chars4 = Arrays.stream(characters1).map(String::valueOf).collect(Collectors.joining()).toCharArray();

Character[ ] [ ]转 char[ ] [ ]

1
char[][] ints1 = Arrays.stream(a).map(a1 -> Arrays.stream(a1).map(String::valueOf).collect(Collectors.joining()).toCharArray()).toArray(char[][]::new);

List< Character > 转 char[ ]

1
char[] value = characters.stream().map(String::valueOf).collect(Collectors.joining()).toCharArray();
1
2
Character[] charArr = characters.toArray(new Character[characters.size()]);
char[] value = ArrayUtils.toPrimitive(charArr);

List< List < Character > > 转 char[ ] [ ]

1
2
3
char[][] arrays = lists.stream()                                // Stream<List<Integer>>
.map(list -> list.stream().map(String::valueOf).collect(Collectors.joining()).toCharArray()) // Stream<int[]>
.toArray(char[][]::new);

List< Character > 转 Character[ ]

1
Character[] characters2 = Arrays.stream(characters1).toArray(Character[]::new);

List< List < Character > > 转 Character[ ] [ ]

1
2
Character[][] integers1 = lists.stream()                                // Stream<List<Integer>>
.map(list -> list.toArray(new Character[list.size()])).toArray(Character[][]::new);
1
2
3
Character[][] integers2 = lists.stream()                                // Stream<List<Integer>>
.map(l -> l.stream().toArray(Character[]::new))
.toArray(Character[][]::new);
1
Character[][] integers = lists.stream().map(List::toArray).toArray(Character[][]::new);
l

线程与进程

一、进程

  1. 计算机内存空间

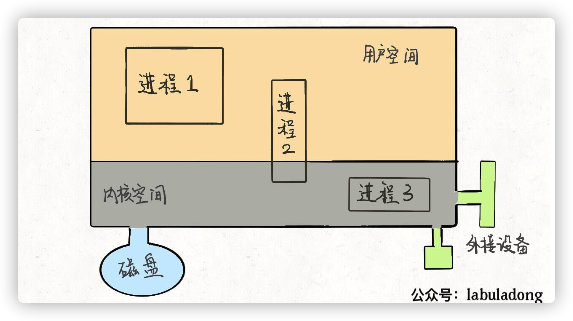
​ 用户空间装着用户进程需要使用的资源,比如你在程序代码里开一个数组, 这个数组肯定存在用户空间;内核空间存放内核进程需要加载的系统资源, 这一些资源一般是不允许用户访问的。但是注意有的用户进程会共享一些内 核空间的资源,比如一些动态链接库等等。

  1. 对于操作系统,进程就是一个数据结构,直接看 Linux 的源码:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    struct task_struct {
    // 进程状态
    long state;
    // 虚拟内存结构体
    struct mm_struct *mm;
    // 进程号
    pid_t pid;
    // 指向父进程的指针
    struct task_struct __rcu *parent;
    // 一个数组,包含该进程打开的文件指针
    struct files_struct *files;
    };

    ​ 其中比较有意思的是 mm 指针和 files 指针。

    ​ mm 指针指向:进程的虚拟内存,也就是载入资源和可执行文件的地方;

    ​ files 指针指向:一个数组,这个数组里装着所有该进程打开的文件的指针。

二、文件描述符

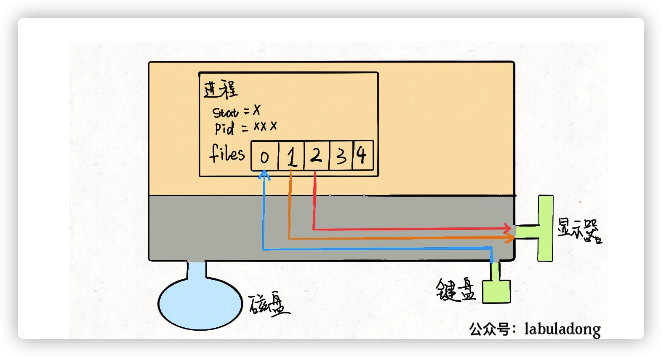
​ 每个进程被创建时, files 的前三位被填入默认值,分别指向标准输入 流、标准输出流、标准错误流。我们常说的「文件描述符」就是指这个文件 指针数组的索引(0,1,2),所以程序的文件描述符默认情况下 0 是输入,1 是输出, 2 是错误。

​ linux一切皆文件,对于一般的计算机,输入流是键盘,输出流是显示器,错误流也是显示器, 所以现在这个进程和内核连了三根线。因为硬件都是由内核管理的,我们的 进程需要通过「系统调用」让内核进程访问硬件资源。

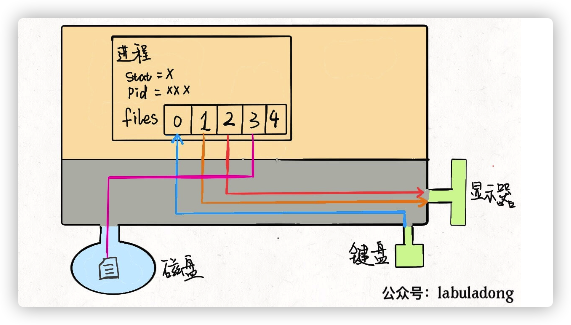
​ 如果我们写的程序需要其他资源,比如打开一个文件进行读写,这也很简 单,进行系统调用,让内核把文件打开,这个文件就会被放到 files 的第 4 个位置:

输入重定向:command < file.txt,file[0]指向file.txt,程序从file[0]读取数据

输出重定向:command > file.txt,file[1]指向file.txt, 程序像file[1]写入数据

管道符:cmd1 | cmd2 把一个进程的输出流和另一个进程的输入流接起 一条「管道」,数据就在其中传递

注意:一个简单的 files 数组,进程通过简单的文件描述符访问相应资源, 具体细节交于操作系统,有效解耦,优美高效。

三、线程是什么

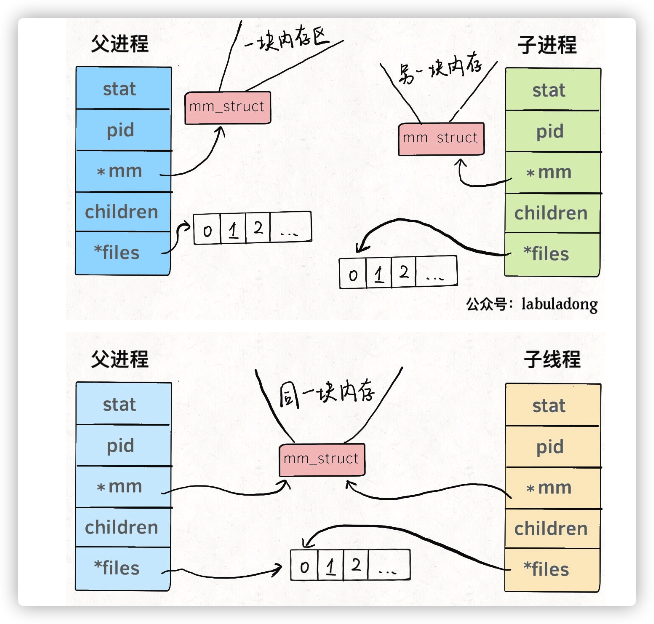
​ 之所以Linux 中线程和进程基本没有区别呢,因为从 Linux 内核的角度来看,并没有把线程和进程区别对待。都是用 task_struct 结构表示的,唯一的 区别就是共享的数据区域不同。

​ 换句话说,线程看起来跟进程没有区别,只是线程的某些数据区域和其父进 程是共享的,而子进程是拷⻉副本,而不是共享。就比如说, mm 结构 和 files 结构在线程中都是共享的,我画两张图你就明白了:

注意:对于新建进程时内存区域拷 ⻉的问题,Linux 采用了 copy-on-write 的策略优化,也就是并不真正复制父 进程的内存空间,而是等到需要写操作时才去复制。所以 Linux 中新建进 程和新建线程都是很迅速的。

l

注释书写规范

  • 一般情况下,源程序有效注释量必须在30%以上。注释的原则是有助于对程序的阅读理解,在该加的地方都加了,注释不宜太多也不能太少,注释语言必须准确、易懂、简洁。可以用注释统计工具来统计。

    一、类和接口的注释

1. 类外注释

该注释放在 package 关键字之后,class 或者 interface 关键字之前。

  • 说明:方便JavaDoc收集。
    示例:
1
2
3
4
5
package com.huawei.msg.relay.comm;
/**
* 注释内容
*/
public class CommManager
  • 类和接口的注释内容:类的注释主要是一句话功能简述、功能详细描述。
    格式:
    1
    2
    3
    4
    /**
    * 〈一句话功能简述〉
    * 〈功能详细描述〉
    */
  • 描述部分说明该类或者接口的功能、作用、使用方法和注意事项。
    示例:
    1
    2
    3
    4
    5
    /**
    * LogManager 类集中控制对日志读写的操作。
    * 全部为静态变量和静态方法,对外提供统一接口。分配对应日志类型的读写器,
    * 读取或写入符合条件的日志纪录。
    */

2. 类内注释

类属性、公有和保护方法必须写注释。geter、seter方法不用写注释

示例:

1
2
3
4
5
6
7
8
/**
* 注释内容
*/
private String logType;
/**
* 注释内容
*/
public void write()

1).成员变量注释内容:成员变量的意义、目的、功能,可能被用到的地方。
2).公有和保护方法注释内容:列出方法的一句话功能 简述、功能详细描述、输入参数、输出参数、返回值、违例等。
格式:

1
2
3
4
5
6
7
8
/**
* 〈一句话功能简述〉
* 〈功能详细描述〉
* @param [参数1] [in或out] [参数1说明]
* @param [参数2] [in或out] [参数2说明]
* @return [返回类型说明]
* @exception/throws [违例类型] [违例说明]
*/

说明: @exception或throws 列出可能仍出的异常。
示例:

1
2
3
4
5
6
7
/**
* 用MD5算法计算输入字符串的32位摘要
* @param sIn [in] 待处理的字符串
* @param sOut [out] sIn的32为摘要,调用函数负责new sOut对象
* @return boolean
*/
public static boolean getMd5(String sIn, StringBuffer sOut)

说明:
1).注释应与其描述的代码相近,对代码的注释应放在其上方或右方(对单条语句的注释)相邻位置,不可放在下面,如放于上方则需与其上面的代码用空行隔开。
2).注释与所描述内容进行同样的缩排。
3).将注释与其上面的代码用空行隔开。
示例:

1
2
3
4
5
//注释
program code one
(空一格)
//注释
program code two

二、方法与复杂逻辑的注释

对变量的定义和分支语句(条件分支、循环语句等)对复杂的分支必须编写注释,如果时间允许,建议对所有分支语句写注释。

说明:这些语句往往是程序实现某一特定功能的关键,对于维护人员来说,良好的注释帮助更好的理解程序,有时甚至优于看设计文档。

  1. switch语句
  • switch语句下的case语句,如果因为特殊情况需要处理完一个case后进入下一个case处理,必须在该case语句处理完、下一个case语句前加上明确的注释。
  • 说明:这样比较清楚程序编写者的意图,有效防止无故遗漏break语句。
  1. 边写代码边注释
  • 修改代码同时修改相应的注释,以保证注释与代码的一致性。不再有用的注释要删除。
  1. 避免在注释中使用缩写
  • 在使用缩写时或之前,应对缩写进行必要的说明,特别是不常用缩写。
  1. 用中文注释,禁止用英文写注释。

    建议

  2. 避免在一行代码或表达式的中间插入注释。
  • 说明:除非必要,不应在代码或表达中间插入注释,否则容易使代码可理解性变差。
  1. 通过对函数或过程、变量、结构等正确的命名以及合理地组织代码的结构,使代码成为自注释的。
  • 说明:清晰准确的函数、变量等的命名,可增加代码可读性,并减少不必要的注释。
  1. 在代码的功能、意图层次上进行注释,提供有用、额外的信息。
  • 说明:注释的目的是解释代码的目的、功能和采用的方法,提供代码以外的信息,帮助读者理解代码,防止没必要的重复注释信息。
  • 示例:如下注释意义不大。
    1
    2
    // 如果 receiveFlag 为真
    if (receiveFlag)
  • 而如下的注释则给出了额外有用的信息。
    1
    2
    // 如果从连结收到消息 
    if (receiveFlag)
  1. 在程序块的结束行右方加注释标记,以表明某程序块的结束。
  • 说明:当代码段较长,特别是多重嵌套时,这样做可以使代码更清晰,更便于阅读。
  • 示例:参见如下例子。
    1
    2
    3
    4
    5
    6
    7
    8
    if (...)
    {
    program code1
    while (index < MAX_INDEX)
    {
    program code2
    } // end of while (index < MAX_INDEX) // 指明该条while语句结束
    } // end of if (...) // 指明是哪条if语句结束
  1. 方法内的单行注释使用 //。
  • 说明:调试程序的时候可以方便的使用 /* 。。。*/ 注释掉一长段程序。
  1. 注释使用中文注释和中文标点,不得用英文写注释。方法和类描述的第一句话尽量使用简洁明了的话概括一下功能,然后加以句号。接下来的部分可以详细描述。
  • 说明:JavaDoc工具收集简介的时候使用选取第一句话。
  1. 顺序实现流程的说明使用1、2、3、4在每个实现步骤部分的代码前面进行注释。
  • 示例:如下是对设置属性的流程注释
    1
    2
    3
    4
    //1、 判断输入参数是否有效。
    ...
    // 2、设置本地变量。
    ...
  1. 一些复杂的算法代码需要说明。
  • 示例:这里主要是对闰年算法的说明。
    java //1. 如果能被4整除,是闰年; //2. 如果能被100整除,不是闰年.; //3. 如果能被400整除,是闰年.。 星期五, 23. 八月 2019 07:42下午

**


**

l

面试官:说说你了解class文件吗?

本文思维导图:

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/2rLXEs_20210507091957.png

Class类文件结构

为什么Java可以一次编译到处运行?JVM无关性

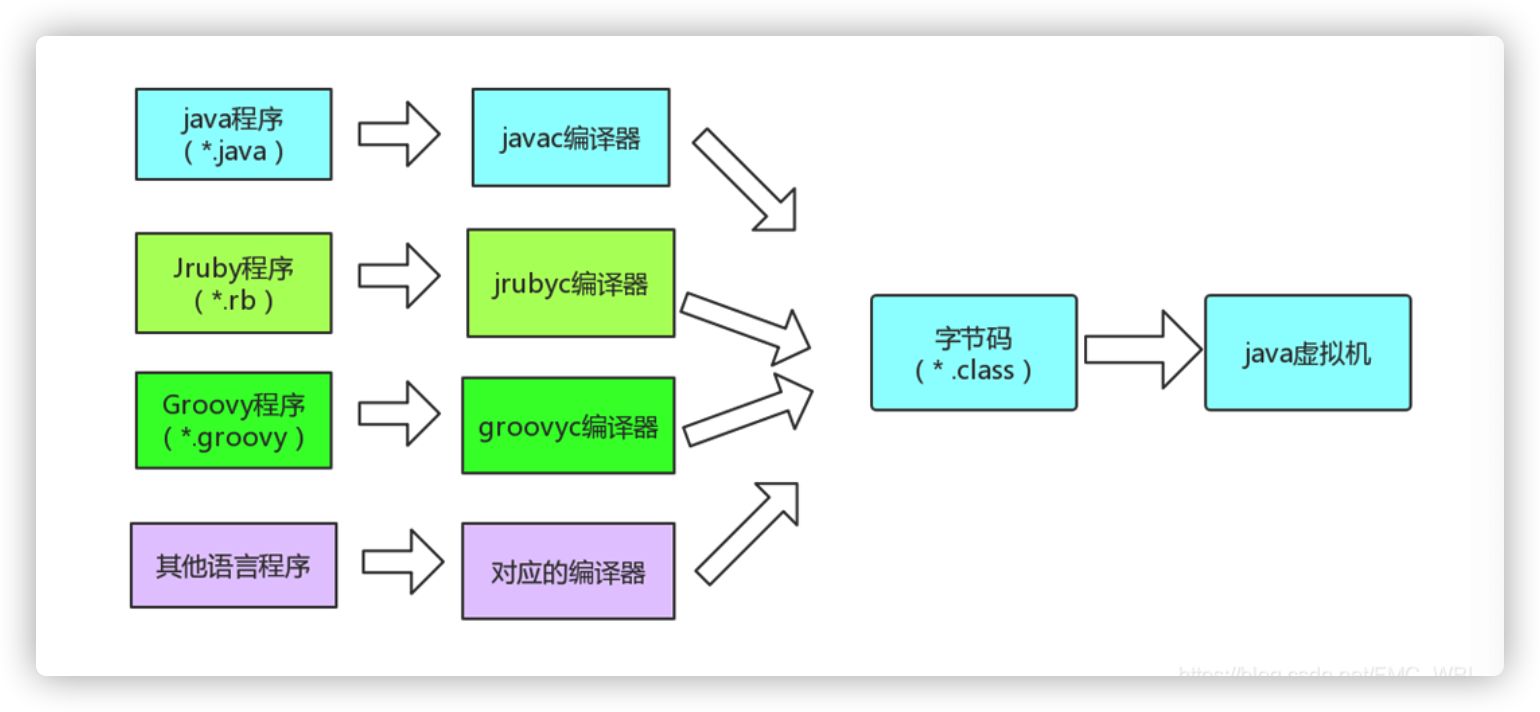
与平台无关性是建立在操作系统上,虚拟机厂商提供了许多可以运行在各种不同平台的虚拟机,它们都可以载入和执行字节码,从而实现程序的“一次编写,到处运行”。

各种不同平台的虚拟机与所有平台都统一使用的程序存储格式——字节码(Byte Code)是构成平台无关性的基石,也是语言无关性的基础。Java 虚拟机不和包括 Java 在内的任何语言绑定,它只与“Class 文件”这种特定的二进制文件格式所关联,Class 文件中包含了 Java 虚拟机指令集和符号表以及若干其他辅助信息。

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/ZGOAdI_20210507092208.png

Class 类文件

Java 技术能够一直保持非常好的向后兼容性,这点 Class 文件结构的稳定性功不可没。Java 已经发展到 14 版本,但是 class 文件结构的内容,绝大部分在JDK1.2 时代就已经定义好了。虽然 JDK1.2 的内容比较古老,但是 java 发展经历了十余个大版本,但是每次基本上知识在原有结构基础上新增内容、扩充功能,并未对定义的内容做修改。

任何一个 Class 文件都对应着唯一一个类或接口的定义信息,但反过来说,Class 文件实际上它并不一定以磁盘文件的形式存在(比如可以动态生成、或者直接送入类加载器中)。

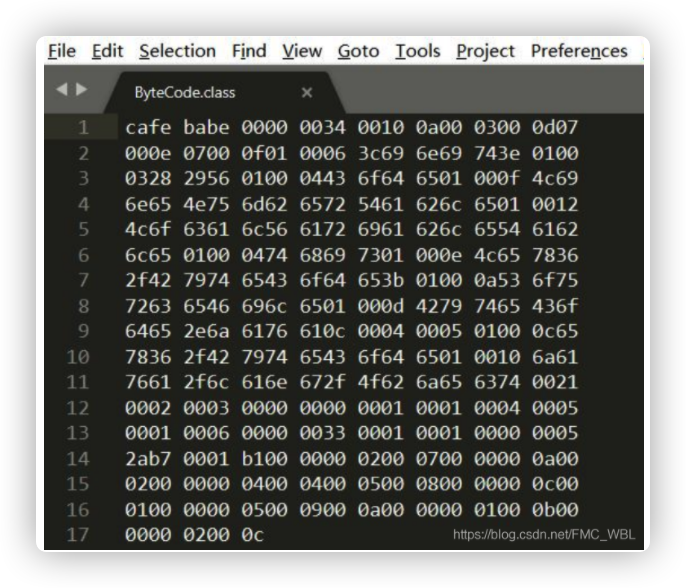
Class 文件是一组以 8 位字节为基础单位的二进制流。

工具介绍

Sublime:查看 16 进制的编辑器
javap:javap 是 JDK 自带的反解析工具。它的作用是将 .class 字节码文件解析成可读的文件格式。
在使用 javap 时我一般会添加 -v 参数,尽量多打印一些信息。同时,我也会使用 -p 参数,打印一些私有的字段和方法。
jclasslib:如果你不太习惯使用命令行的操作,还可以使用 jclasslib,jclasslib 是一个图形化的工具,能够更加直观的查看字节码中的内容。它还分门别类的对类中的各个部分进行了整理,非常的人性化。同时,它还提供了 Idea 的插件,你可以从 plugins 中搜索到它。

Class 文件格式

从一个 Class 文件开始,整个 Class 文件的格式就是一个二进制的字节流。各个数据项目严格按照顺序紧凑地排列在 Class 文件之中,中间没有添加任何分隔符,这使得整个 Class 文件中存储的内容几乎全部是程序运行的必要数据,没有空隙存在。

Class 文件格式采用一种类似于 C 语言结构体的伪结构来存储数据,这种伪结构中只有两种数据类型:无符号数和表。

无符号数属于基本的数据类型,以 u1、u2、u4、u8 来分别代表 1 个字节(一个字节是由两位 16 进制数组成 (1个16进制数=4个二进制数 8个二进制数=一个字节))、2 个字节、4 个字节和 8 个字节的无符号数,无符号数可以用来描述数字、索引引用、数量值或者按照 UTF-8 编码构成字符串值。

表是由多个无符号数或者其他表作为数据项构成的复合数据类型,所有表都习惯性地以“_info”结尾。表用于描述有层次关系的复合结构的数据,整个Class 文件本质上就是一张表。

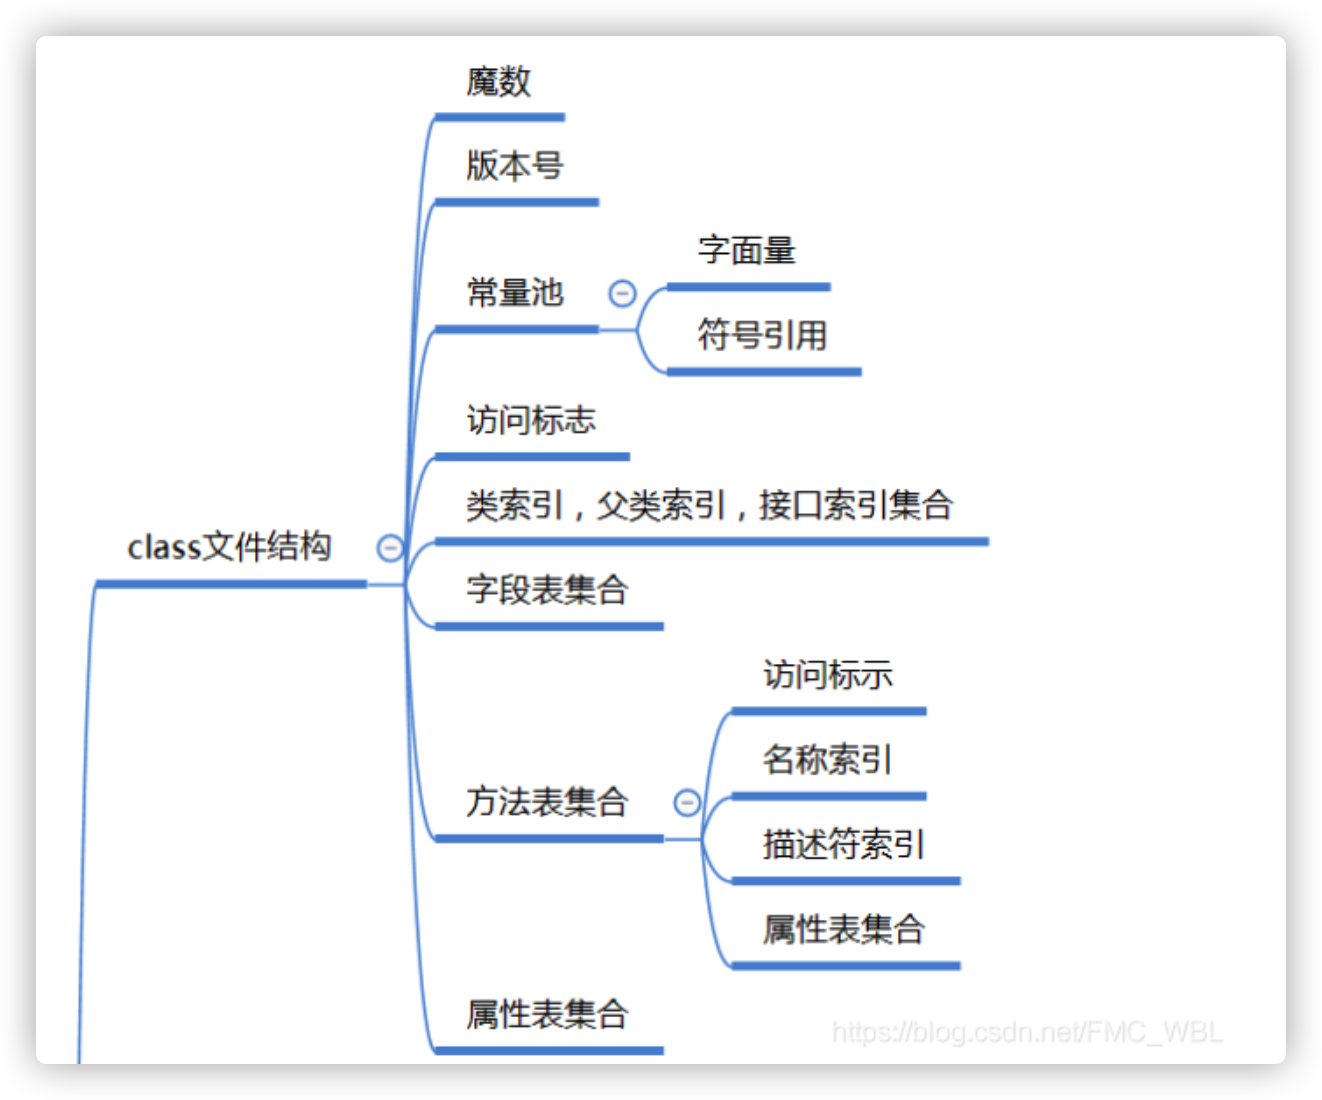
Class 文件格式详解

Class 的结构不像 XML 等描述语言,由于它没有任何分隔符号,所以在其中的数据项,无论是顺序还是数量,都是被严格限定的,哪个字节代表什么含义,长度是多少,先后顺序如何,都不允许改变。

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/mwHImZ_20210507115741.png

按顺序包括:

魔数与 Class 文件的版本

每个 Class 文件的头 4 个字节称为魔数(Magic Number),它的唯一作用是确定这个文件是否为一个能被虚拟机接受的 Class 文件。使用魔数而不是扩展名来进行识别主要是基于安全方面的考虑,因为文件扩展名可以随意地改动。文件格式的制定者可以自由地选择魔数值,只要这个魔数值还没有被广泛采用过同时又不会引起混淆即可。

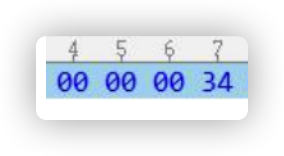
紧接着魔数的 4 个字节存储的是 Class 文件 的版本号:第 5 和第 6 个字节是次版本号(MinorVersion),第 7 和第 8 个字节是主版本号(Major Version)。

Java 的版本号是从 45 开始的,JDK 1.1 之后的每个 JDK 大版本发布主版本号向上加 1 高版本的 JDK 能向下兼容以前版本的 Class 文件,但不能运行以后版本的 Class 文件,即使文件格式并未发生任何变化,虚拟机也必须拒绝执行超过其版本号的 Class 文件。代表 JDK1.8(16 进制的 34,换成 10 进制就是 52)

常量池

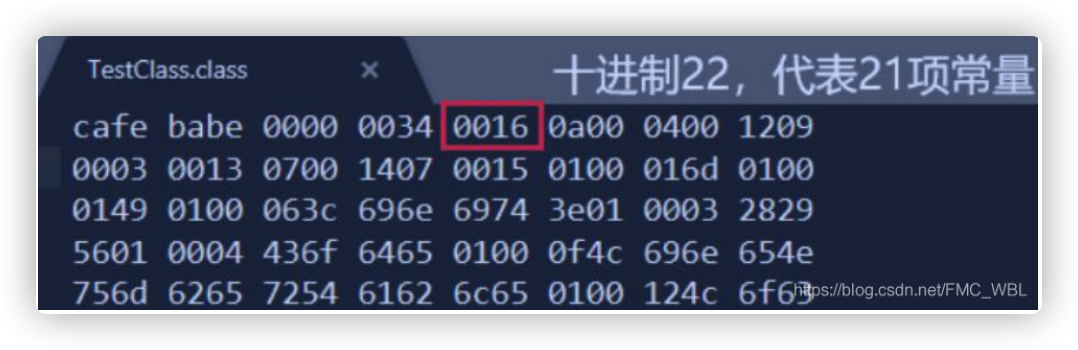
常量池中常量的数量是不固定的,所以在常量池的入口需要放置一项 u2 类型的数据,代表常量池容量计数值(constant_pool_count)。与 Java 中语言习惯不一样的是,这个容量计数是从 1 而不是 0 开始的

常量池中主要存放两大类常量:字面量(Literal)和符号引用(Symbolic References)。
字面量比较接近于 Java 语言层面的常量概念,如文本字符串、声明为 final 的常量值等。
符号引用则属于编译原理方面的概念,包括了下面三类常量:类和接口的全限定名(Fully Qualified Name)、字段的名称和描述符(Descriptor)、方法的名称和描述符

访问标志

用于识别一些类或者接口层次的访问信息,包括:这个 Class 是类还是接口;是否定义为 public 类型;是否定义为 abstract 类型;如果是类的话,是否被声明为 final 等

类索引、父类索引与接口索引集合

这三项数据来确定类的继承关系。类索引用于确定这个类的全限定名,父类索引用于确定这个类的父类的全限定名。由于 Java 语言不允许多重继承,所以父类索引只有一个,除了 java.lang.Object 之外,所有的 Java 类都有父类,因此除了java.lang.Object 外,所有 Java 类的父类索引都不为 0。接口索引集合就用来描述这个类实现了哪些接口,这些被实现的接口将按 implements 语句(如果这个类本身是一个接口,则应当是 extends 语句)后的接口顺序从左到右排列在接口索引集合中

字段表集合

描述接口或者类中声明的变量。字段(field)包括类级变量以及实例级变量。
而字段叫什么名字、字段被定义为什么数据类型,这些都是无法固定的,只能引用常量池中的常量来描述。字段表集合中不会列出从超类或者父接口中继承而来的字段,但有可能列出原本 Java 代码之中不存在的字段,譬如在内部类中为了保持对外部类的访问性,会自动添加指向外部类实例的字段。

方法表集合

描述了方法的定义,但是方法里的 Java 代码,经过编译器编译成字节码指令后,存放在属性表集合中的方法属性表集合中一个名为“Code”的属性里面。

与字段表集合相类似的,如果父类方法在子类中没有被重写(Override),方法表集合中就不会出现来自父类的方法信息。但同样的,有可能会出现由编译器自动添加的方法,最典型的便是类构造器“<clinit>”方法和实例构造器“<init>”

属性表集合

存储 Class 文件、字段表、方法表都自己的属性表集合,以用于描述某些场景专有的信息。如方法的代码就存储在 Code 属性表中。

l