使用java8实现List中对象属性的去重

今天在工作的时候遇到了一个问题,就是List的去重,不想用双重for,感觉太low,不想用for+Map,感觉应该有更好的方法,于是,google之。发现java8的stream流能完美解决这个问题。

1
List<BookInfoVo> list

比如在 BookInfoVo 中有一个 recordId 属性,现在需要对此去重.

怎么办呢?

有两种方法:

  • 第一种: 不使用java8 的 Stream
    1
    2
    3
    4
    5
    private List<BookInfoVo> removeDupliByRecordId(List<BookInfoVo> books) {
    Set<BookInfoVo> bookSet = new TreeSet<>((o1, o2)->o1.getRecordId().compareTo(o2.getRecordId()));
    personSet.addAll(books);
    return new ArrayList<BookInfoVo>(bookSet);
    }
    这也是大多数人第一想到的,借助 TreeSet 去重,其中 TreeSet 的其中一个构造函数接收一个排序的算法,同时这也会用到 TreeSet 的去重策略上.
    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    /**
    * Constructs a new, empty tree set, sorted according to the specified
    * comparator. All elements inserted into the set must be <i>mutually
    * comparable</i> by the specified comparator: {@code comparator.compare(e1,
    * e2)} must not throw a {@code ClassCastException} for any elements
    * {@code e1} and {@code e2} in the set. If the user attempts to add
    * an element to the set that violates this constraint, the
    * {@code add} call will throw a {@code ClassCastException}.
    *
    * @param comparator the comparator that will be used to order this set.
    * If {@code null}, the {@linkplain Comparable natural
    * ordering} of the elements will be used.
    */
    public TreeSet(Comparator<? super E> comparator) {
    this(new TreeMap<>(comparator));
    }
  • 第二种: 炫酷的java8写法]
    1
    2
    3
    4
    5
    6
    /*方法二:炫酷的java8写法*/
    ArrayList<BookInfoVo> distinctLiost = list.stream()
    .collect(
    Collectors.collectingAndThen(
    Collectors.toCollection(() -> new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))), ArrayList::new)
    );
    当然也可以根据多个属性去重
    1
    2
    ArrayList<BookInfoVo> distinctLiost = list.stream().collect(Collectors.collectingAndThen(
    Collectors.toCollection(() -> new TreeSet<>(Comparator.comparing(o -> o.getName() + ";" + o.getAuthor()))), ArrayList::new)
    如果没有第一种方法做铺垫,我们很可能一脸懵逼.

其实理解起来也不难:

关键在于Collectors.collectingAndThen( Collectors.toCollection(() -> new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))), ArrayList::new)的理解,

collectingAndThen 这个方法的意思是: 将收集的结果转换为另一种类型: collectingAndThen,

因此上面的方法可以理解为,把 new TreeSet<>(Comparator.comparingLong(BookInfoVo::getRecordId))这个set转换为 ArrayList,这个结合第一种方法不难理解.

可以看到java8这种写法真是炫酷又强大!!!

l

双亲委派机制

一、双亲委派机制

  1. class文件是通过类加载器加载到jvm中的

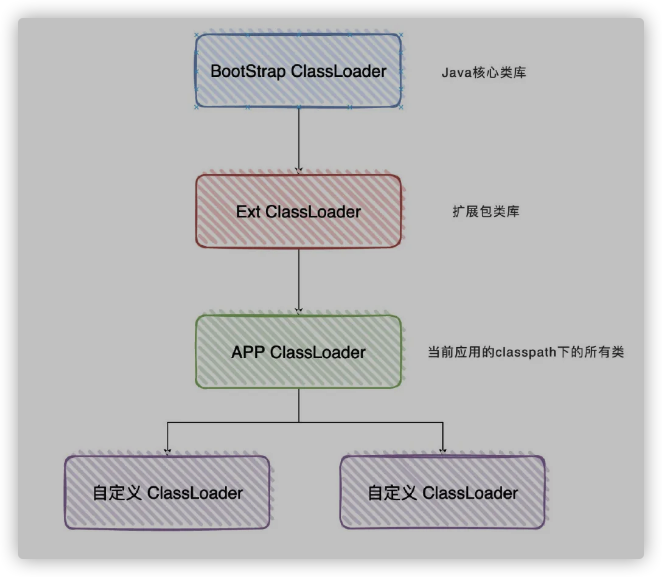
  2. 为了防止内存中存在多份同样的字节码,使用了双亲委派机制(不会自己加载类,而是把请求委托给父加载器去完成,依次向上)

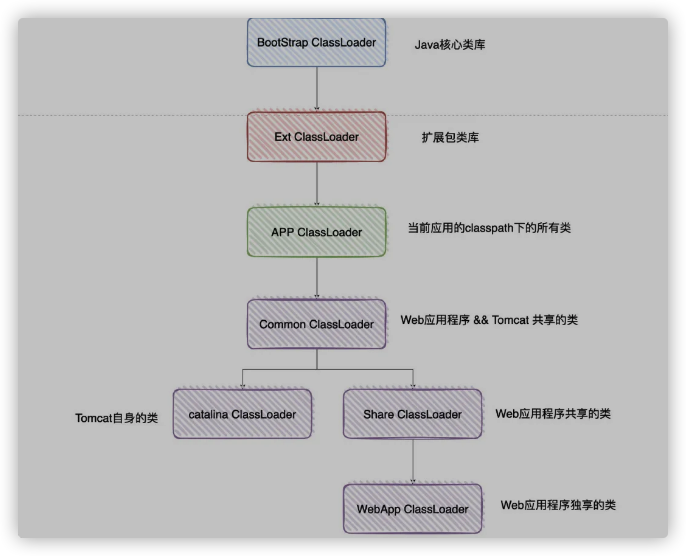
  3. jdk本地方法类一般有根加载器(BootStrap Loader) 装载,jdk内部实现的扩展类一般由扩展加载器(ExtClassLoader),程序中的类文件则有系统加载器(AppClassLoader)装载

二、如何打破双亲委派机制

  1. 只要我加载类的时候,不是从AppClassLoader→ExtClassLoader→BootStrap Loader这个顺序找,那就是打破了。
  2. 因为加载class核心的方法在LoaderClass类的loadClass()方法上(双亲委派机制的核心实现上)
  3. 只要我自定义个ClassLoader,重写loadClass方法(不依照往上开始寻找类加载器),那就算是打破双亲委派机制了。

三、破坏双亲委派机制的场景

  1. tomcat:初学部署项目时,我们是把war包放到tomcat的webapp下,意味着tomcat可以运行多个web应用程序
  2. 那假设我现在有2个web应用程序,都有一个类,叫做User,并且它们的类全限定名都一样,比如:都是com.xxxxx.User。但是它们的具体实现是不一样的
  3. 那么tomcat是如何保证它们不会冲突的呢?
  4. 答案就是:tomcat给每个web应用创建了一个类加载器实例(WebAppClassLoader),该加载器重写了loadClass方法,优先加载当前应用目录下的类,如果当前找不到,才一层一层往上找。这样就做到了web应用层级的隔离。

四、tomcat还有别的类加载器吗

  1. 并不是web应用下的所有依赖都是需要隔离的,比如redis就是可以web应用之间共享的

  2. 因为如果版本相同,没必要每个web应用都独自加载一份

  3. 做法很简单,tomcat就在WebAppClassLoader上加了个父类加载器(SharedClassLoader),如果WebAppClassLoader自身没有加载到某个类,那就委托ShaerClassLoader去加载。(无非就是把需要应用程序之间需要共享的类放到一个共享目录下,SharedClassLoader)读共享目录的类就好了

  4. 为了隔离web应用与tomcat本身的类,又有类加载器(CatalinaClassLoader)来装载tomcat本身的依赖

  5. 如果tomcat本身的类的依赖和web应用还需要共享,那么还有类加载器(CommonClassLoader)来装载进而达到共享

  6. 各个类加载器的加载目录可以到tomcat的catalina.properties配置文件上查看

五、jdbc

  1. 有没有破坏双亲委派机制,见仁见智
  2. jdbc定义类接口,具体实现类由各个厂商进行实现(比如Mysql)
  3. 类加载有个规则:如果一个类由类加载器A加载,那么这个类的依赖类也是有相同的类加载器加载
  4. 我们用jdbc的时候,是使用DriverManager进而获取Connection,DriverManager在java.sql包下,显然是有BootStrap类加载器进行装载
  5. 当我们使用DriverManager.getConnection()时,得到的是一定是厂商实现的类
  6. 但BootStrap 加载器显然不可以加载各个厂商实现的类,这些实现类又没在java包中,怎么可能加载到呢
  7. DriverManager的解决方案是:在DriverManager初始化时,得到上下文加载器,去获取Connection时,是使用上下文加载器去加载Connection的,而这里的线程上下文加载器实际上还是(AppClassLoader)
  8. 在获取Connection的时候,还是先找到ExtClassLoader和B o o t S t ra p C la s sLoader,只不过这两加载器肯定是加载不到的,最终会有AppClassLoader进行加载
  9. 那这种情况,有的人觉得破坏了双亲委派机制,因为本来明明应该是有BootStrapClassLoader进行加载的,结果你来了一手线程上下文加载器,改掉了类加载器
  10. 有的人觉得没破坏双亲委派机制,只是改成了由线程上下文加载器进行类加载,但是还是遵守依次往上找父类加载,都找不到时才由自身加载。认为原则上没有改变。
  11. 我觉得这不重要,重要的是弄懂底层原理
l

java8类型互转

List< Integer >、int[ ]、Integer[ ]相互转换

[toc]

下文中出现的list、ints、integers分别代表一个列表、一个int数组、一个Integer数组。
它们之间所谓的转化,其实是 复制数据,互不干扰,可以理解为深拷贝。

int[ ] 转 List< Integer >

1
List<Integer> list = Arrays.stream(ints).boxed().collect(Collectors.toList());

Arrays.stream(ints) 之后返回的类型是 IntStream,IntStream 是一个接口继承自 BaseStream,BaseStream 又继承自AutoCloseable。所以我把IntStream看成一个方便对每个整数做操作的数据流。

之后调用了 boxed(),它的作用是对每个整数进行装箱,基本类型流转换为对象流,返回的是 Stream,Stream 也是继承自 BaseStream。所以这一步的作用是把 IntStream 转换成了 Stream。

最后通过collect方法将数据流 (Stream) 收集成了集合 ( List),这里 collect 方法里传入的是一个收集器 (Collector),它通过 Collectors.toList() 产生。

小结:

  1. Arrays.stream(ints) 将基本类型数组转换为基本类型流。 int[ ] => IntStream
  2. .boxed() 将基本类型流转换为对象流。 => Stream< Integer >
  3. .collect(Collectors.toList()) 将对象流收集为集合。 => List< Integer >

int[ ] [ ] 转 List< List < Integer > >

1
2
String temp = Arrays.deepToString(fooArr).replaceAll("\\[","").replaceAll("\\]","");
List<String> fooList = new ArrayList<>(Arrays.asList(",")); //不对
1
List<List<Integer>> collect2 = Arrays.Stream(ints1).map(ar -> Arrays.stream(ar).boxed().collect(Collectors.toList())).collect(Collectors.toList());

int[ ] 转 Integer[ ]

1
Integer[] integers = Arrays.stream(ints).boxed().toArray(Integer[]::new);

一样的内容就不重复了,toArray(T[ ] :: new) 方法返回基本类型数组。
小结:

  1. Arrays.stream(ints) 将基本类型数组转换为基本类型流。 int[ ] => IntStream
  2. .boxed() 将基本类型流转换为对象流。=> Stream< Integer >
  3. .toArray(Integer[ ]::new) 将对象流转换为对象数组。=> Integer[ ]

int[ ] [ ]转 Integer[ ] [ ]

1
Integer[][] integers3 = Arrays.stream(ints1).map(ints -> Arrays.stream(ints).boxed().toArray(Integer[]::new)).toArray(Integer[][]::new);

Integer[ ] 转 List< Integer >

1
List<Integer> list = Arrays.asList(integers);

这个就很简单了,通过Arrays类里的asList方法将数组装换为List。值得注意:

asList 返回的是 Arrays 里的静态私有类 ArrayList,而不是 java.util 里的 ArrayList,它无法自动扩容。

可以用下面2种方法生成可扩容的ArrayList:

1
List<Integer> list = new ArrayList<>(Arrays.asList(integers)); 

或者

1
2
List<Integer> list = new ArrayList<>(); 
Collections.addAll(list, integers);

Integer[ ] [ ]转 List< List < Integer > >

1
2
Integer[][] a = {{1,2,3},{1,2,3}};
List<List<Integer>> lists = Arrays.stream(a).map(Arrays::asList).collect(Collectors.toList());

Integer[ ] 转 int[ ]

1
int[] ints = Arrays.stream(integers).mapToInt(Integer::valueOf).toArray();

map的意思是把每一个元素进行同样的操作。mapToInt的意思是把每一个元素转换为int。mapToInt(Integer::valueOf)方法返回的是IntStream。
小结:

  1. Arrays.stream(integers) 将对象数组转换为对象流。 Integer[ ] => Stream< Integer >
  2. .mapToInt(Integer::valueOf) 将对象流转换成基本类型流。=> IntStream
  3. .toArray() 将基本类型流转换为基本类型数组。 => int[ ]

Integer[ ] [ ]转 int[ ] [ ]

1
2
Integer[][] a = {{1,2,3},{1,2,3}};      
int[][] ints1 = Arrays.stream(a).map(a1 -> Arrays.stream(a1).mapToInt(Integer::valueOf).toArray()).toArray(int[][]::new);

List< Integer > 转 int[ ]

1
int[] ints = list.stream().mapToInt(Integer::valueOf).toArray();

经过上面的说明,相信这里已经很好理解了,直接小结。
小结:

  1. list.stream() 将列表转换为对象流。List< Integer > => Stream< Integer >
  2. .mapToInt(Integer::valueOf) 将对象流转换为基本数据类型流。=> IntStream
  3. .toArray() 将基本数据类型流转换为基本类型数组。=>int[ ]

List< List < Integer > > 转 int[ ] [ ]

1
2
3
4
List<List<Integer>> lists = ...;
int[][] arrays = lists.stream() // Stream<List<Integer>>
.map(list -> list.stream().mapToInt(i -> i).toArray()) // Stream<int[]>
.toArray(int[][]::new);

List< Integer > 转 Integer[ ]

1
Integer[] integers = list.toArray(new Integer[list.size()]);
1
Integer[] integers = list.stream().toArray(Integer[]::new); //不推荐

这个也很简单,方法里的参数是一个数组,所以要规定长度。也有无参的方法,但是要进行转型,所以不推荐使用。

List< List < Integer > > 转 Integer[ ] [ ]

1
2
3
4
List<List<Integer>> lists = ...;
Integer[][] arrays = lists.stream() // Stream<List<Integer>>
.map(list -> list.toArray(new Integer[list.size()])) // Stream<Integer[]>
.toArray(Integer[][]::new);
1
2
3
Integer[][] arrays = lists.stream()                                // Stream<List<Integer>>
.map(l -> l.stream().toArray(String[]::new)) // Stream<Integer[]>
.toArray(Integer[][]::new);
1
Integer[][] arrays = lists.stream().map(List::toArray).toArray(Integer[][]::new);

List< Character >、char[ ]、Character[ ]相互转换

char[ ] 转 List< Character >

1
2
char[] chars = {'a', 'b', 'c'};
List<Character> collect = new String(chars).chars().mapToObj(i -> (char) i).collect(Collectors.toList());

char[ ] [ ] 转 List< List < Character > >

1
List<List<Character>> collect2 = Arrays.stream(ints1).map(chars1 -> new String(chars1).chars().mapToObj(i -> (char) i).collect(Collectors.toList())).collect(Collectors.toList());

char[ ] 转 Character[ ]

1
2
char[] chars = {'a', 'b', 'c'};
Character[] characters1 = new String(chars).chars().mapToObj(i -> (char) i).toArray(Character[]::new);

char[ ] [ ]转 Character[ ] [ ]

1
Character[][] integers3 = Arrays.stream(ints1).map(chars -> new String(chars).chars().mapToObj(i->(char)i).toArray(Character[]::new)).toArray(Character[][]::new);

Character[ ] 转 List< Character >

1
List<Character> collect2 = Arrays.stream(characters).collect(Collectors.toList());

Character[ ] [ ]转 List< List < Character > >

1
List<List<Character>> lists = Arrays.stream(a).map(Arrays::asList).collect(Collectors.toList());

Character[ ] 转 char[ ]

1
2
char[] chars4 = Arrays.stream(characters1).map(String::valueOf).collect(Collectors.joining()).toCharArray();

Character[ ] [ ]转 char[ ] [ ]

1
char[][] ints1 = Arrays.stream(a).map(a1 -> Arrays.stream(a1).map(String::valueOf).collect(Collectors.joining()).toCharArray()).toArray(char[][]::new);

List< Character > 转 char[ ]

1
char[] value = characters.stream().map(String::valueOf).collect(Collectors.joining()).toCharArray();
1
2
Character[] charArr = characters.toArray(new Character[characters.size()]);
char[] value = ArrayUtils.toPrimitive(charArr);

List< List < Character > > 转 char[ ] [ ]

1
2
3
char[][] arrays = lists.stream()                                // Stream<List<Integer>>
.map(list -> list.stream().map(String::valueOf).collect(Collectors.joining()).toCharArray()) // Stream<int[]>
.toArray(char[][]::new);

List< Character > 转 Character[ ]

1
Character[] characters2 = Arrays.stream(characters1).toArray(Character[]::new);

List< List < Character > > 转 Character[ ] [ ]

1
2
Character[][] integers1 = lists.stream()                                // Stream<List<Integer>>
.map(list -> list.toArray(new Character[list.size()])).toArray(Character[][]::new);
1
2
3
Character[][] integers2 = lists.stream()                                // Stream<List<Integer>>
.map(l -> l.stream().toArray(Character[]::new))
.toArray(Character[][]::new);
1
Character[][] integers = lists.stream().map(List::toArray).toArray(Character[][]::new);
l

注释书写规范

  • 一般情况下,源程序有效注释量必须在30%以上。注释的原则是有助于对程序的阅读理解,在该加的地方都加了,注释不宜太多也不能太少,注释语言必须准确、易懂、简洁。可以用注释统计工具来统计。

    一、类和接口的注释

1. 类外注释

该注释放在 package 关键字之后,class 或者 interface 关键字之前。

  • 说明:方便JavaDoc收集。
    示例:
1
2
3
4
5
package com.huawei.msg.relay.comm;
/**
* 注释内容
*/
public class CommManager
  • 类和接口的注释内容:类的注释主要是一句话功能简述、功能详细描述。
    格式:
    1
    2
    3
    4
    /**
    * 〈一句话功能简述〉
    * 〈功能详细描述〉
    */
  • 描述部分说明该类或者接口的功能、作用、使用方法和注意事项。
    示例:
    1
    2
    3
    4
    5
    /**
    * LogManager 类集中控制对日志读写的操作。
    * 全部为静态变量和静态方法,对外提供统一接口。分配对应日志类型的读写器,
    * 读取或写入符合条件的日志纪录。
    */

2. 类内注释

类属性、公有和保护方法必须写注释。geter、seter方法不用写注释

示例:

1
2
3
4
5
6
7
8
/**
* 注释内容
*/
private String logType;
/**
* 注释内容
*/
public void write()

1).成员变量注释内容:成员变量的意义、目的、功能,可能被用到的地方。
2).公有和保护方法注释内容:列出方法的一句话功能 简述、功能详细描述、输入参数、输出参数、返回值、违例等。
格式:

1
2
3
4
5
6
7
8
/**
* 〈一句话功能简述〉
* 〈功能详细描述〉
* @param [参数1] [in或out] [参数1说明]
* @param [参数2] [in或out] [参数2说明]
* @return [返回类型说明]
* @exception/throws [违例类型] [违例说明]
*/

说明: @exception或throws 列出可能仍出的异常。
示例:

1
2
3
4
5
6
7
/**
* 用MD5算法计算输入字符串的32位摘要
* @param sIn [in] 待处理的字符串
* @param sOut [out] sIn的32为摘要,调用函数负责new sOut对象
* @return boolean
*/
public static boolean getMd5(String sIn, StringBuffer sOut)

说明:
1).注释应与其描述的代码相近,对代码的注释应放在其上方或右方(对单条语句的注释)相邻位置,不可放在下面,如放于上方则需与其上面的代码用空行隔开。
2).注释与所描述内容进行同样的缩排。
3).将注释与其上面的代码用空行隔开。
示例:

1
2
3
4
5
//注释
program code one
(空一格)
//注释
program code two

二、方法与复杂逻辑的注释

对变量的定义和分支语句(条件分支、循环语句等)对复杂的分支必须编写注释,如果时间允许,建议对所有分支语句写注释。

说明:这些语句往往是程序实现某一特定功能的关键,对于维护人员来说,良好的注释帮助更好的理解程序,有时甚至优于看设计文档。

  1. switch语句
  • switch语句下的case语句,如果因为特殊情况需要处理完一个case后进入下一个case处理,必须在该case语句处理完、下一个case语句前加上明确的注释。
  • 说明:这样比较清楚程序编写者的意图,有效防止无故遗漏break语句。
  1. 边写代码边注释
  • 修改代码同时修改相应的注释,以保证注释与代码的一致性。不再有用的注释要删除。
  1. 避免在注释中使用缩写
  • 在使用缩写时或之前,应对缩写进行必要的说明,特别是不常用缩写。
  1. 用中文注释,禁止用英文写注释。

    建议

  2. 避免在一行代码或表达式的中间插入注释。
  • 说明:除非必要,不应在代码或表达中间插入注释,否则容易使代码可理解性变差。
  1. 通过对函数或过程、变量、结构等正确的命名以及合理地组织代码的结构,使代码成为自注释的。
  • 说明:清晰准确的函数、变量等的命名,可增加代码可读性,并减少不必要的注释。
  1. 在代码的功能、意图层次上进行注释,提供有用、额外的信息。
  • 说明:注释的目的是解释代码的目的、功能和采用的方法,提供代码以外的信息,帮助读者理解代码,防止没必要的重复注释信息。
  • 示例:如下注释意义不大。
    1
    2
    // 如果 receiveFlag 为真
    if (receiveFlag)
  • 而如下的注释则给出了额外有用的信息。
    1
    2
    // 如果从连结收到消息 
    if (receiveFlag)
  1. 在程序块的结束行右方加注释标记,以表明某程序块的结束。
  • 说明:当代码段较长,特别是多重嵌套时,这样做可以使代码更清晰,更便于阅读。
  • 示例:参见如下例子。
    1
    2
    3
    4
    5
    6
    7
    8
    if (...)
    {
    program code1
    while (index < MAX_INDEX)
    {
    program code2
    } // end of while (index < MAX_INDEX) // 指明该条while语句结束
    } // end of if (...) // 指明是哪条if语句结束
  1. 方法内的单行注释使用 //。
  • 说明:调试程序的时候可以方便的使用 /* 。。。*/ 注释掉一长段程序。
  1. 注释使用中文注释和中文标点,不得用英文写注释。方法和类描述的第一句话尽量使用简洁明了的话概括一下功能,然后加以句号。接下来的部分可以详细描述。
  • 说明:JavaDoc工具收集简介的时候使用选取第一句话。
  1. 顺序实现流程的说明使用1、2、3、4在每个实现步骤部分的代码前面进行注释。
  • 示例:如下是对设置属性的流程注释
    1
    2
    3
    4
    //1、 判断输入参数是否有效。
    ...
    // 2、设置本地变量。
    ...
  1. 一些复杂的算法代码需要说明。
  • 示例:这里主要是对闰年算法的说明。
    java //1. 如果能被4整除,是闰年; //2. 如果能被100整除,不是闰年.; //3. 如果能被400整除,是闰年.。 星期五, 23. 八月 2019 07:42下午

**


**

l

Java线程池实现原理及其在美团业务中的实践

随着计算机行业的飞速发展,摩尔定律逐渐失效,多核CPU成为主流。使用多线程并行计算逐渐成为开发人员提升服务器性能的基本武器。J.U.C提供的线程池:ThreadPoolExecutor类,帮助开发人员管理线程并方便地执行并行任务。了解并合理使用线程池,是一个开发人员必修的基本功。

本文开篇简述线程池概念和用途,接着结合线程池的源码,帮助读者领略线程池的设计思路,最后回归实践,通过案例讲述使用线程池遇到的问题,并给出了一种动态化线程池解决方案。

一、写在前面

1.1 线程池是什么

线程池(Thread Pool)是一种基于池化思想管理线程的工具,经常出现在多线程服务器中,如MySQL。

线程过多会带来额外的开销,其中包括创建销毁线程的开销、调度线程的开销等等,同时也降低了计算机的整体性能。线程池维护多个线程,等待监督管理者分配可并发执行的任务。这种做法,一方面避免了处理任务时创建销毁线程开销的代价,另一方面避免了线程数量膨胀导致的过分调度问题,保证了对内核的充分利用。

而本文描述线程池是JDK中提供的ThreadPoolExecutor类。

当然,使用线程池可以带来一系列好处:

  • 降低资源消耗:通过池化技术重复利用已创建的线程,降低线程创建和销毁造成的损耗。
  • 提高响应速度:任务到达时,无需等待线程创建即可立即执行。
  • 提高线程的可管理性:线程是稀缺资源,如果无限制创建,不仅会消耗系统资源,还会因为线程的不合理分布导致资源调度失衡,降低系统的稳定性。使用线程池可以进行统一的分配、调优和监控。
  • 提供更多更强大的功能:线程池具备可拓展性,允许开发人员向其中增加更多的功能。比如延时定时线程池ScheduledThreadPoolExecutor,就允许任务延期执行或定期执行。

1.2 线程池解决的问题是什么

线程池解决的核心问题就是资源管理问题。在并发环境下,系统不能够确定在任意时刻中,有多少任务需要执行,有多少资源需要投入。这种不确定性将带来以下若干问题:

  1. 频繁申请/销毁资源和调度资源,将带来额外的消耗,可能会非常巨大。
  2. 对资源无限申请缺少抑制手段,易引发系统资源耗尽的风险。
  3. 系统无法合理管理内部的资源分布,会降低系统的稳定性。

为解决资源分配这个问题,线程池采用了“池化”(Pooling)思想。池化,顾名思义,是为了最大化收益并最小化风险,而将资源统一在一起管理的一种思想。

Pooling is the grouping together of resources (assets, equipment, personnel, effort, etc.) for the purposes of maximizing advantage or minimizing risk to the users. The term is used in finance, computing and equipment management.——wikipedia

“池化”思想不仅仅能应用在计算机领域,在金融、设备、人员管理、工作管理等领域也有相关的应用。

在计算机领域中的表现为:统一管理IT资源,包括服务器、存储、和网络资源等等。通过共享资源,使用户在低投入中获益。除去线程池,还有其他比较典型的几种使用策略包括:

  1. 内存池(Memory Pooling):预先申请内存,提升申请内存速度,减少内存碎片。
  2. 连接池(Connection Pooling):预先申请数据库连接,提升申请连接的速度,降低系统的开销。
  3. 实例池(Object Pooling):循环使用对象,减少资源在初始化和释放时的昂贵损耗。

在了解完“是什么”和“为什么”之后,下面我们来一起深入一下线程池的内部实现原理。

二、线程池核心设计与实现

在前文中,我们了解到:线程池是一种通过“池化”思想,帮助我们管理线程而获取并发性的工具,在Java中的体现是ThreadPoolExecutor类。那么它的的详细设计与实现是什么样的呢?我们会在本章进行详细介绍。

2.1 总体设计

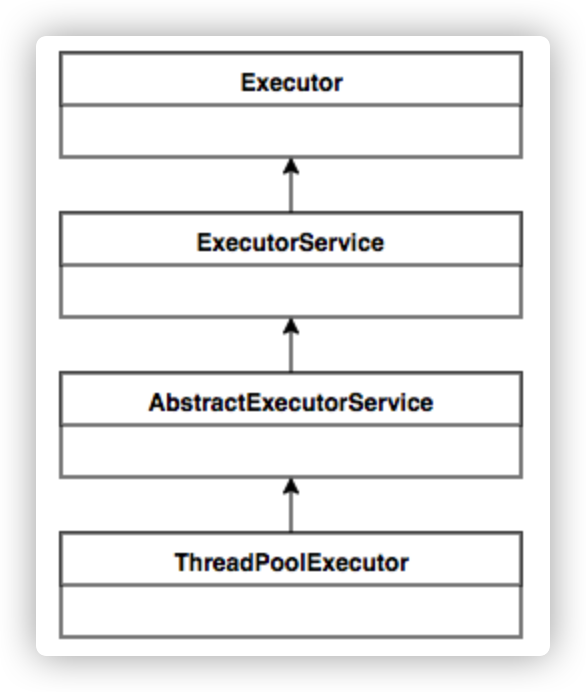
Java中的线程池核心实现类是ThreadPoolExecutor,本章基于JDK 1.8的源码来分析Java线程池的核心设计与实现。我们首先来看一下ThreadPoolExecutor的UML类图,了解下ThreadPoolExecutor的继承关系。

图1 ThreadPoolExecutor UML类图

图1 ThreadPoolExecutor UML类图

ThreadPoolExecutor实现的顶层接口是Executor,顶层接口Executor提供了一种思想:将任务提交和任务执行进行解耦。用户无需关注如何创建线程,如何调度线程来执行任务,用户只需提供Runnable对象,将任务的运行逻辑提交到执行器(Executor)中,由Executor框架完成线程的调配和任务的执行部分。ExecutorService接口增加了一些能力:(1)扩充执行任务的能力,补充可以为一个或一批异步任务生成Future的方法;(2)提供了管控线程池的方法,比如停止线程池的运行。AbstractExecutorService则是上层的抽象类,将执行任务的流程串联了起来,保证下层的实现只需关注一个执行任务的方法即可。最下层的实现类ThreadPoolExecutor实现最复杂的运行部分,ThreadPoolExecutor将会一方面维护自身的生命周期,另一方面同时管理线程和任务,使两者良好的结合从而执行并行任务。

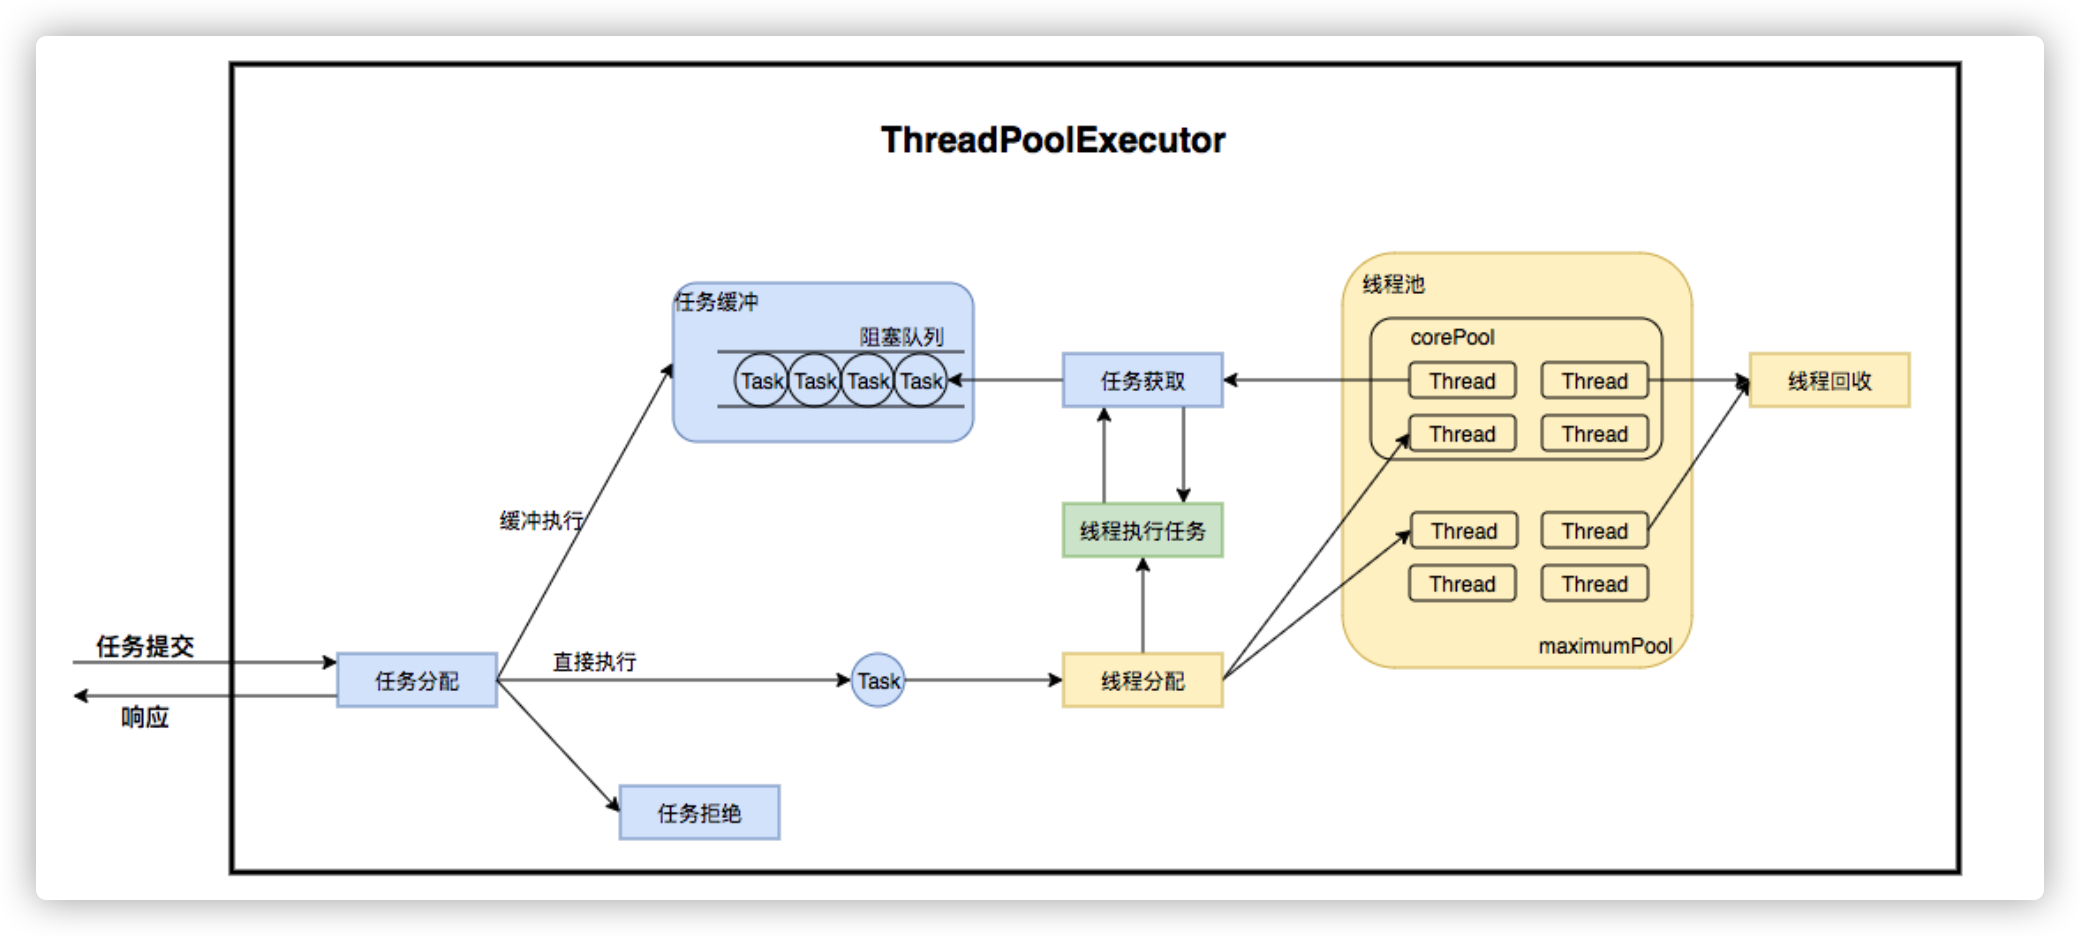
ThreadPoolExecutor是如何运行,如何同时维护线程和执行任务的呢?其运行机制如下图所示:\

图2 ThreadPoolExecutor运行流程

图2 ThreadPoolExecutor运行流程

线程池在内部实际上构建了一个生产者消费者模型,将线程和任务两者解耦,并不直接关联,从而良好的缓冲任务,复用线程。线程池的运行主要分成两部分:任务管理、线程管理。任务管理部分充当生产者的角色,当任务提交后,线程池会判断该任务后续的流转:(1)直接申请线程执行该任务;(2)缓冲到队列中等待线程执行;(3)拒绝该任务。线程管理部分是消费者,它们被统一维护在线程池内,根据任务请求进行线程的分配,当线程执行完任务后则会继续获取新的任务去执行,最终当线程获取不到任务的时候,线程就会被回收。

接下来,我们会按照以下三个部分去详细讲解线程池运行机制:

  1. 线程池如何维护自身状态。
  2. 线程池如何管理任务。
  3. 线程池如何管理线程。

2.2 生命周期管理

线程池运行的状态,并不是用户显式设置的,而是伴随着线程池的运行,由内部来维护。线程池内部使用一个变量维护两个值:运行状态(runState)和线程数量 (workerCount)。在具体实现中,线程池将运行状态(runState)、线程数量 (workerCount)两个关键参数的维护放在了一起,如下代码所示:

1
private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0));

ctl这个AtomicInteger类型,是对线程池的运行状态和线程池中有效线程的数量进行控制的一个字段, 它同时包含两部分的信息:线程池的运行状态 (runState) 和线程池内有效线程的数量 (workerCount),高3位保存runState,低29位保存workerCount,两个变量之间互不干扰。用一个变量去存储两个值,可避免在做相关决策时,出现不一致的情况,不必为了维护两者的一致,而占用锁资源。通过阅读线程池源代码也可以发现,经常出现要同时判断线程池运行状态和线程数量的情况。线程池也提供了若干方法去供用户获得线程池当前的运行状态、线程个数。这里都使用的是位运算的方式,相比于基本运算,速度也会快很多。

关于内部封装的获取生命周期状态、获取线程池线程数量的计算方法如以下代码所示:

1
2
3
private static int runStateOf(int c)     { return c & ~CAPACITY; } //计算当前运行状态
private static int workerCountOf(int c) { return c & CAPACITY; } //计算当前线程数量
private static int ctlOf(int rs, int wc) { return rs | wc; } //通过状态和线程数生成ctl

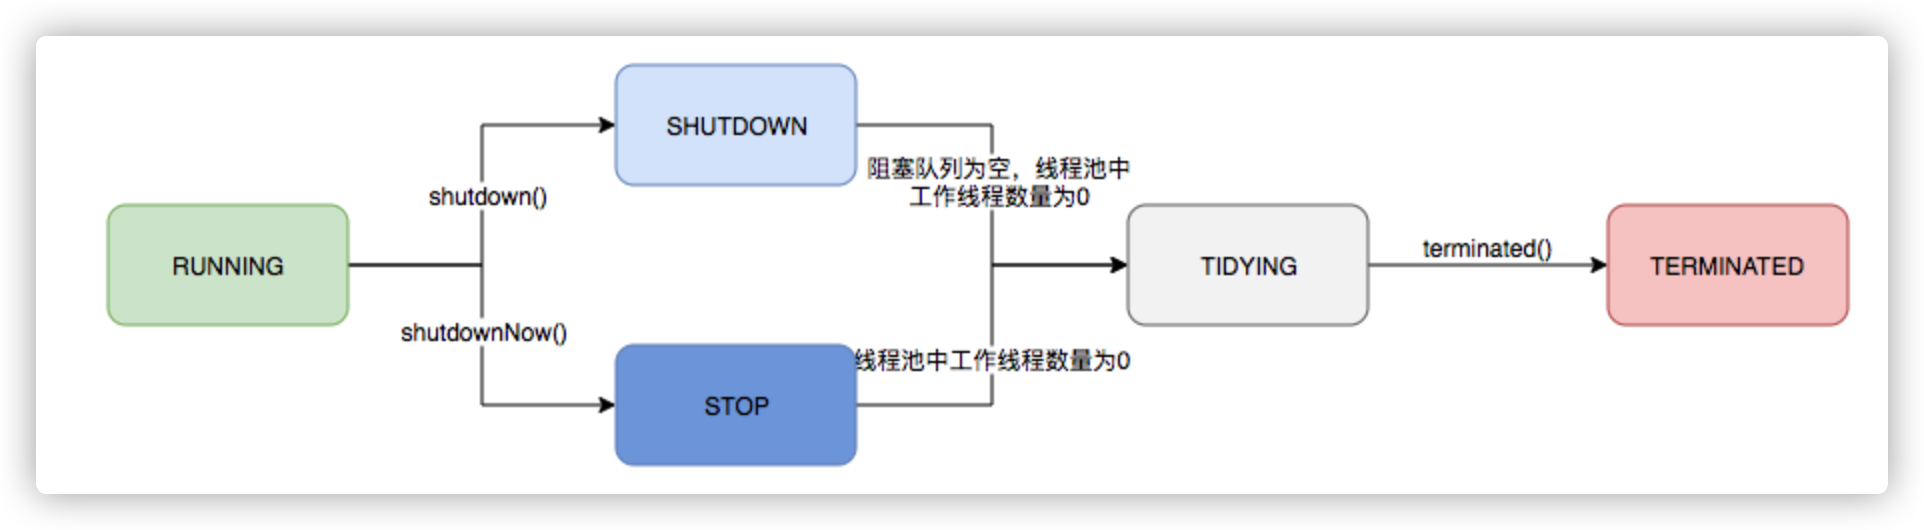
ThreadPoolExecutor的运行状态有5种,分别为:

img

其生命周期转换如下入所示:

图3 线程池生命周期

图3 线程池生命周期

2.3 任务执行机制

2.3.1 任务调度

任务调度是线程池的主要入口,当用户提交了一个任务,接下来这个任务将如何执行都是由这个阶段决定的。了解这部分就相当于了解了线程池的核心运行机制。

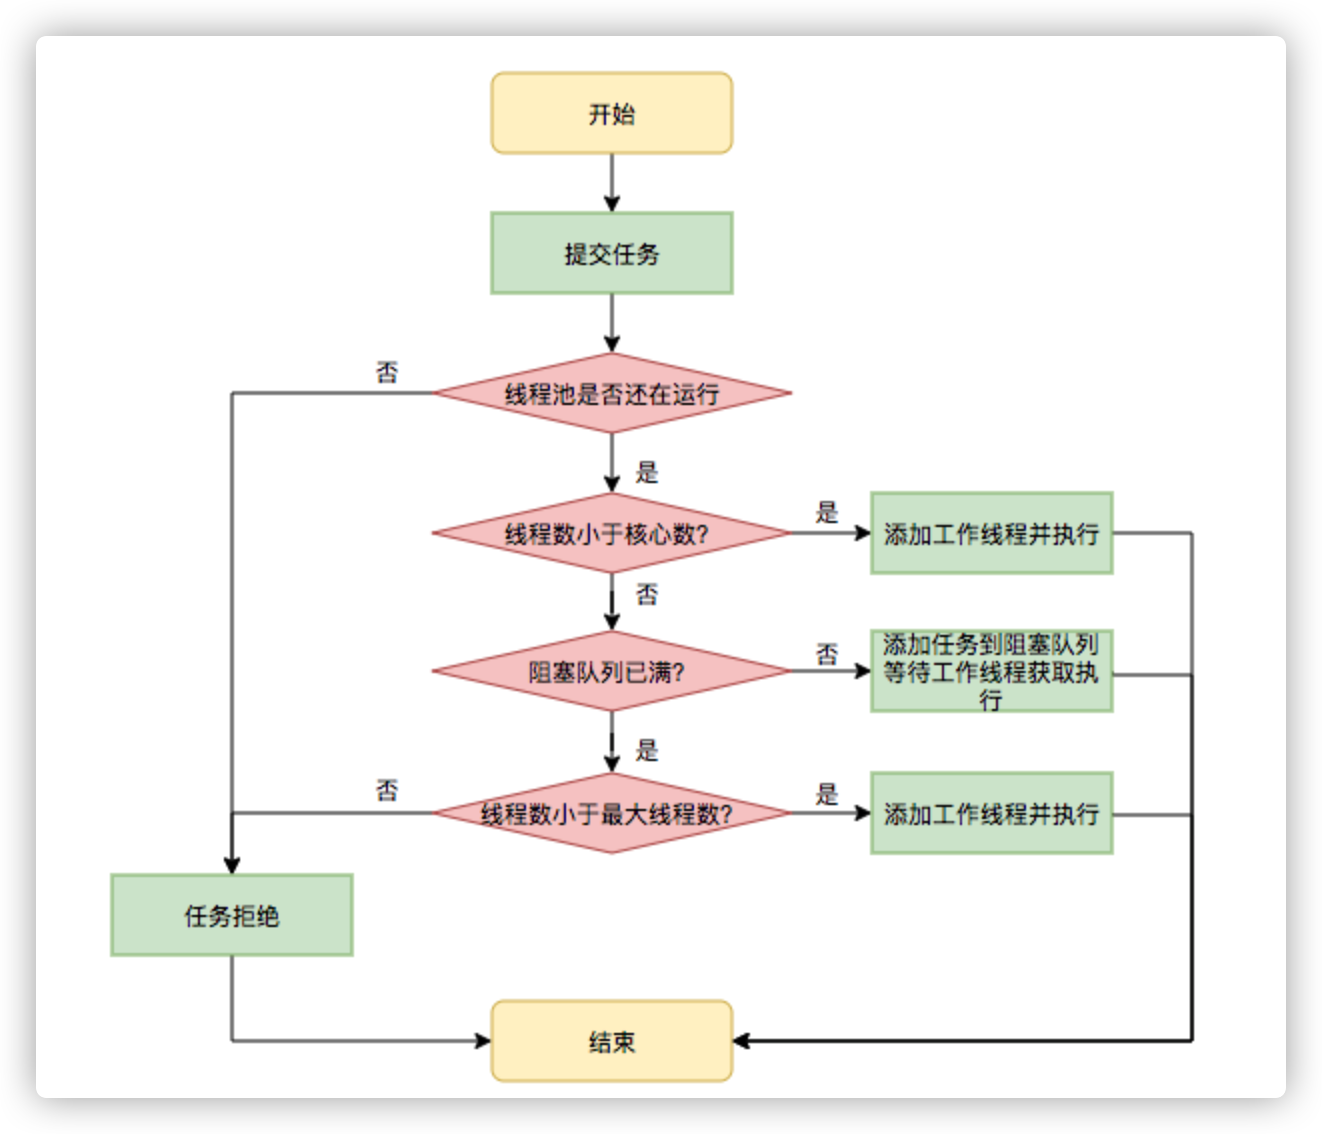
首先,所有任务的调度都是由execute方法完成的,这部分完成的工作是:检查现在线程池的运行状态、运行线程数、运行策略,决定接下来执行的流程,是直接申请线程执行,或是缓冲到队列中执行,亦或是直接拒绝该任务。其执行过程如下:

  1. 首先检测线程池运行状态,如果不是RUNNING,则直接拒绝,线程池要保证在RUNNING的状态下执行任务。
  2. 如果workerCount < corePoolSize,则创建并启动一个线程来执行新提交的任务。
  3. 如果workerCount >= corePoolSize,且线程池内的阻塞队列未满,则将任务添加到该阻塞队列中。
  4. 如果workerCount >= corePoolSize && workerCount < maximumPoolSize,且线程池内的阻塞队列已满,则创建并启动一个线程来执行新提交的任务。
  5. 如果workerCount >= maximumPoolSize,并且线程池内的阻塞队列已满, 则根据拒绝策略来处理该任务, 默认的处理方式是直接抛异常。

其执行流程如下图所示:

图4 任务调度流程

图4 任务调度流程

2.3.2 任务缓冲

任务缓冲模块是线程池能够管理任务的核心部分。线程池的本质是对任务和线程的管理,而做到这一点最关键的思想就是将任务和线程两者解耦,不让两者直接关联,才可以做后续的分配工作。线程池中是以生产者消费者模式,通过一个阻塞队列来实现的。阻塞队列缓存任务,工作线程从阻塞队列中获取任务。

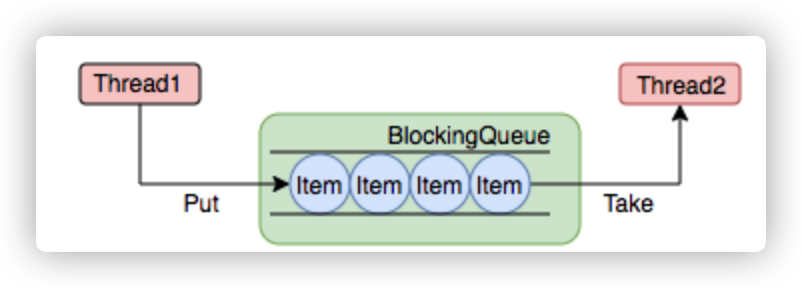
阻塞队列(BlockingQueue)是一个支持两个附加操作的队列。这两个附加的操作是:在队列为空时,获取元素的线程会等待队列变为非空。当队列满时,存储元素的线程会等待队列可用。阻塞队列常用于生产者和消费者的场景,生产者是往队列里添加元素的线程,消费者是从队列里拿元素的线程。阻塞队列就是生产者存放元素的容器,而消费者也只从容器里拿元素。

下图中展示了线程1往阻塞队列中添加元素,而线程2从阻塞队列中移除元素:

图5 阻塞队列

图5 阻塞队列

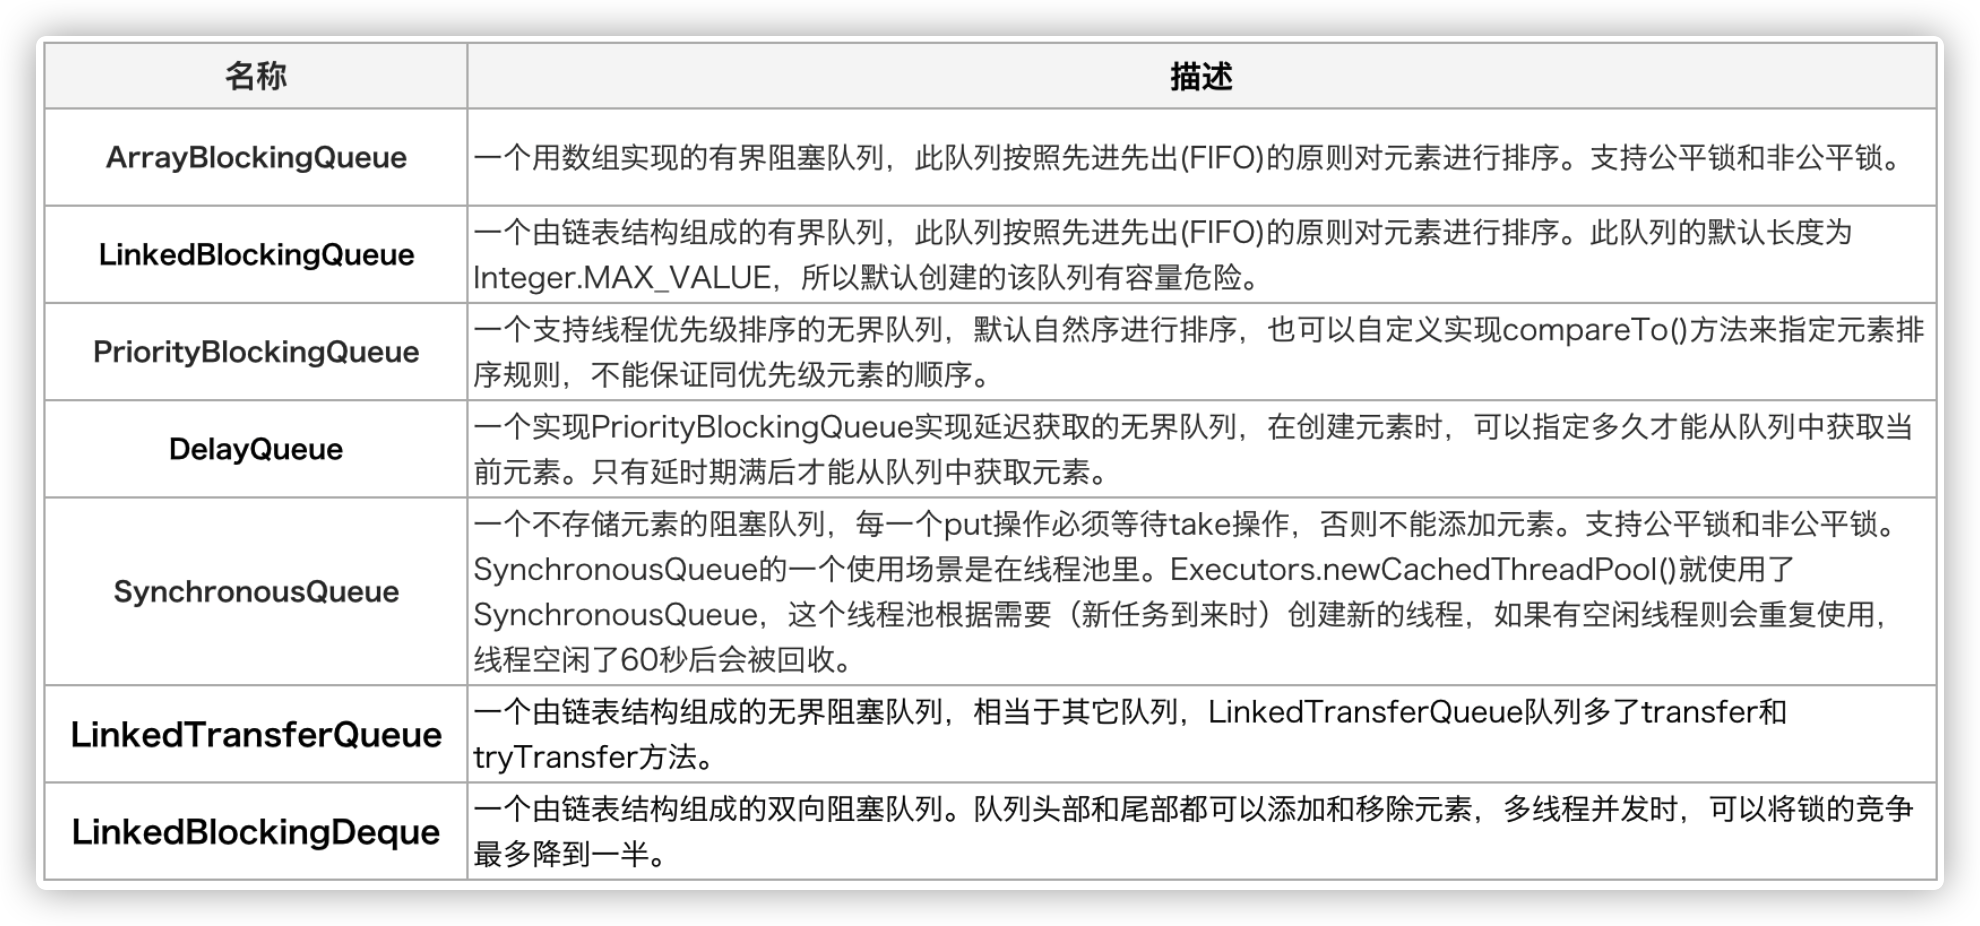
使用不同的队列可以实现不一样的任务存取策略。在这里,我们可以再介绍下阻塞队列的成员:

img

2.3.3 任务申请

由上文的任务分配部分可知,任务的执行有两种可能:一种是任务直接由新创建的线程执行。另一种是线程从任务队列中获取任务然后执行,执行完任务的空闲线程会再次去从队列中申请任务再去执行。第一种情况仅出现在线程初始创建的时候,第二种是线程获取任务绝大多数的情况。

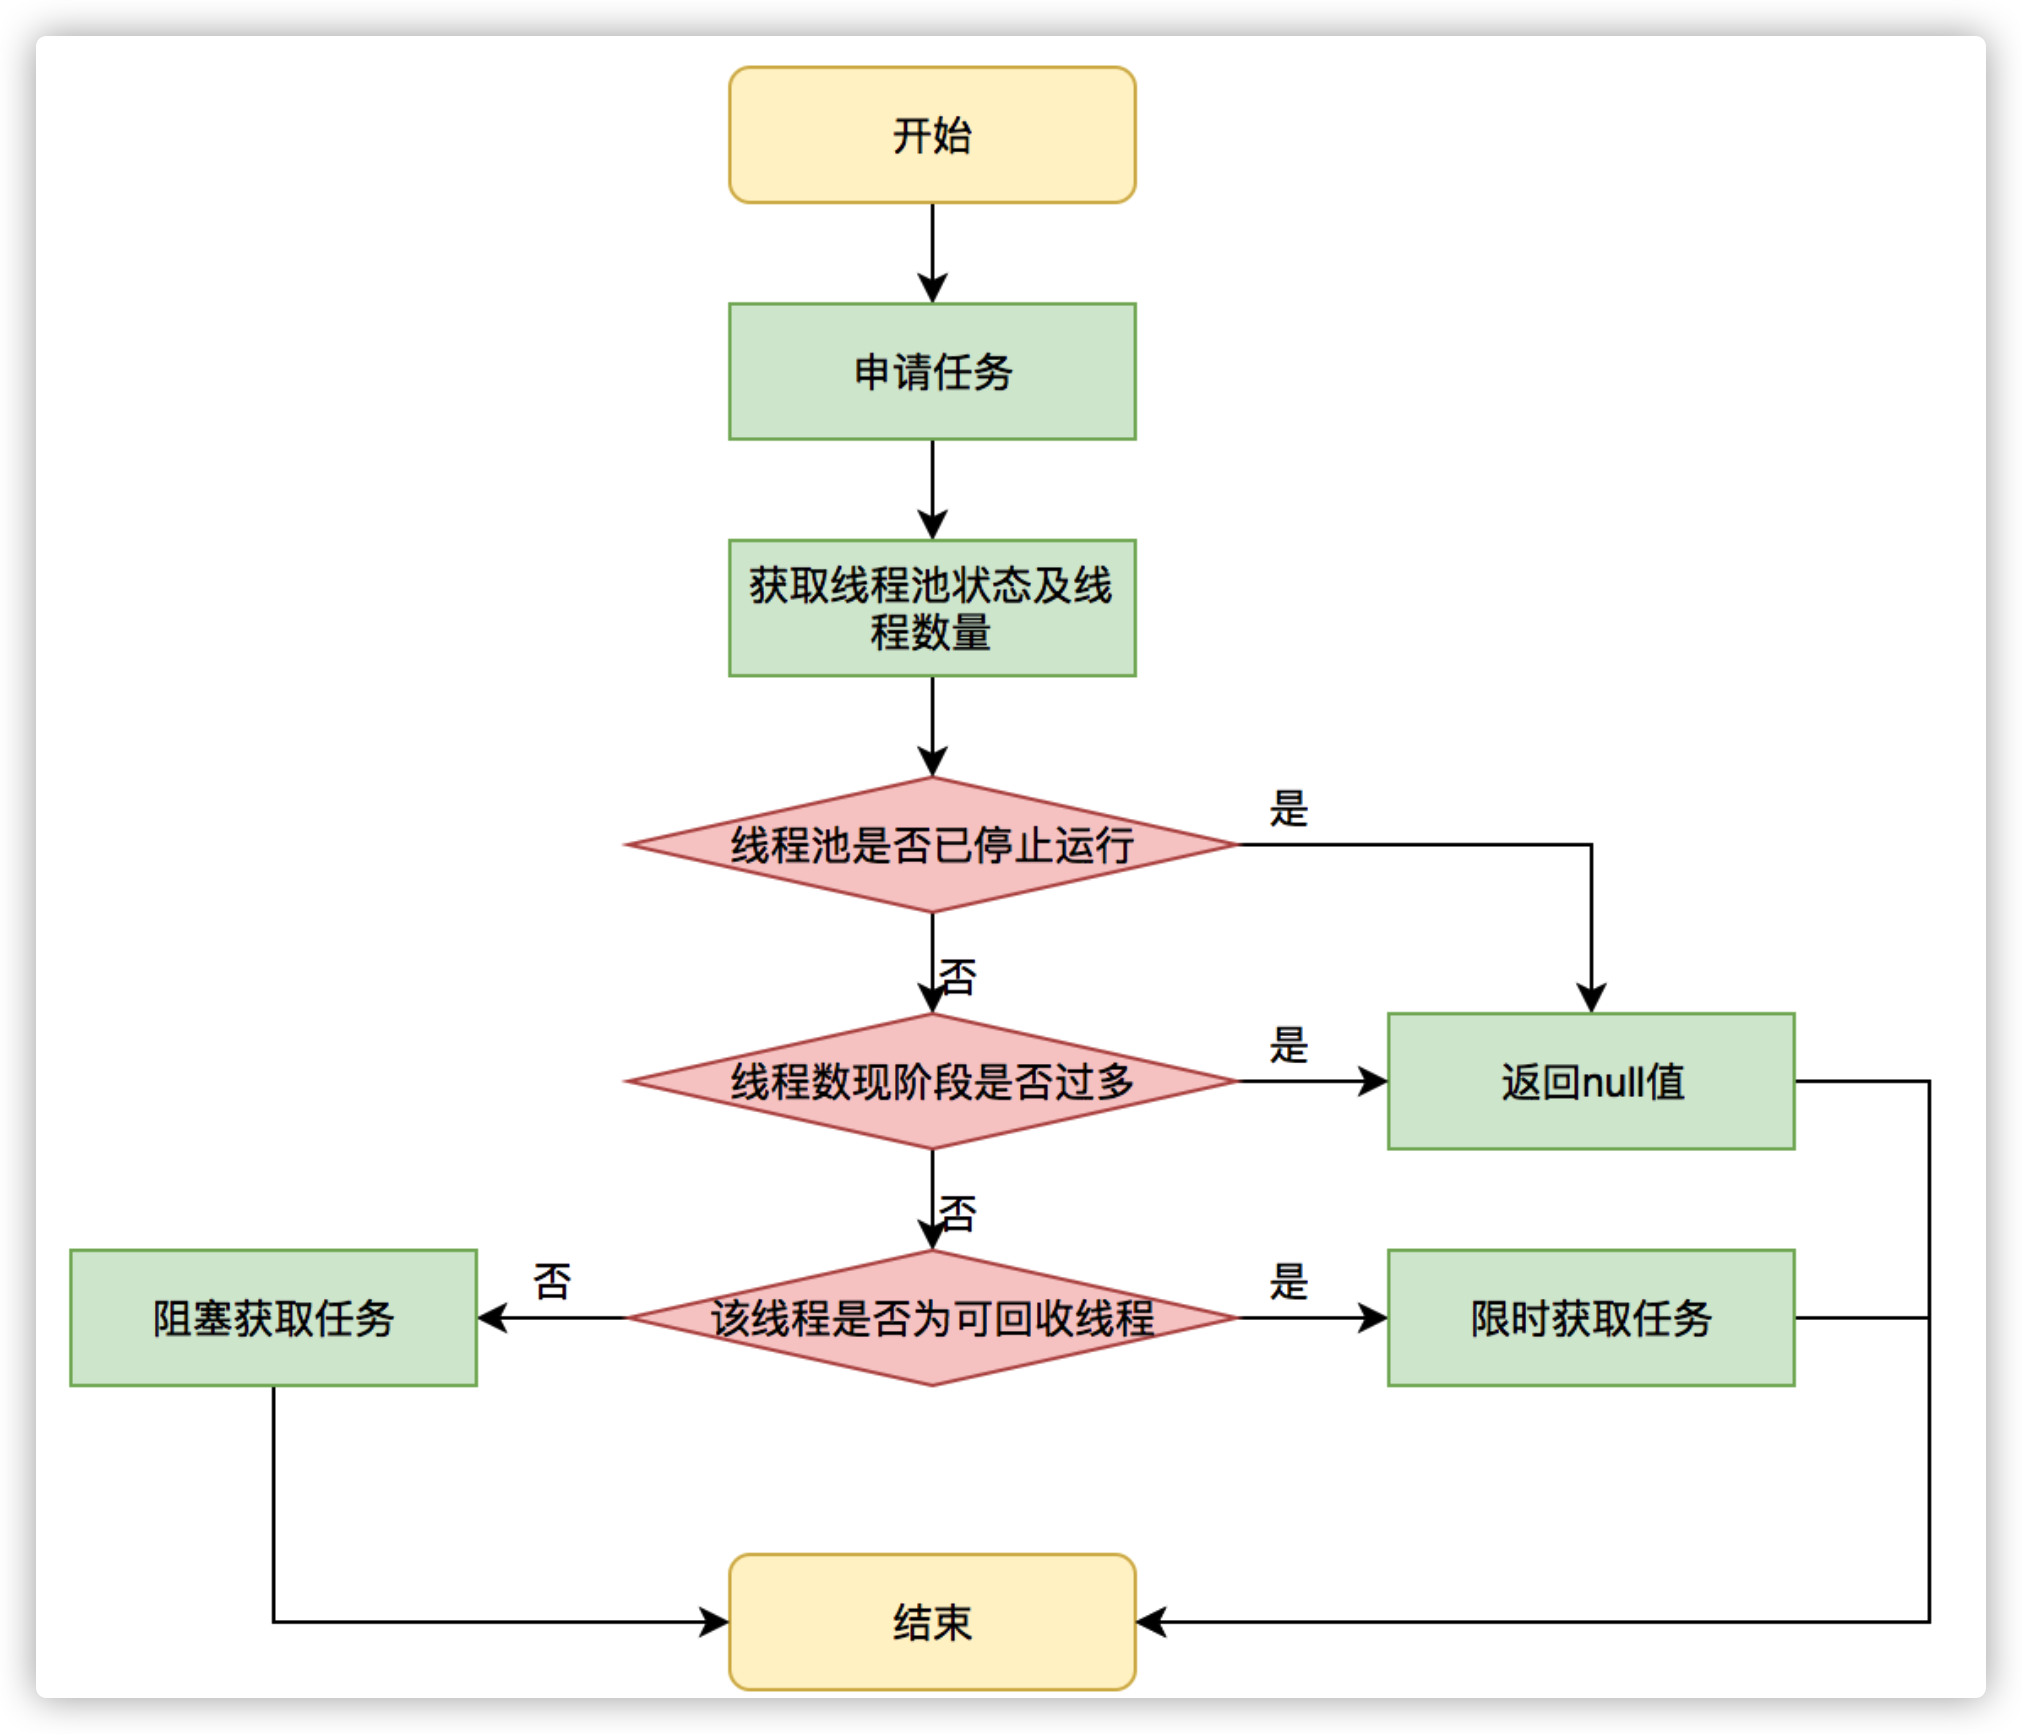
线程需要从任务缓存模块中不断地取任务执行,帮助线程从阻塞队列中获取任务,实现线程管理模块和任务管理模块之间的通信。这部分策略由getTask方法实现,其执行流程如下图所示:

图6 获取任务流程图

图6 获取任务流程图

getTask这部分进行了多次判断,为的是控制线程的数量,使其符合线程池的状态。如果线程池现在不应该持有那么多线程,则会返回null值。工作线程Worker会不断接收新任务去执行,而当工作线程Worker接收不到任务的时候,就会开始被回收。

2.3.4 任务拒绝

任务拒绝模块是线程池的保护部分,线程池有一个最大的容量,当线程池的任务缓存队列已满,并且线程池中的线程数目达到maximumPoolSize时,就需要拒绝掉该任务,采取任务拒绝策略,保护线程池。

拒绝策略是一个接口,其设计如下:

1
2
3
public interface RejectedExecutionHandler {
void rejectedExecution(Runnable r, ThreadPoolExecutor executor);
}

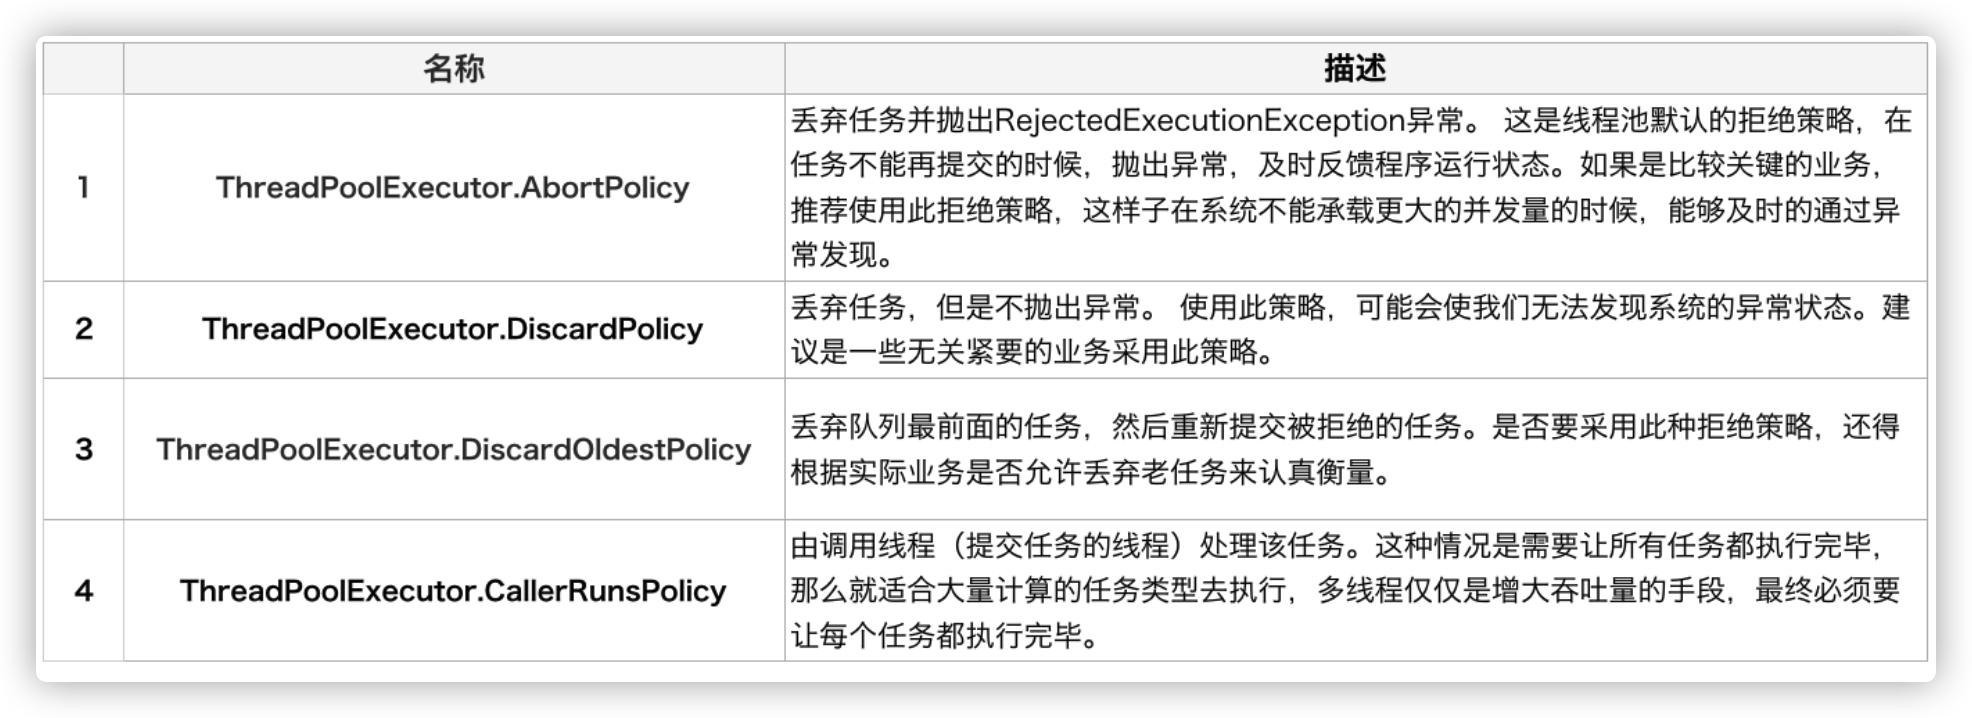
用户可以通过实现这个接口去定制拒绝策略,也可以选择JDK提供的四种已有拒绝策略,其特点如下:

img

2.4 Worker线程管理

2.4.1 Worker线程

线程池为了掌握线程的状态并维护线程的生命周期,设计了线程池内的工作线程Worker。我们来看一下它的部分代码:

1
2
3
4
private final class Worker extends AbstractQueuedSynchronizer implements Runnable{
final Thread thread;//Worker持有的线程
Runnable firstTask;//初始化的任务,可以为null
}

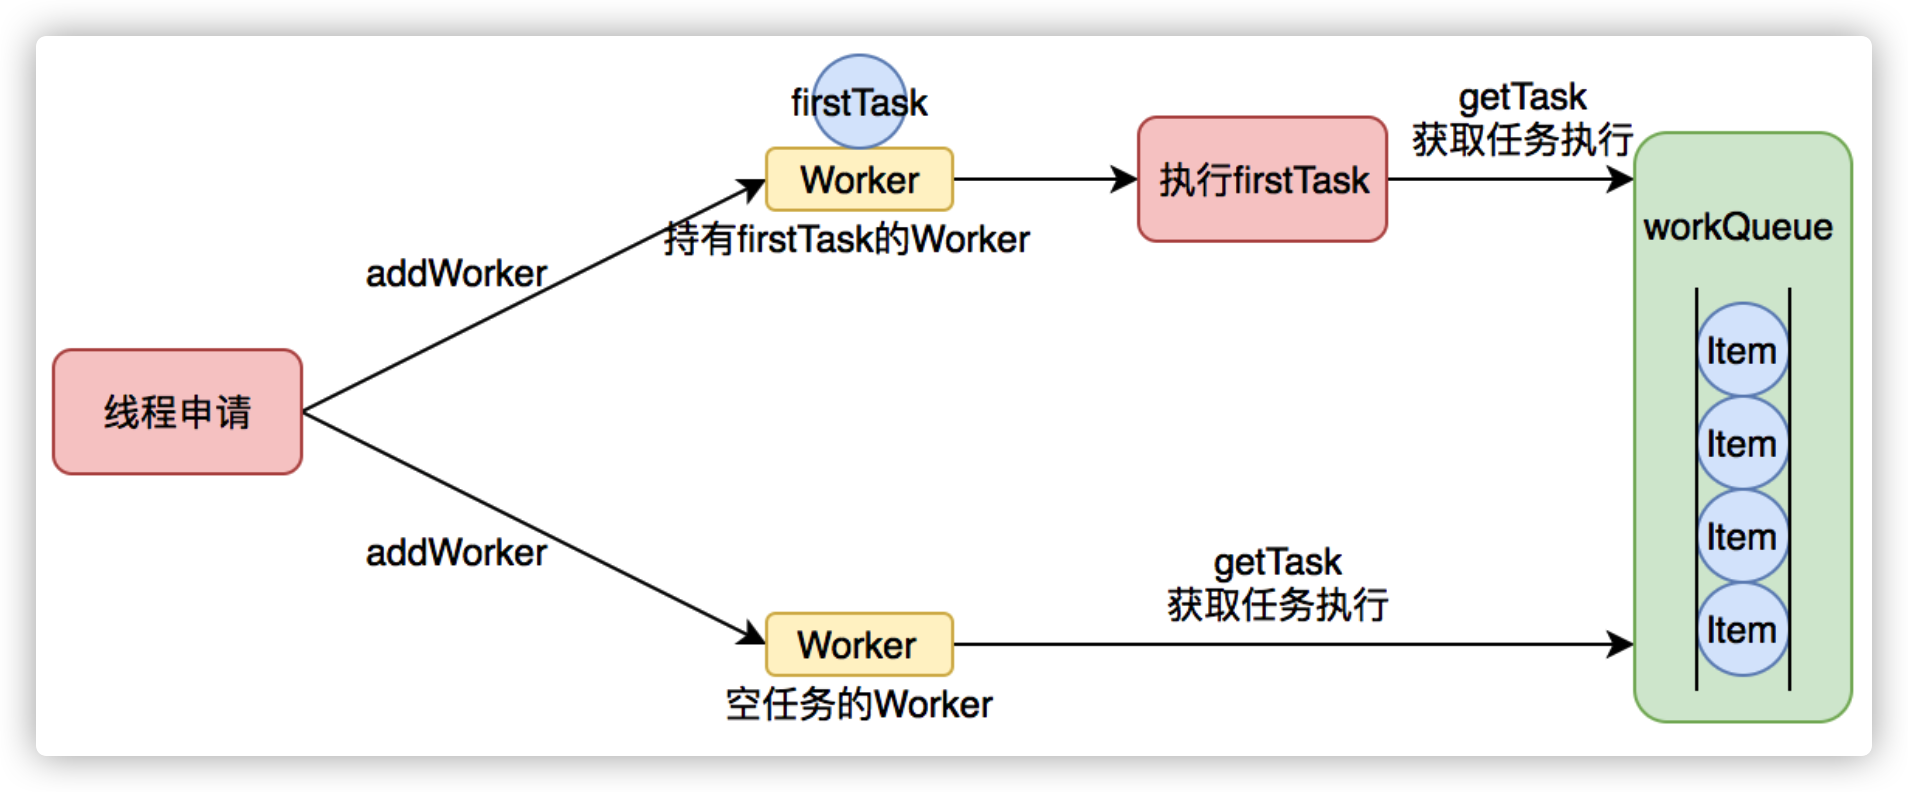
Worker这个工作线程,实现了Runnable接口,并持有一个线程thread,一个初始化的任务firstTask。thread是在调用构造方法时通过ThreadFactory来创建的线程,可以用来执行任务;firstTask用它来保存传入的第一个任务,这个任务可以有也可以为null。如果这个值是非空的,那么线程就会在启动初期立即执行这个任务,也就对应核心线程创建时的情况;如果这个值是null,那么就需要创建一个线程去执行任务列表(workQueue)中的任务,也就是非核心线程的创建。

Worker执行任务的模型如下图所示:

图7 Worker执行任务

图7 Worker执行任务

线程池需要管理线程的生命周期,需要在线程长时间不运行的时候进行回收。线程池使用一张Hash表去持有线程的引用,这样可以通过添加引用、移除引用这样的操作来控制线程的生命周期。这个时候重要的就是如何判断线程是否在运行。

Worker是通过继承AQS,使用AQS来实现独占锁这个功能。没有使用可重入锁ReentrantLock,而是使用AQS,为的就是实现不可重入的特性去反应线程现在的执行状态。

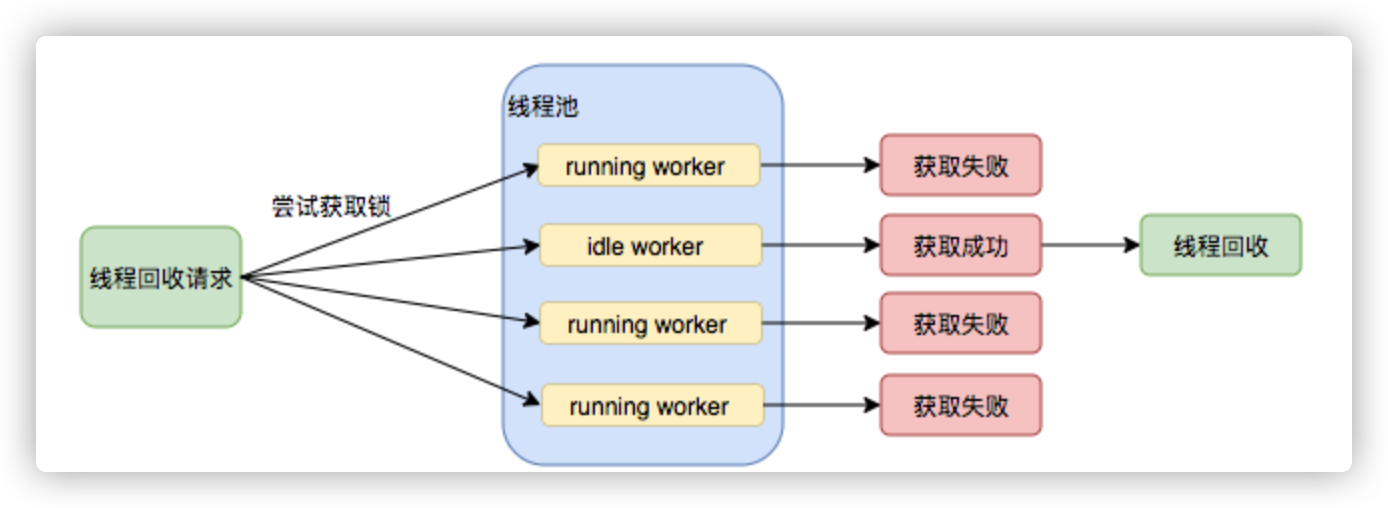
1.lock方法一旦获取了独占锁,表示当前线程正在执行任务中。 2.如果正在执行任务,则不应该中断线程。 3.如果该线程现在不是独占锁的状态,也就是空闲的状态,说明它没有在处理任务,这时可以对该线程进行中断。 4.线程池在执行shutdown方法或tryTerminate方法时会调用interruptIdleWorkers方法来中断空闲的线程,interruptIdleWorkers方法会使用tryLock方法来判断线程池中的线程是否是空闲状态;如果线程是空闲状态则可以安全回收。

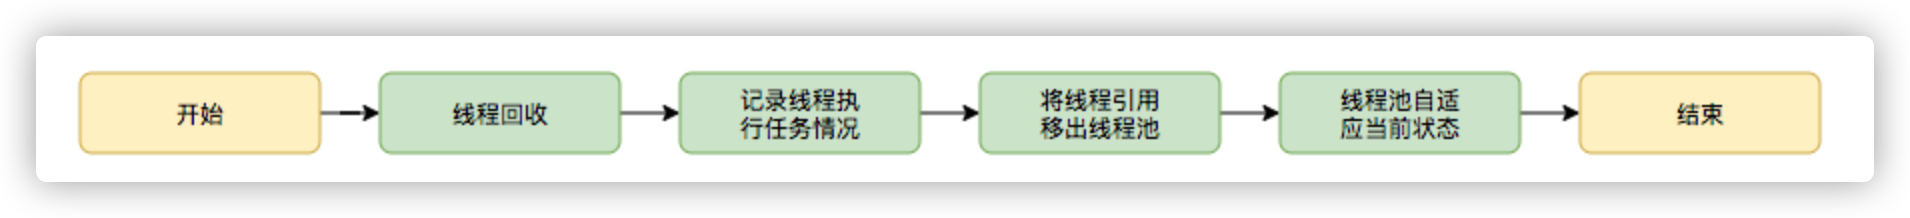
在线程回收过程中就使用到了这种特性,回收过程如下图所示:

图8 线程池回收过程

图8 线程池回收过程

2.4.2 Worker线程增加

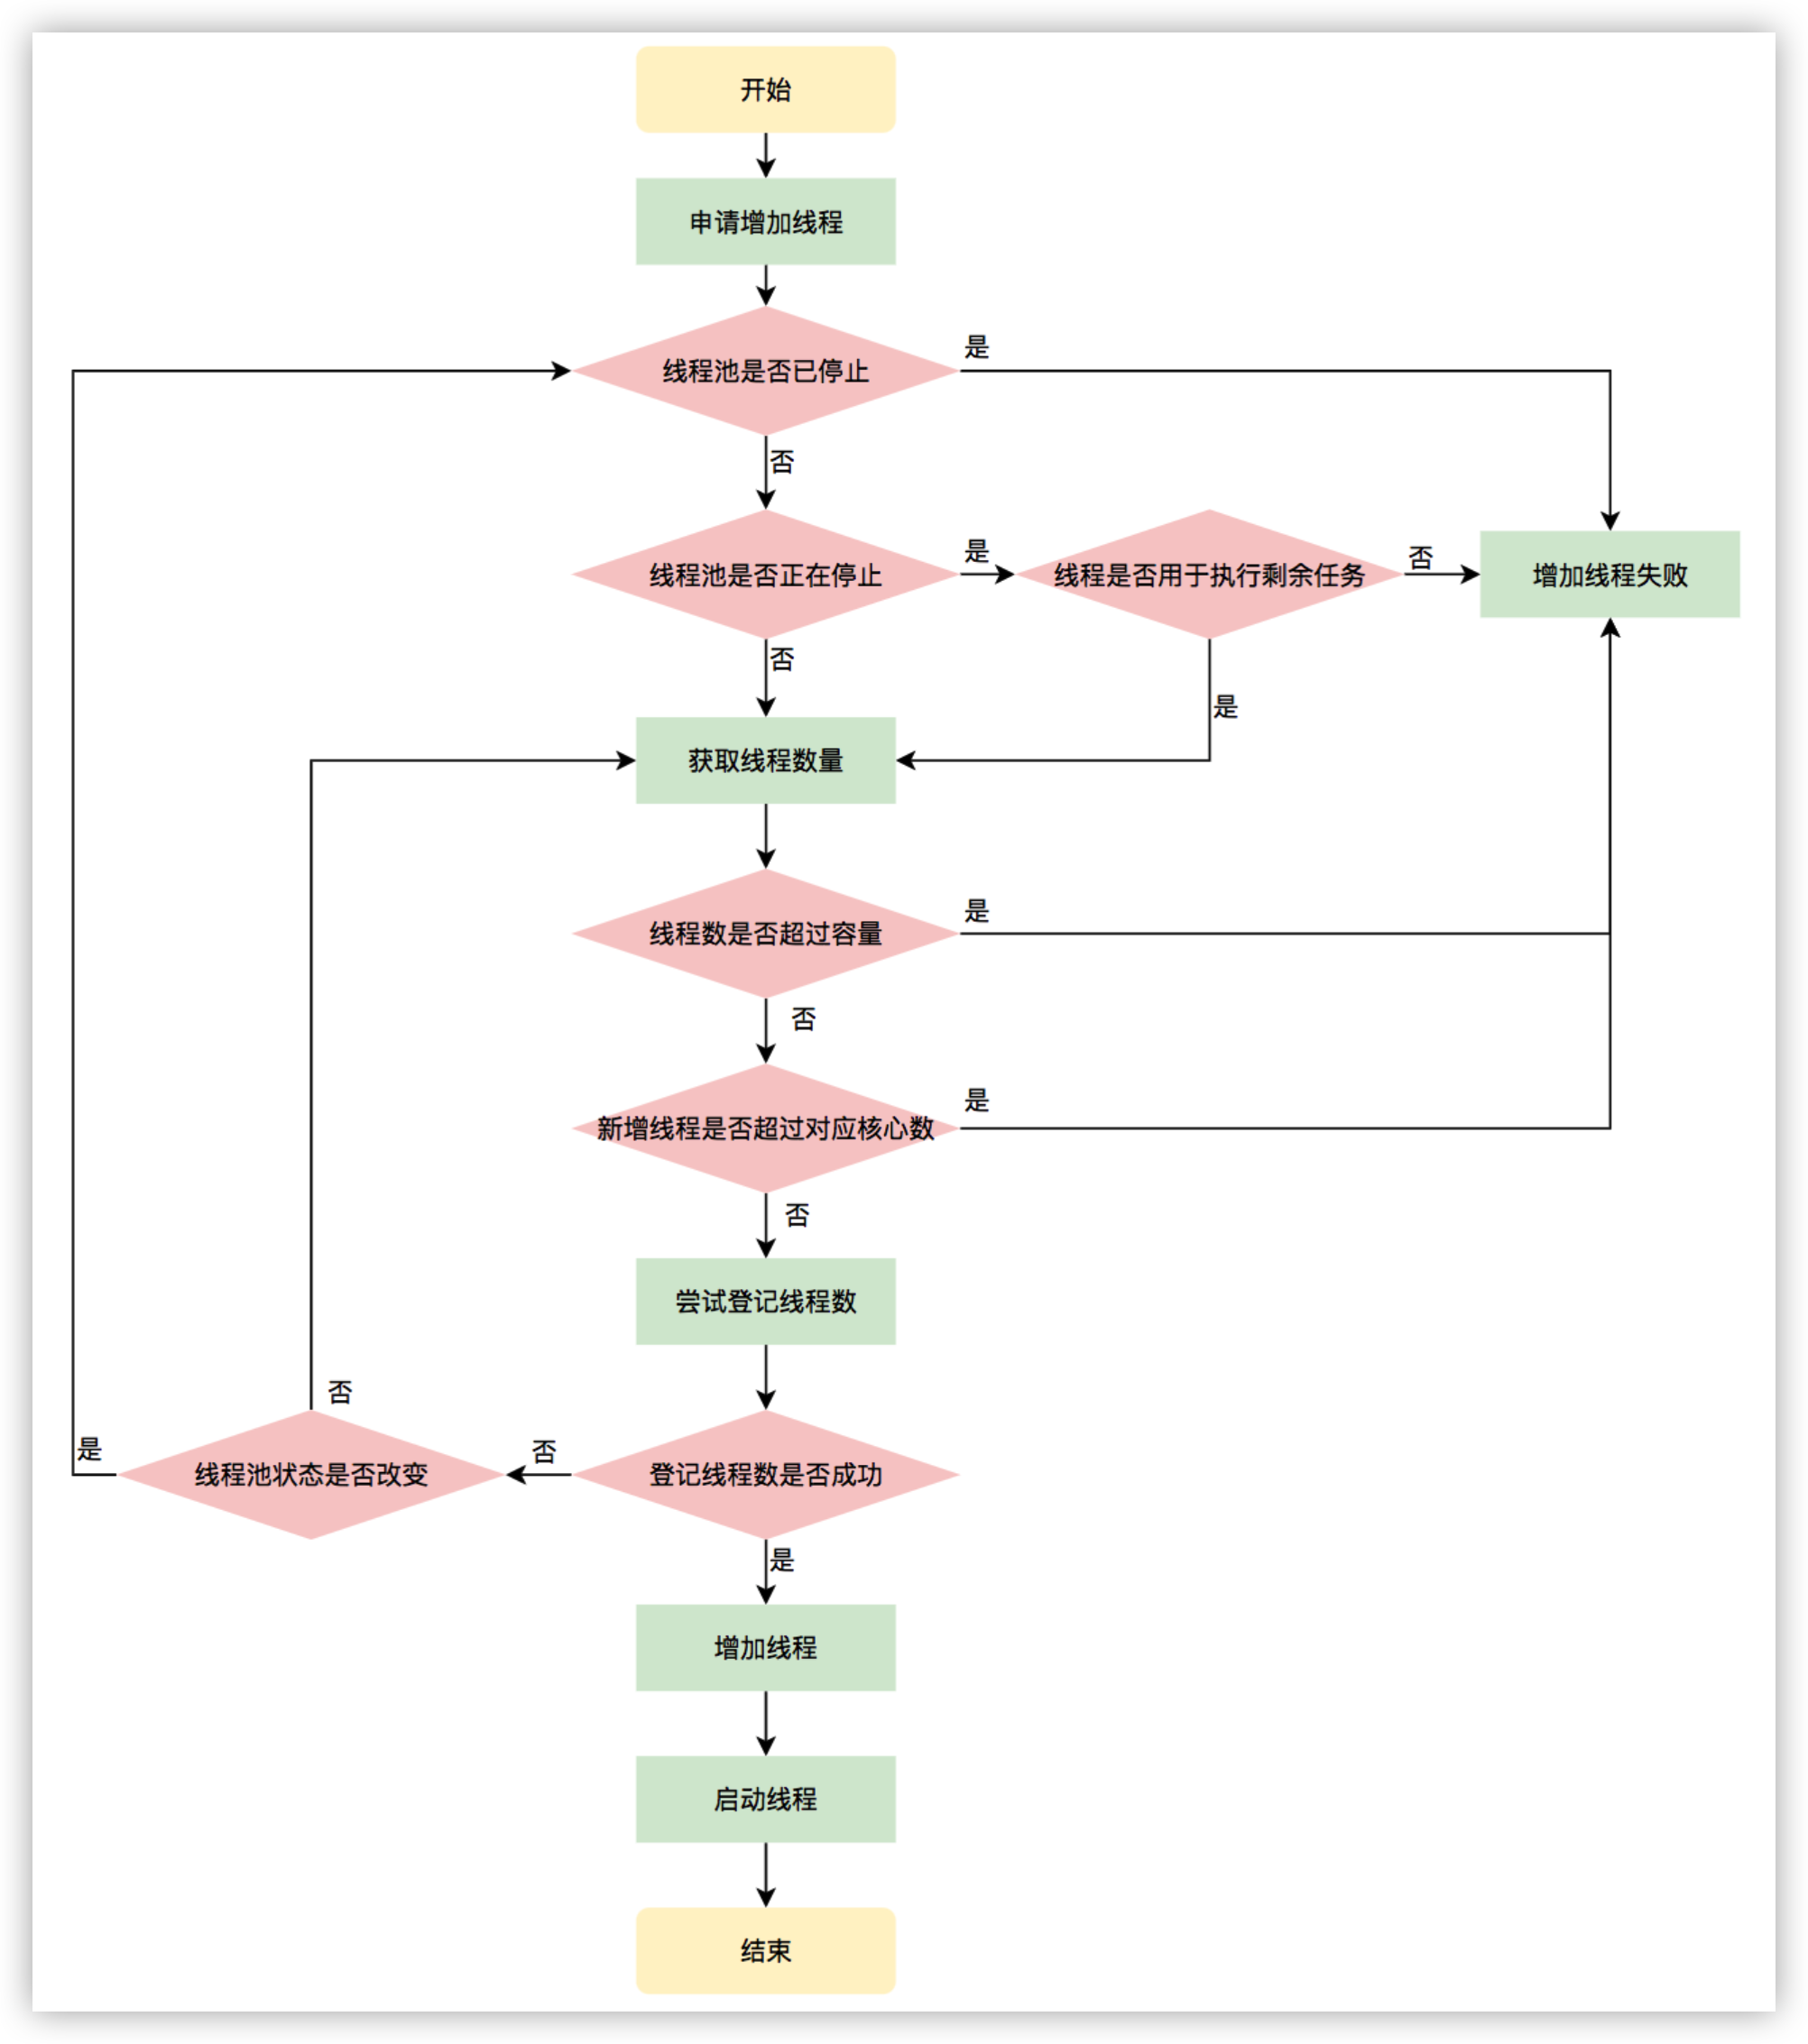
增加线程是通过线程池中的addWorker方法,该方法的功能就是增加一个线程,该方法不考虑线程池是在哪个阶段增加的该线程,这个分配线程的策略是在上个步骤完成的,该步骤仅仅完成增加线程,并使它运行,最后返回是否成功这个结果。addWorker方法有两个参数:firstTask、core。firstTask参数用于指定新增的线程执行的第一个任务,该参数可以为空;core参数为true表示在新增线程时会判断当前活动线程数是否少于corePoolSize,false表示新增线程前需要判断当前活动线程数是否少于maximumPoolSize,其执行流程如下图所示:

图9 申请线程执行流程图

图9 申请线程执行流程图

2.4.3 Worker线程回收

线程池中线程的销毁依赖JVM自动的回收,线程池做的工作是根据当前线程池的状态维护一定数量的线程引用,防止这部分线程被JVM回收,当线程池决定哪些线程需要回收时,只需要将其引用消除即可。Worker被创建出来后,就会不断地进行轮询,然后获取任务去执行,核心线程可以无限等待获取任务,非核心线程要限时获取任务。当Worker无法获取到任务,也就是获取的任务为空时,循环会结束,Worker会主动消除自身在线程池内的引用。

1
2
3
4
5
6
7
try {
while (task != null || (task = getTask()) != null) {
//执行任务
}
} finally {
processWorkerExit(w, completedAbruptly);//获取不到任务时,主动回收自己
}

线程回收的工作是在processWorkerExit方法完成的。

图10 线程销毁流程

图10 线程销毁流程

事实上,在这个方法中,将线程引用移出线程池就已经结束了线程销毁的部分。但由于引起线程销毁的可能性有很多,线程池还要判断是什么引发了这次销毁,是否要改变线程池的现阶段状态,是否要根据新状态,重新分配线程。

2.4.4 Worker线程执行任务

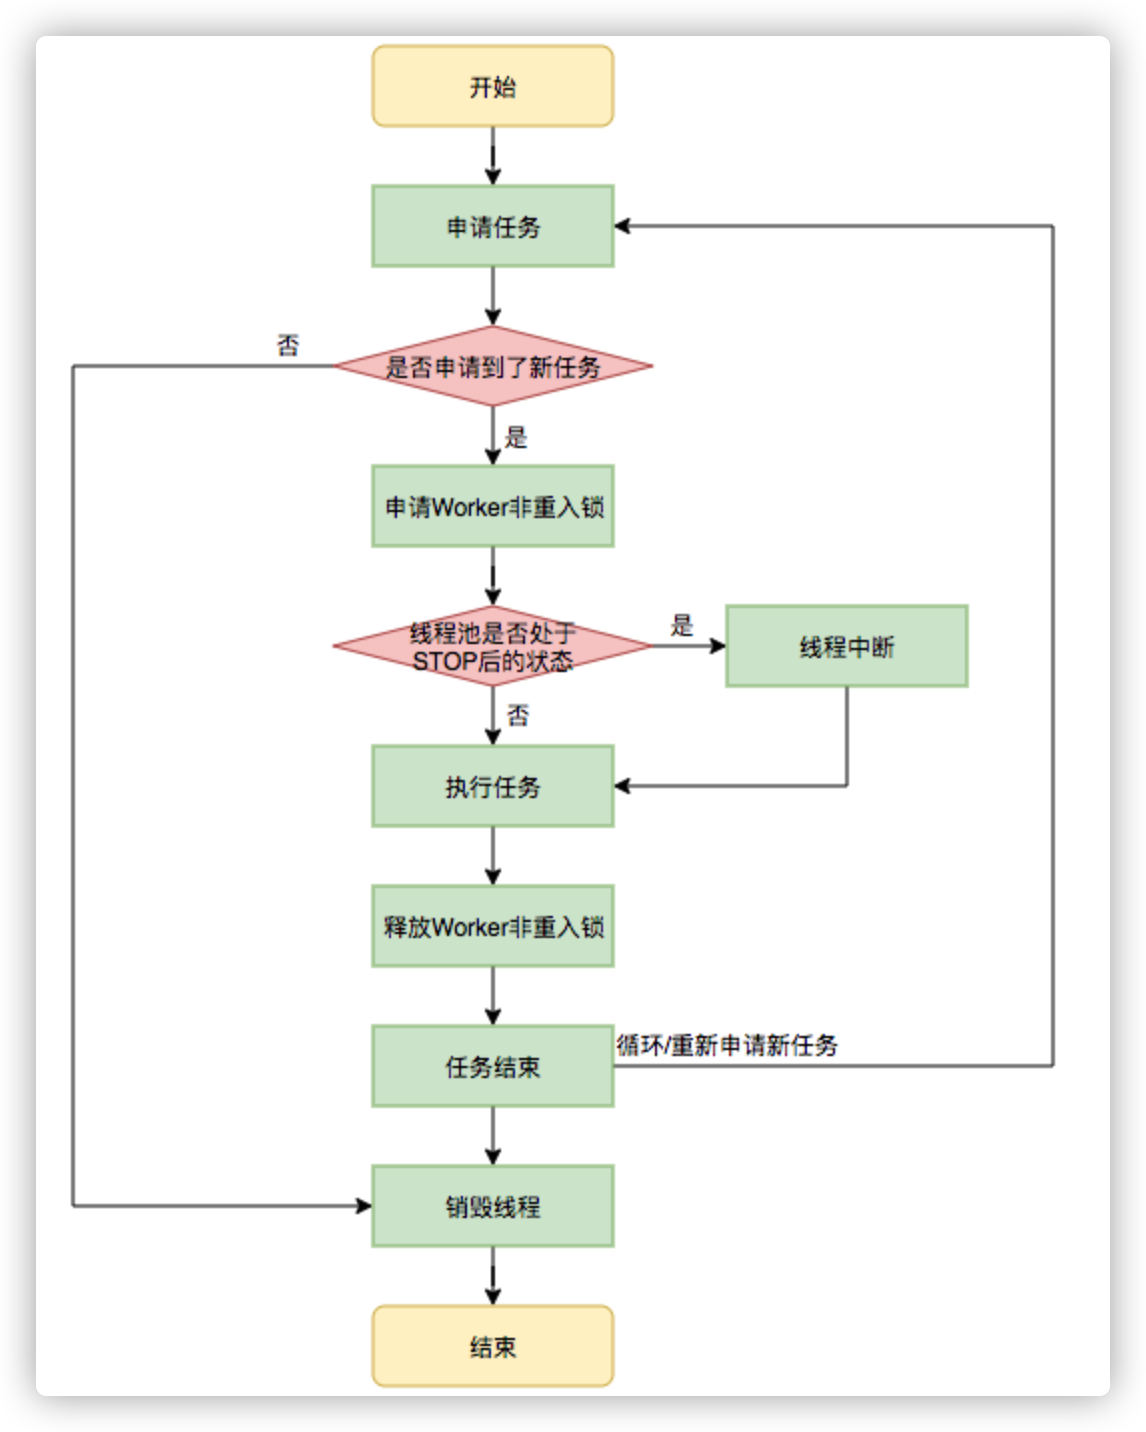
在Worker类中的run方法调用了runWorker方法来执行任务,runWorker方法的执行过程如下:

1.while循环不断地通过getTask()方法获取任务。 2.getTask()方法从阻塞队列中取任务。 3.如果线程池正在停止,那么要保证当前线程是中断状态,否则要保证当前线程不是中断状态。 4.执行任务。 5.如果getTask结果为null则跳出循环,执行processWorkerExit()方法,销毁线程。

执行流程如下图所示:

图11 执行任务流程

图11 执行任务流程

三、线程池在业务中的实践

3.1 业务背景

在当今的互联网业界,为了最大程度利用CPU的多核性能,并行运算的能力是不可或缺的。通过线程池管理线程获取并发性是一个非常基础的操作,让我们来看两个典型的使用线程池获取并发性的场景。

场景1:快速响应用户请求

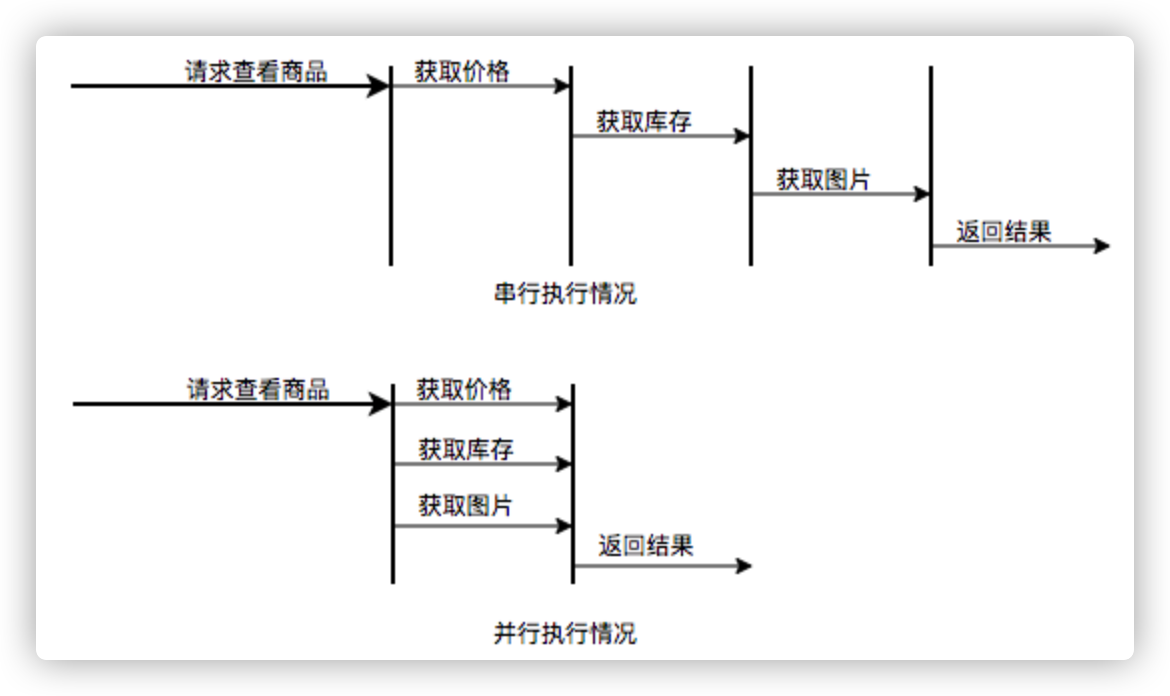
描述:用户发起的实时请求,服务追求响应时间。比如说用户要查看一个商品的信息,那么我们需要将商品维度的一系列信息如商品的价格、优惠、库存、图片等等聚合起来,展示给用户。

分析:从用户体验角度看,这个结果响应的越快越好,如果一个页面半天都刷不出,用户可能就放弃查看这个商品了。而面向用户的功能聚合通常非常复杂,伴随着调用与调用之间的级联、多级级联等情况,业务开发同学往往会选择使用线程池这种简单的方式,将调用封装成任务并行的执行,缩短总体响应时间。另外,使用线程池也是有考量的,这种场景最重要的就是获取最大的响应速度去满足用户,所以应该不设置队列去缓冲并发任务,调高corePoolSize和maxPoolSize去尽可能创造多的线程快速执行任务。

图12 并行执行任务提升任务响应速度

图12 并行执行任务提升任务响应速度

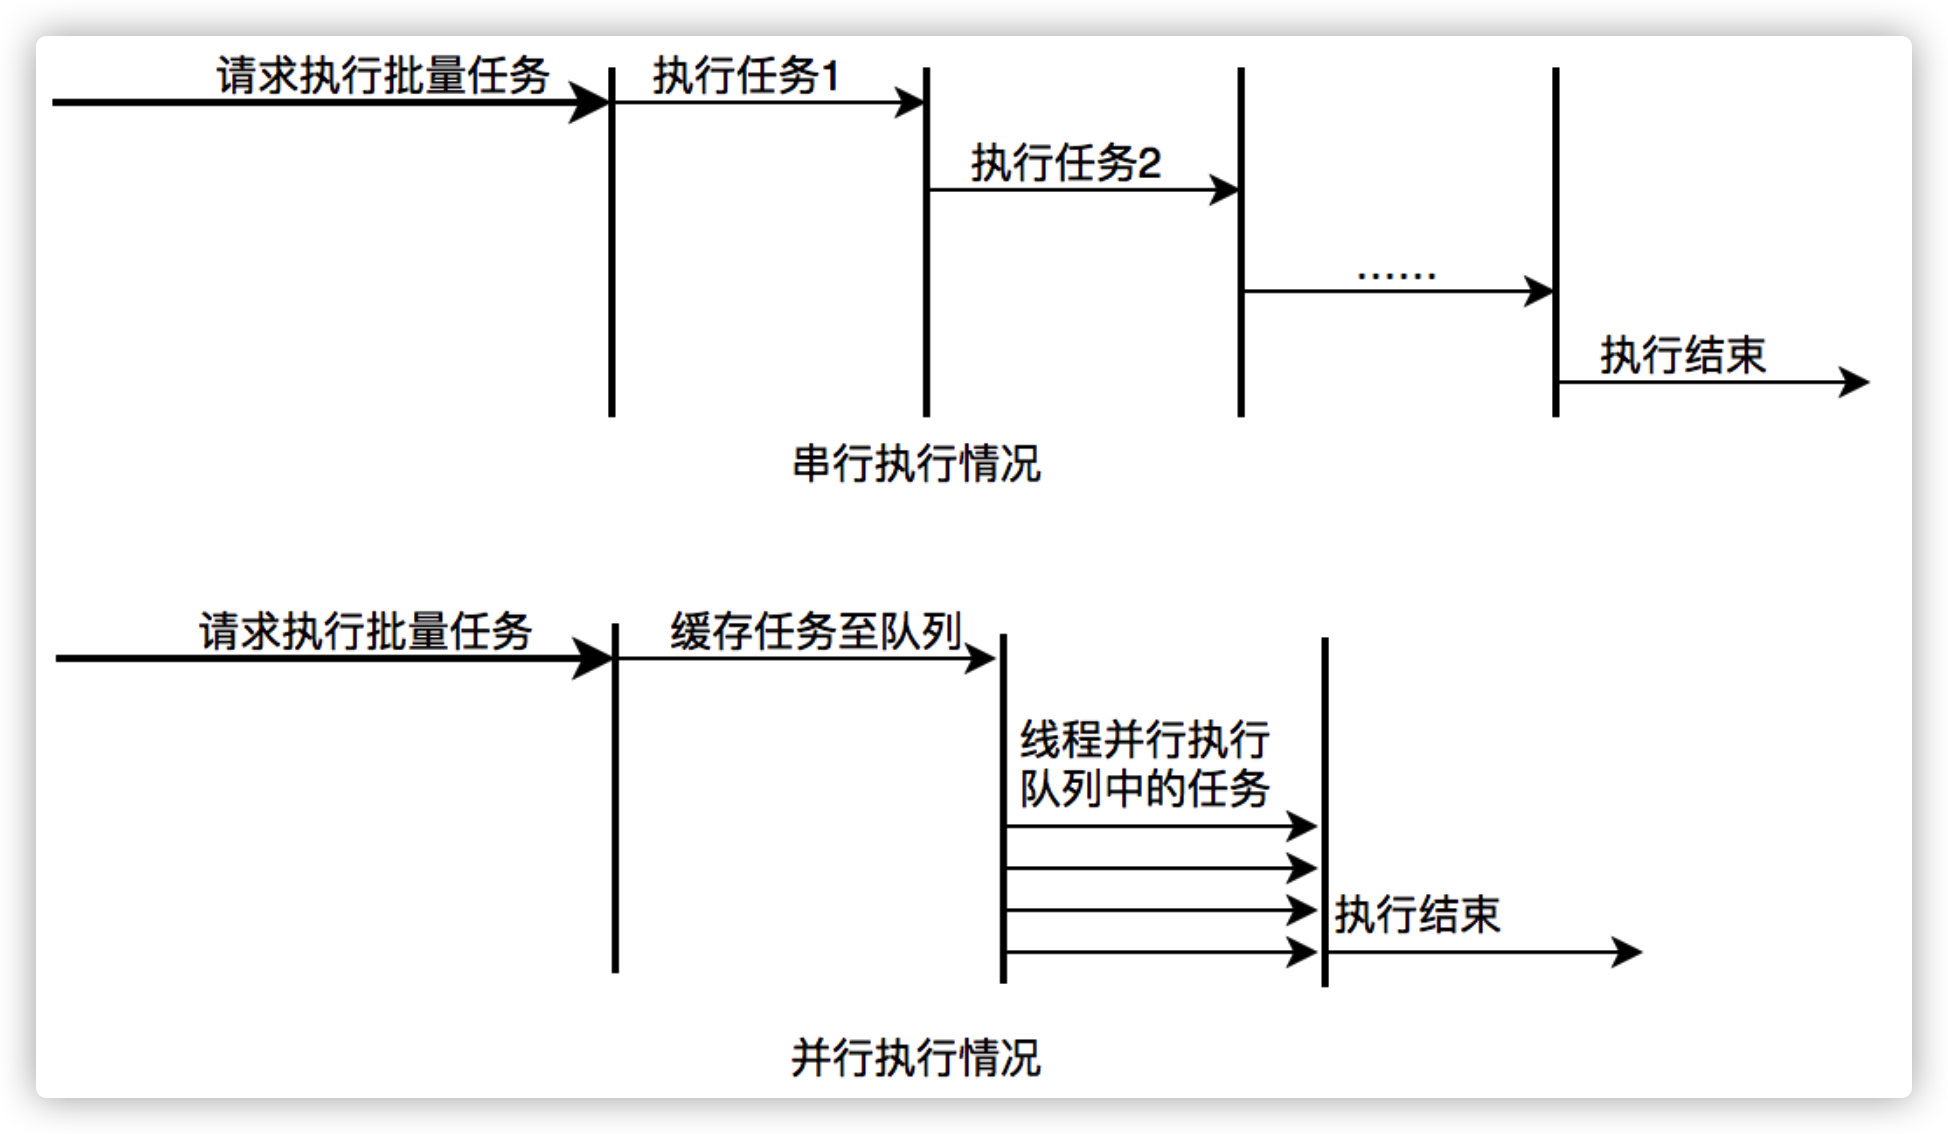
场景2:快速处理批量任务

描述:离线的大量计算任务,需要快速执行。比如说,统计某个报表,需要计算出全国各个门店中有哪些商品有某种属性,用于后续营销策略的分析,那么我们需要查询全国所有门店中的所有商品,并且记录具有某属性的商品,然后快速生成报表。

分析:这种场景需要执行大量的任务,我们也会希望任务执行的越快越好。这种情况下,也应该使用多线程策略,并行计算。但与响应速度优先的场景区别在于,这类场景任务量巨大,并不需要瞬时的完成,而是关注如何使用有限的资源,尽可能在单位时间内处理更多的任务,也就是吞吐量优先的问题。所以应该设置队列去缓冲并发任务,调整合适的corePoolSize去设置处理任务的线程数。在这里,设置的线程数过多可能还会引发线程上下文切换频繁的问题,也会降低处理任务的速度,降低吞吐量。

图13 并行执行任务提升批量任务执行速度

图13 并行执行任务提升批量任务执行速度

3.2 实际问题及方案思考

线程池使用面临的核心的问题在于:线程池的参数并不好配置。一方面线程池的运行机制不是很好理解,配置合理需要强依赖开发人员的个人经验和知识;另一方面,线程池执行的情况和任务类型相关性较大,IO密集型和CPU密集型的任务运行起来的情况差异非常大,这导致业界并没有一些成熟的经验策略帮助开发人员参考。

关于线程池配置不合理引发的故障,公司内部有较多记录,下面举一些例子:

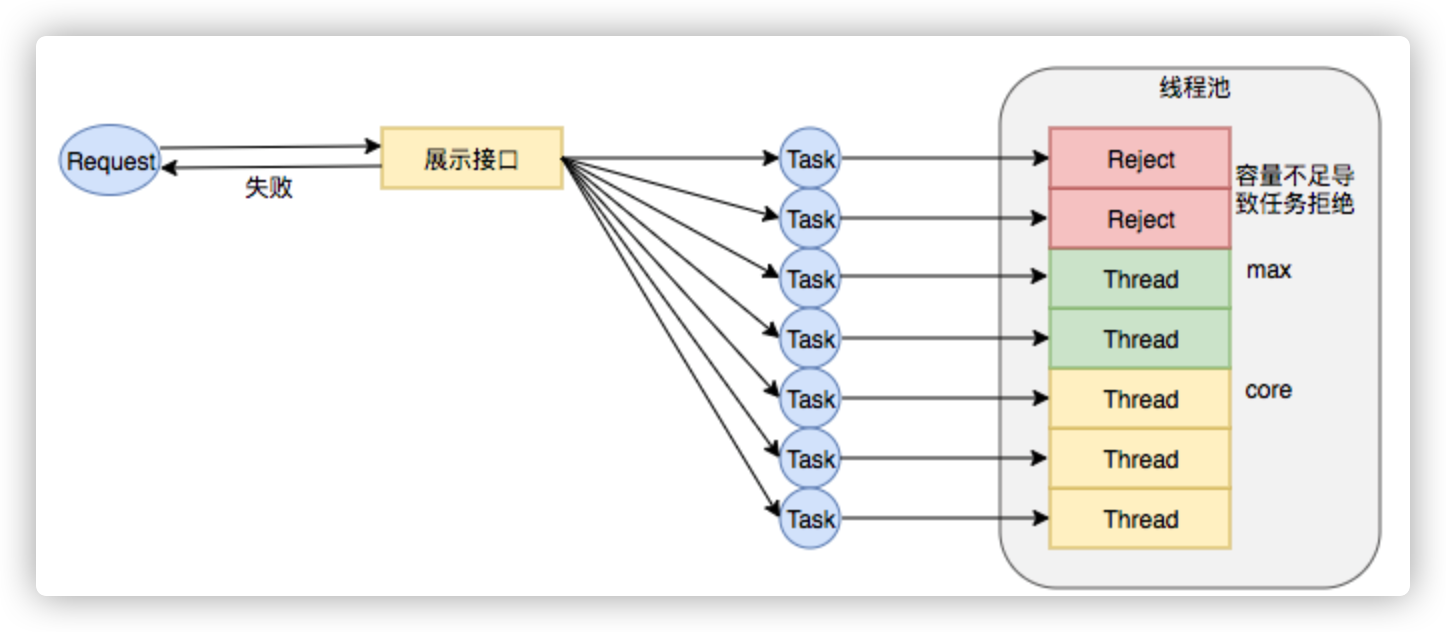
Case1:2018年XX页面展示接口大量调用降级:

事故描述:XX页面展示接口产生大量调用降级,数量级在几十到上百。

事故原因:该服务展示接口内部逻辑使用线程池做并行计算,由于没有预估好调用的流量,导致最大核心数设置偏小,大量抛出RejectedExecutionException,触发接口降级条件,示意图如下:

图14 线程数核心设置过小引发RejectExecutionException

图14 线程数核心设置过小引发RejectExecutionException

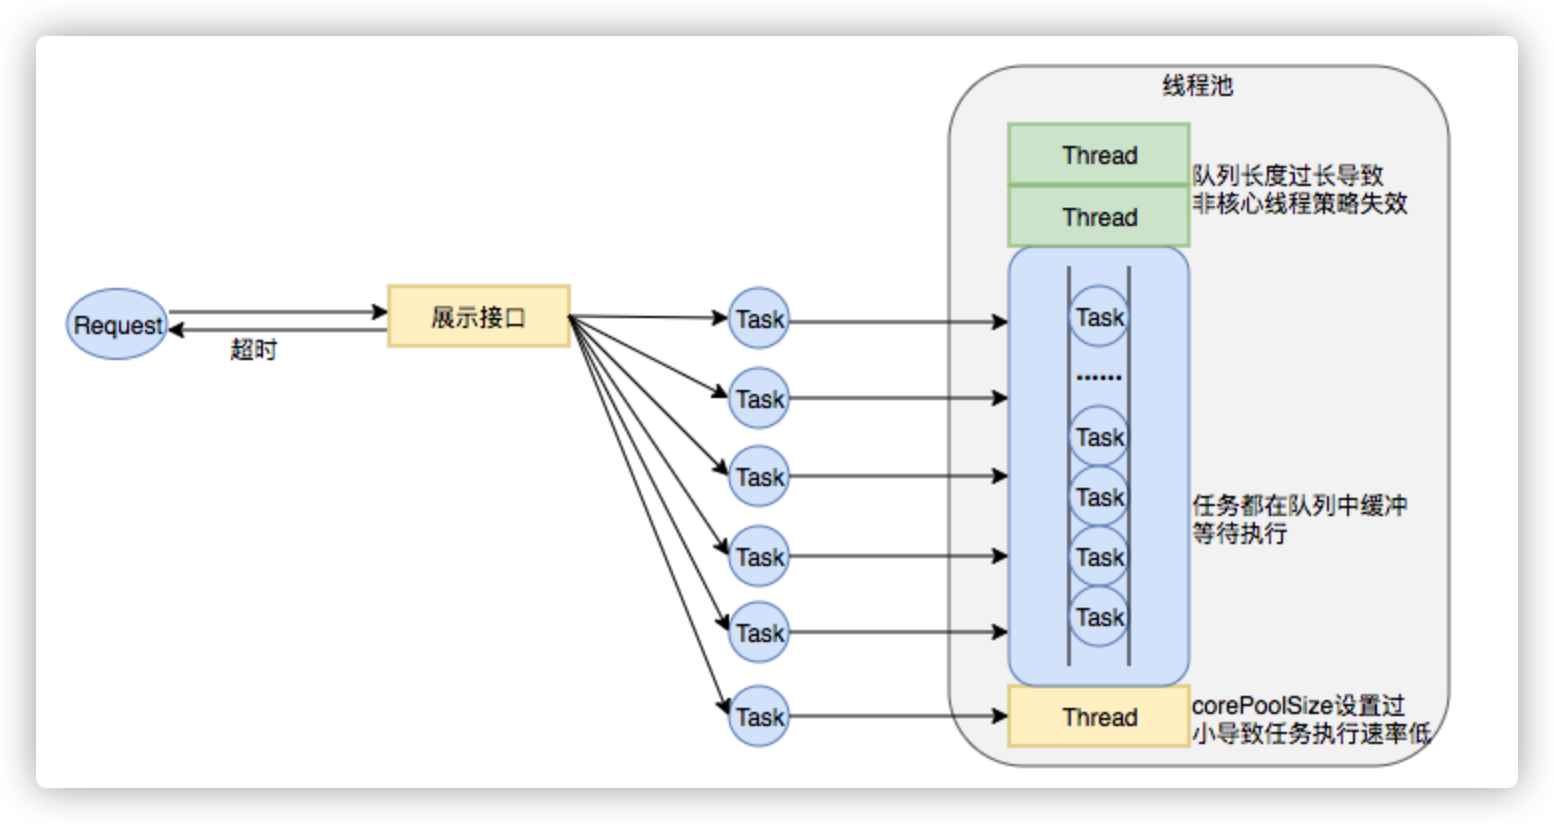
Case2:2018年XX业务服务不可用S2级故障

事故描述:XX业务提供的服务执行时间过长,作为上游服务整体超时,大量下游服务调用失败。

事故原因:该服务处理请求内部逻辑使用线程池做资源隔离,由于队列设置过长,最大线程数设置失效,导致请求数量增加时,大量任务堆积在队列中,任务执行时间过长,最终导致下游服务的大量调用超时失败。示意图如下:

图15 线程池队列长度设置过长、corePoolSize设置过小导致任务执行速度低

图15 线程池队列长度设置过长、corePoolSize设置过小导致任务执行速度低

业务中要使用线程池,而使用不当又会导致故障,那么我们怎样才能更好地使用线程池呢?针对这个问题,我们下面延展几个方向:

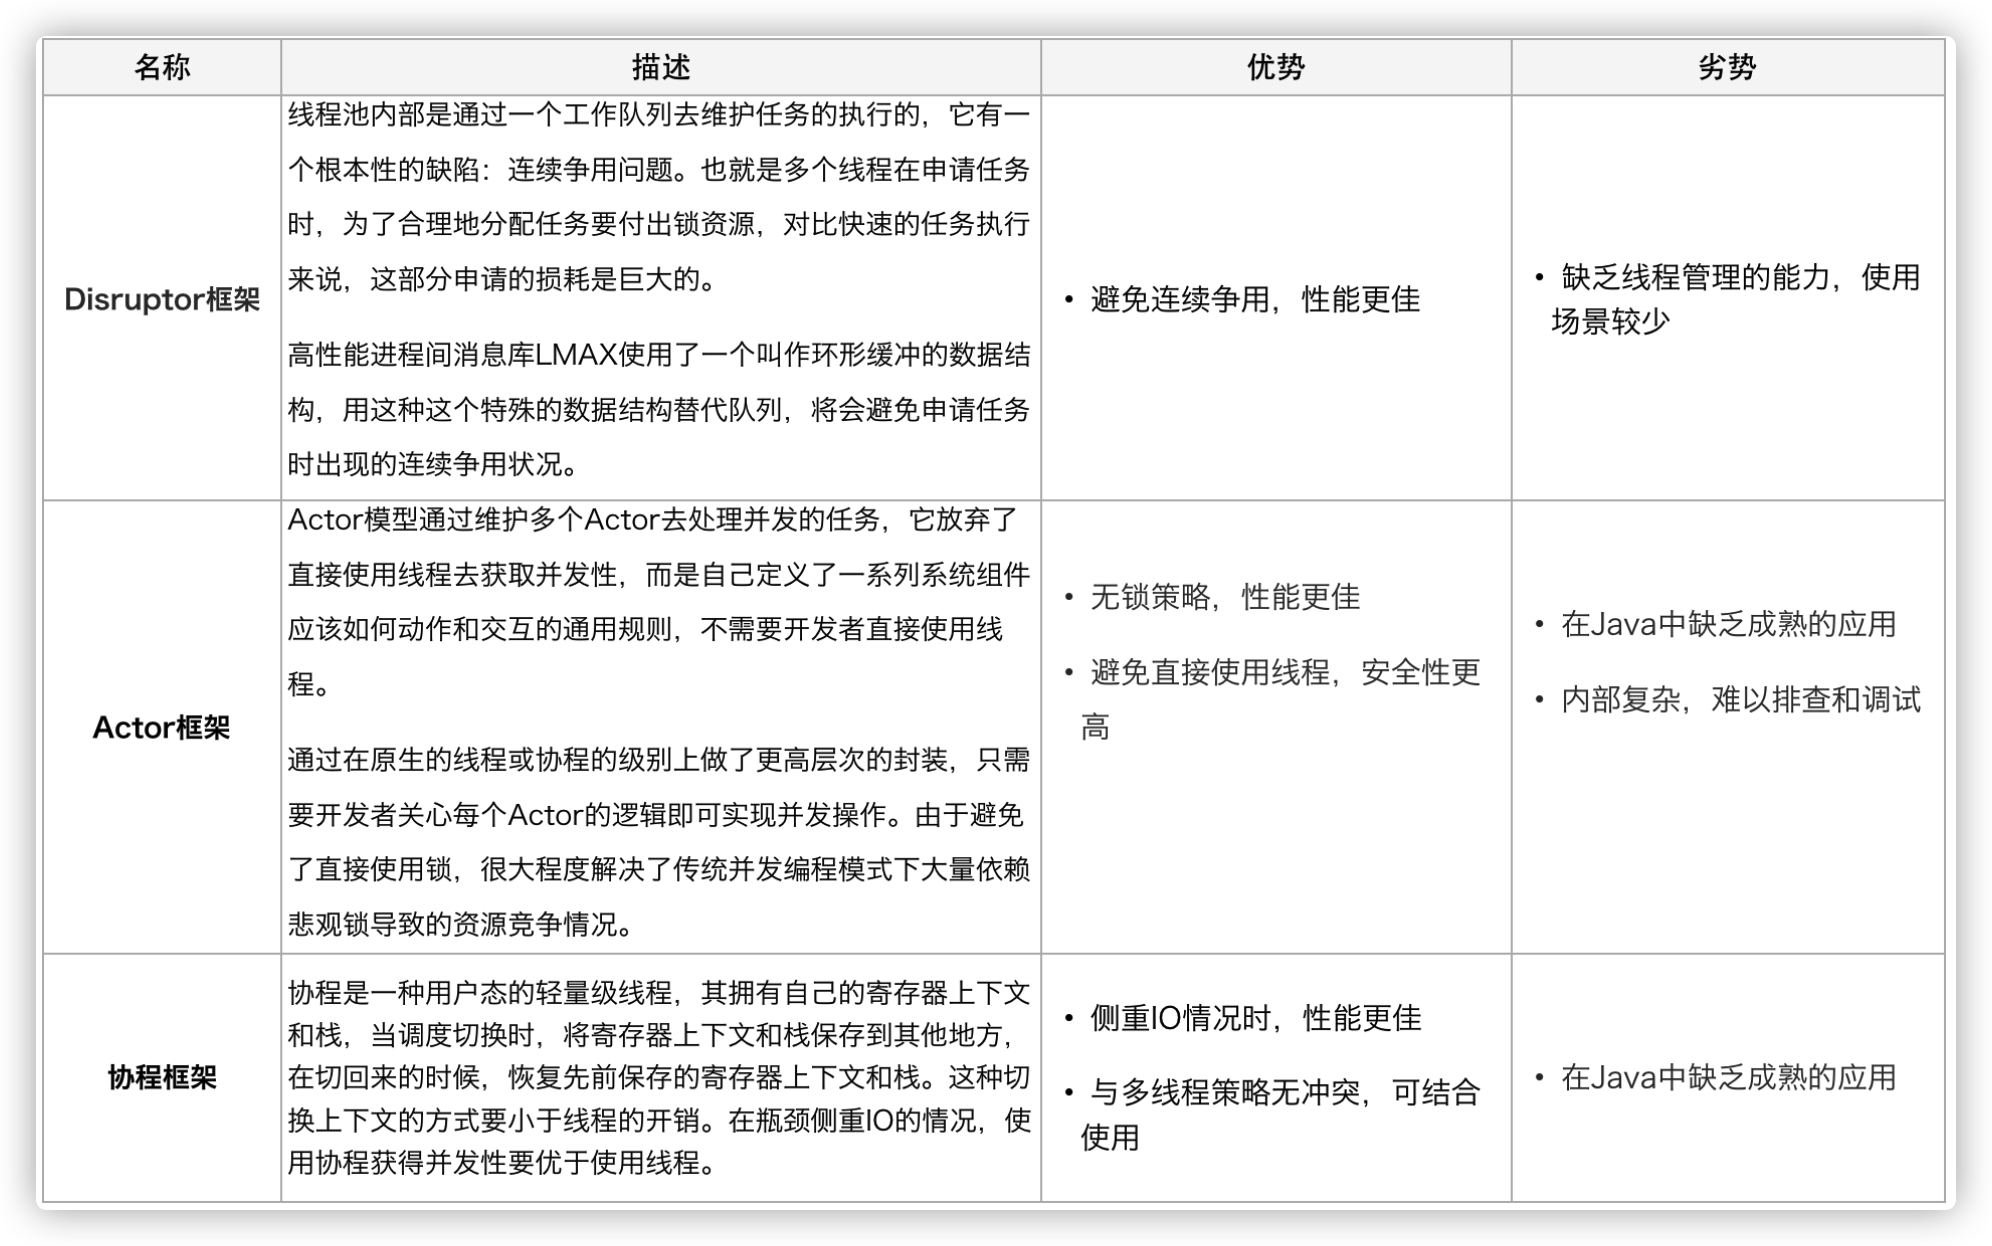
1. 能否不用线程池?

回到最初的问题,业务使用线程池是为了获取并发性,对于获取并发性,是否可以有什么其他的方案呢替代?我们尝试进行了一些其他方案的调研:

img

综合考虑,这些新的方案都能在某种情况下提升并行任务的性能,然而本次重点解决的问题是如何更简易、更安全地获得的并发性。另外,Actor模型的应用实际上甚少,只在Scala中使用广泛,协程框架在Java中维护的也不成熟。这三者现阶段都不是足够的易用,也并不能解决业务上现阶段的问题。

2. 追求参数设置合理性?

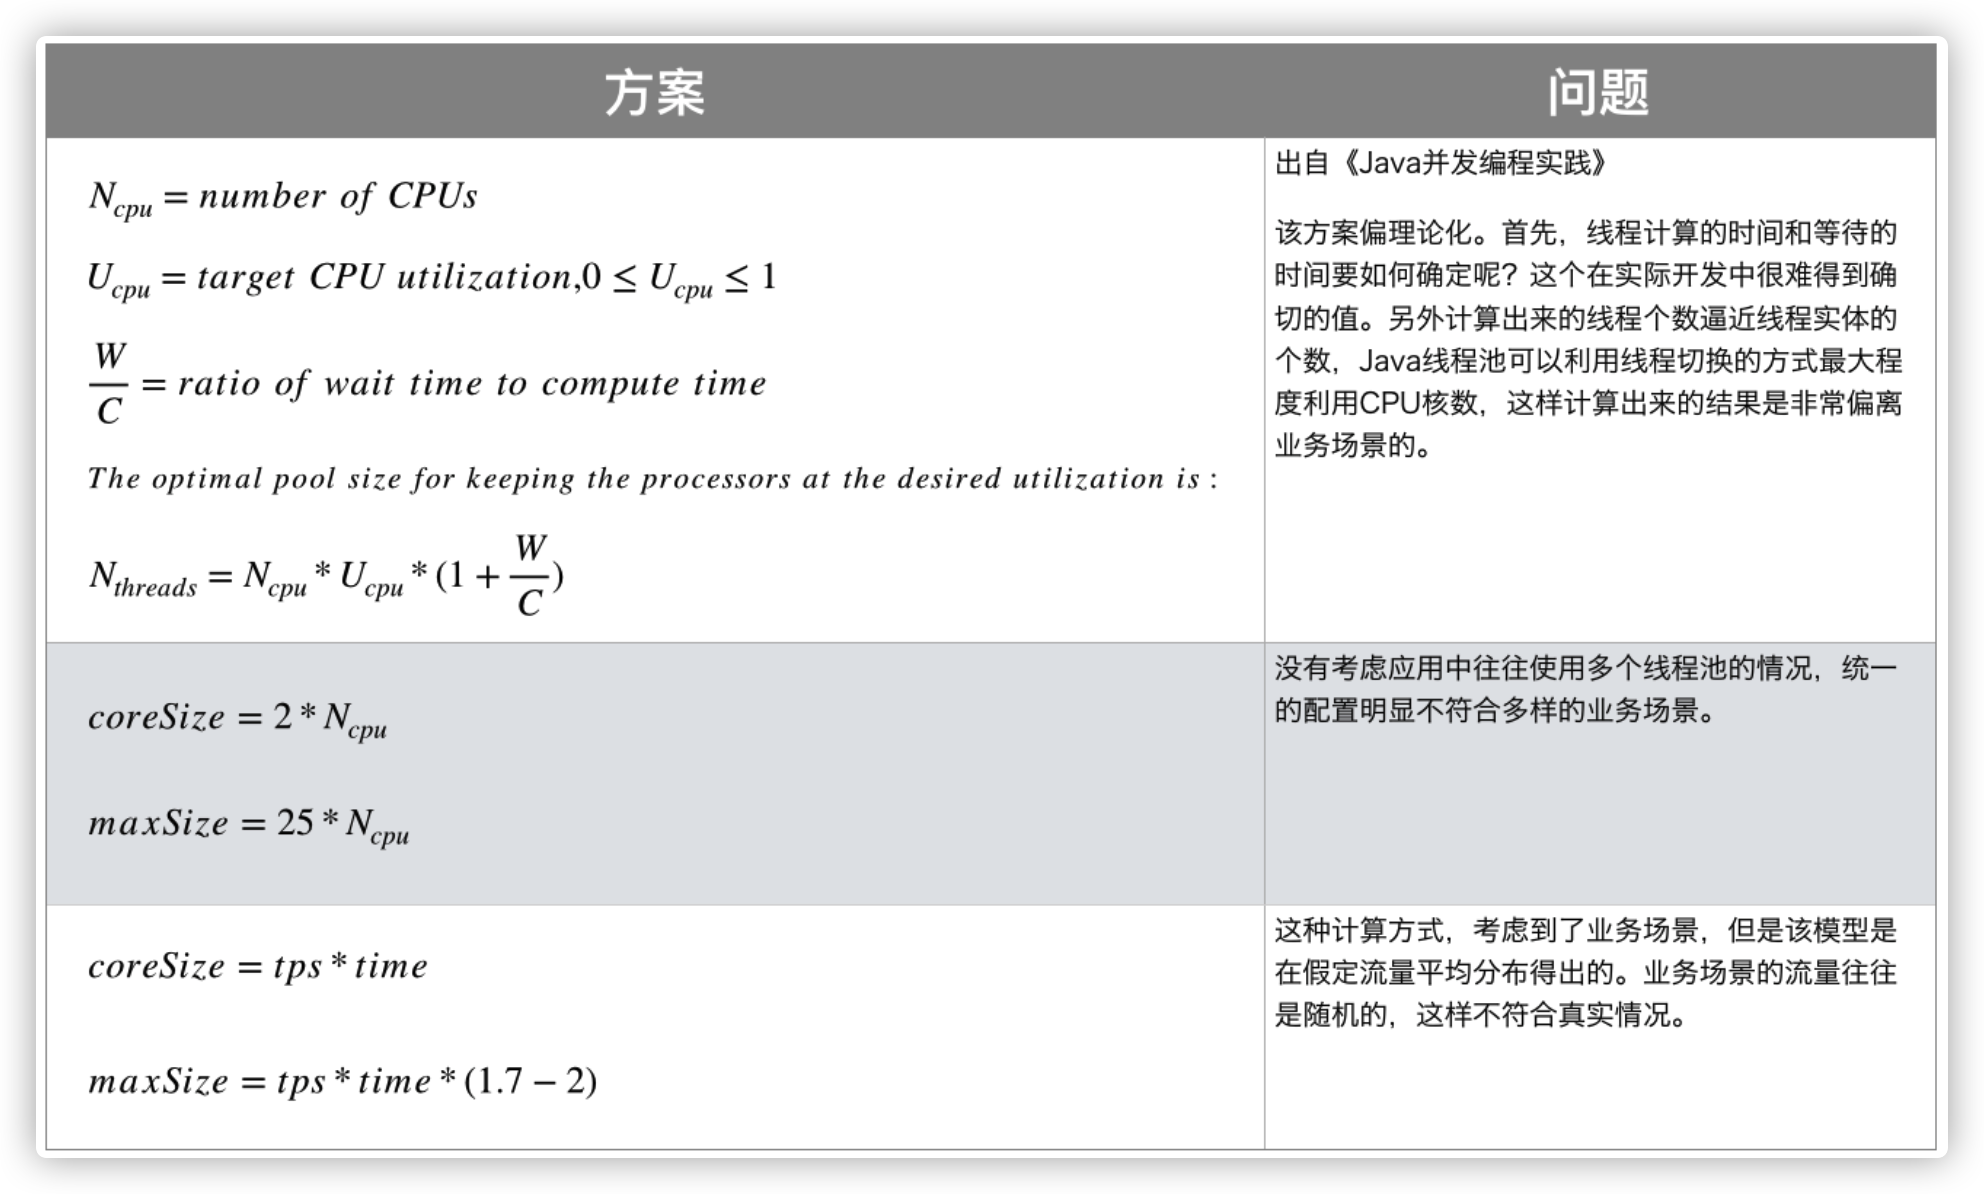
有没有一种计算公式,能够让开发同学很简易地计算出某种场景中的线程池应该是什么参数呢?

带着这样的疑问,我们调研了业界的一些线程池参数配置方案:

img

调研了以上业界方案后,我们并没有得出通用的线程池计算方式。并发任务的执行情况和任务类型相关,IO密集型和CPU密集型的任务运行起来的情况差异非常大,但这种占比是较难合理预估的,这导致很难有一个简单有效的通用公式帮我们直接计算出结果。

3. 线程池参数动态化?

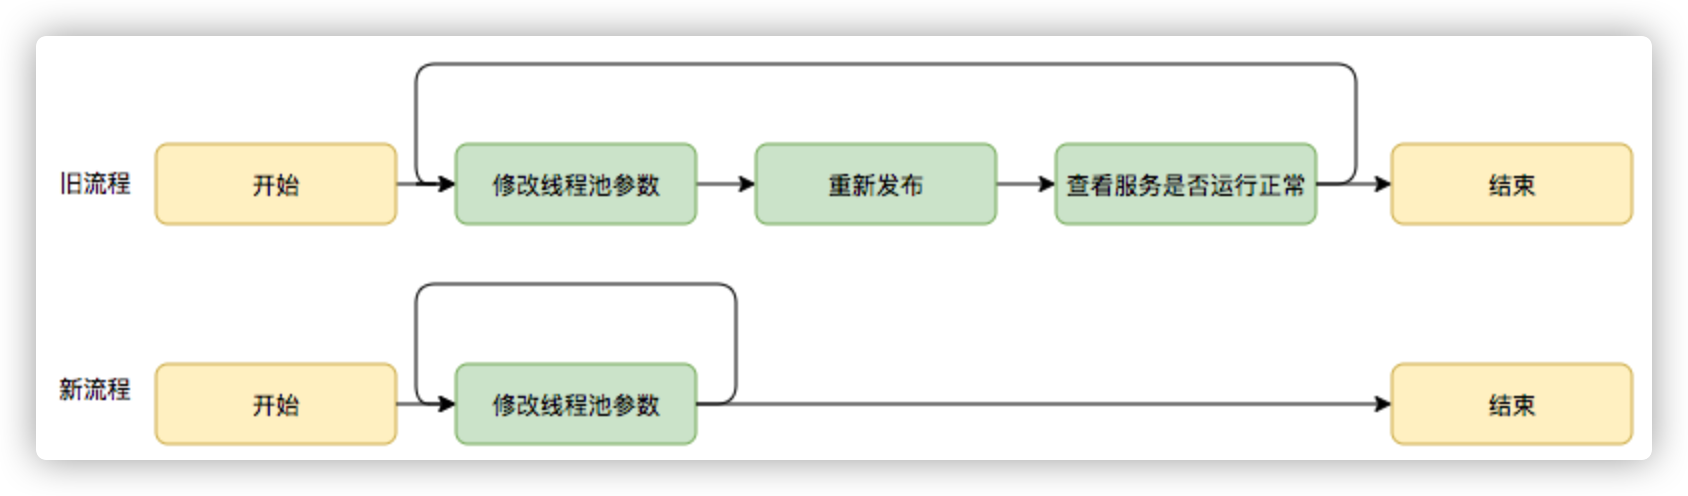
尽管经过谨慎的评估,仍然不能够保证一次计算出来合适的参数,那么我们是否可以将修改线程池参数的成本降下来,这样至少可以发生故障的时候可以快速调整从而缩短故障恢复的时间呢?基于这个思考,我们是否可以将线程池的参数从代码中迁移到分布式配置中心上,实现线程池参数可动态配置和即时生效,线程池参数动态化前后的参数修改流程对比如下:

图16 动态修改线程池参数新旧流程对比

图16 动态修改线程池参数新旧流程对比

基于以上三个方向对比,我们可以看出参数动态化方向简单有效。

3.3 动态化线程池

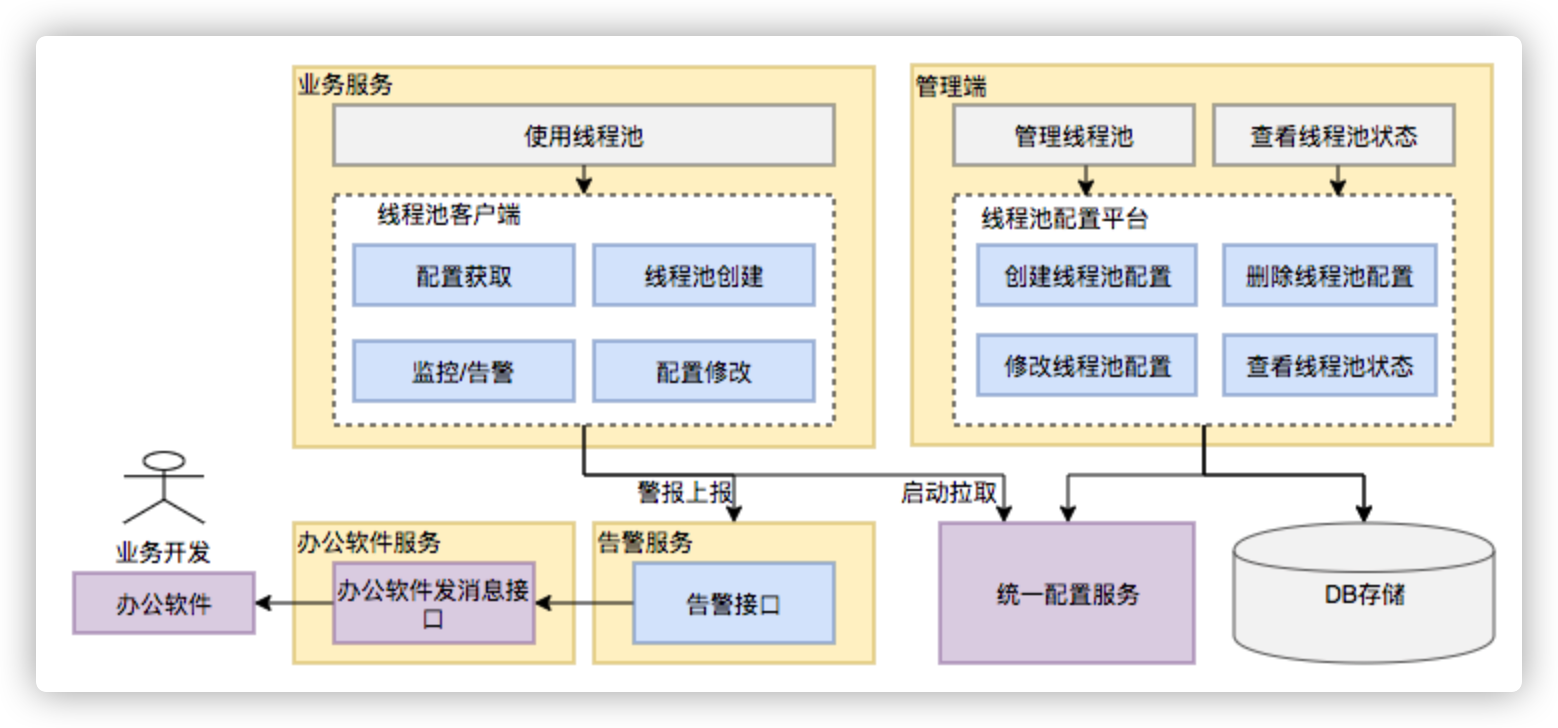
3.3.1 整体设计

动态化线程池的核心设计包括以下三个方面:

  1. 简化线程池配置:线程池构造参数有8个,但是最核心的是3个:corePoolSize、maximumPoolSize,workQueue,它们最大程度地决定了线程池的任务分配和线程分配策略。考虑到在实际应用中我们获取并发性的场景主要是两种:(1)并行执行子任务,提高响应速度。这种情况下,应该使用同步队列,没有什么任务应该被缓存下来,而是应该立即执行。(2)并行执行大批次任务,提升吞吐量。这种情况下,应该使用有界队列,使用队列去缓冲大批量的任务,队列容量必须声明,防止任务无限制堆积。所以线程池只需要提供这三个关键参数的配置,并且提供两种队列的选择,就可以满足绝大多数的业务需求,Less is More。
  2. 参数可动态修改:为了解决参数不好配,修改参数成本高等问题。在Java线程池留有高扩展性的基础上,封装线程池,允许线程池监听同步外部的消息,根据消息进行修改配置。将线程池的配置放置在平台侧,允许开发同学简单的查看、修改线程池配置。
  3. 增加线程池监控:对某事物缺乏状态的观测,就对其改进无从下手。在线程池执行任务的生命周期添加监控能力,帮助开发同学了解线程池状态。

图17 动态化线程池整体设计

图17 动态化线程池整体设计

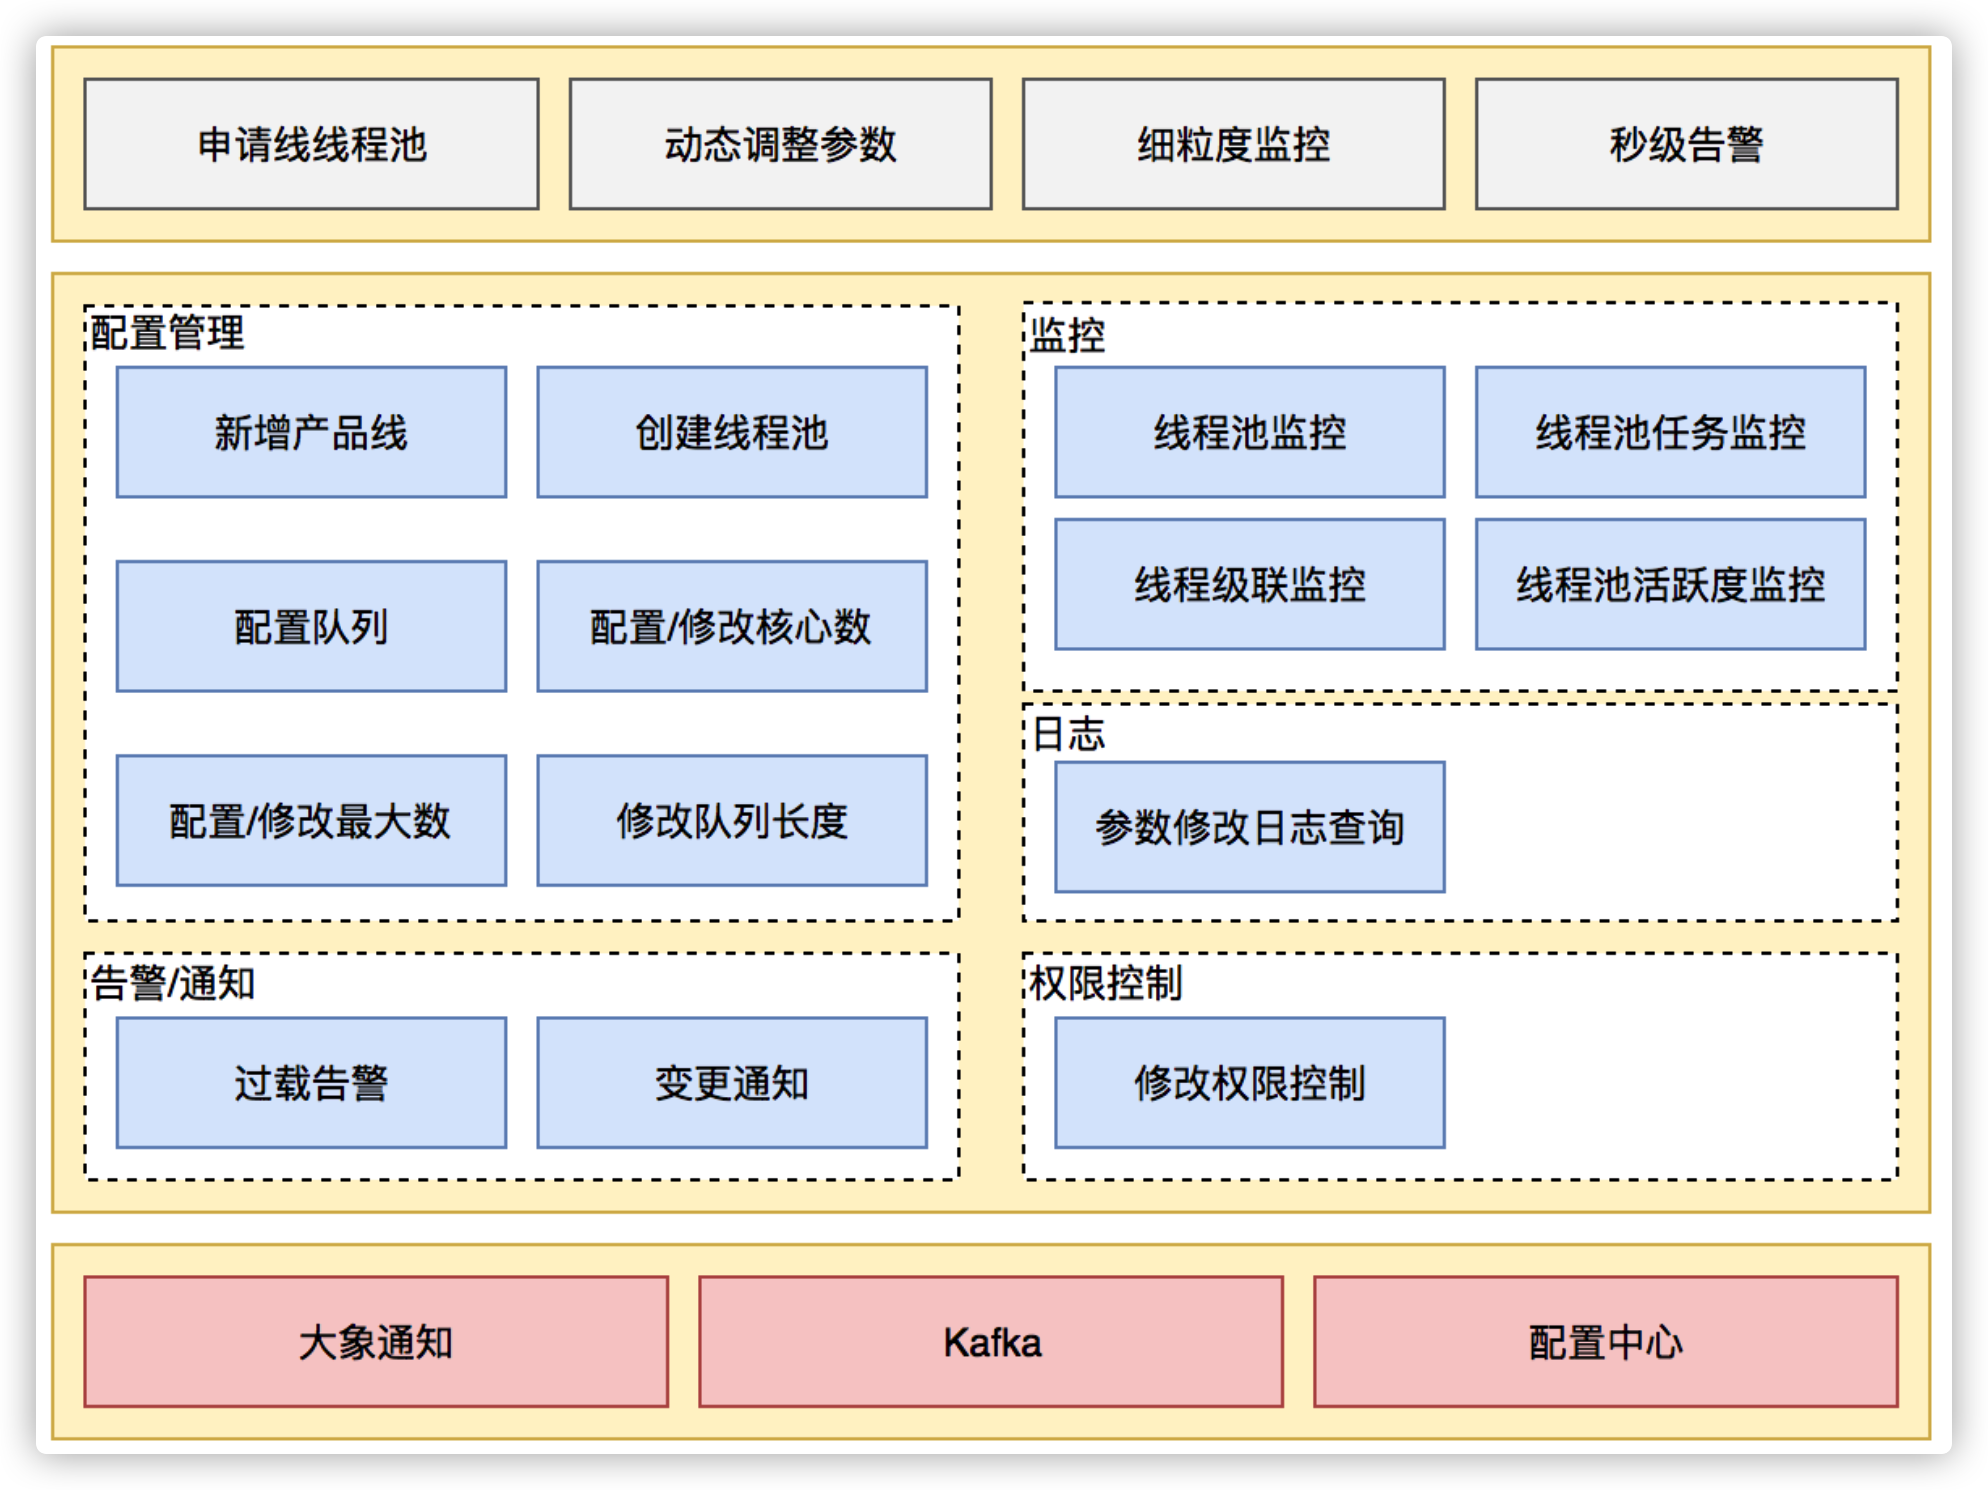
3.3.2 功能架构

动态化线程池提供如下功能:

动态调参:支持线程池参数动态调整、界面化操作;包括修改线程池核心大小、最大核心大小、队列长度等;参数修改后及时生效。 任务监控:支持应用粒度、线程池粒度、任务粒度的Transaction监控;可以看到线程池的任务执行情况、最大任务执行时间、平均任务执行时间、95/99线等。 负载告警:线程池队列任务积压到一定值的时候会通过大象(美团内部通讯工具)告知应用开发负责人;当线程池负载数达到一定阈值的时候会通过大象告知应用开发负责人。 操作监控:创建/修改和删除线程池都会通知到应用的开发负责人。 操作日志:可以查看线程池参数的修改记录,谁在什么时候修改了线程池参数、修改前的参数值是什么。 权限校验:只有应用开发负责人才能够修改应用的线程池参数。

图18 动态化线程池功能架构

图18 动态化线程池功能架构

参数动态化

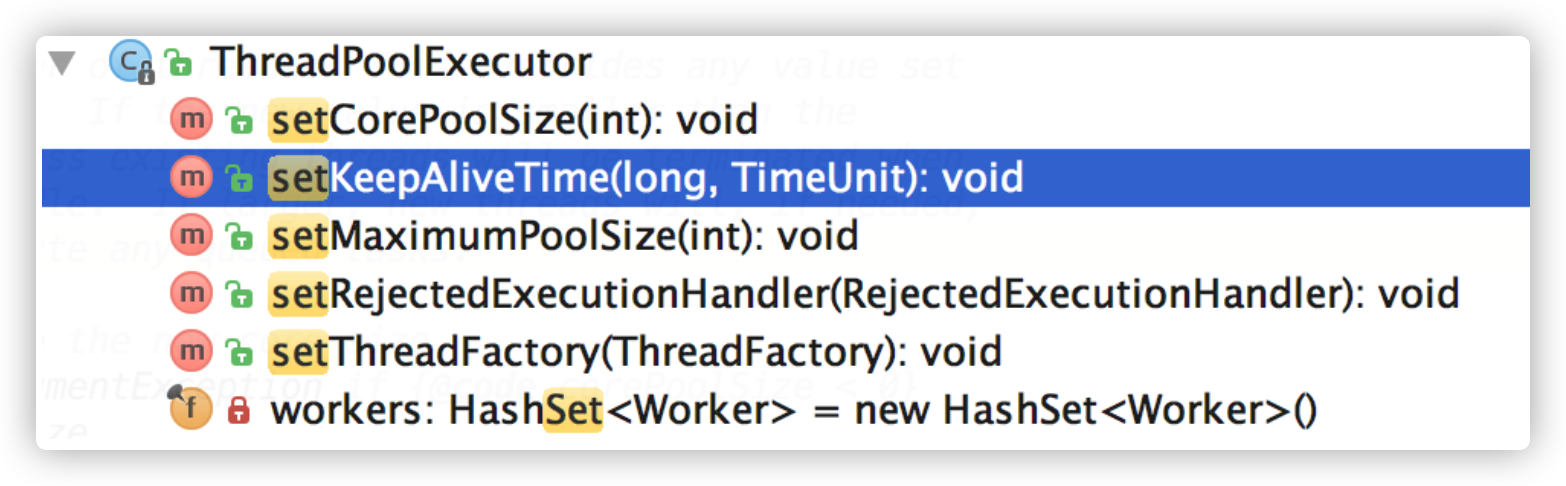
JDK原生线程池ThreadPoolExecutor提供了如下几个public的setter方法,如下图所示:

图19 JDK 线程池参数设置接口

图19 JDK 线程池参数设置接口

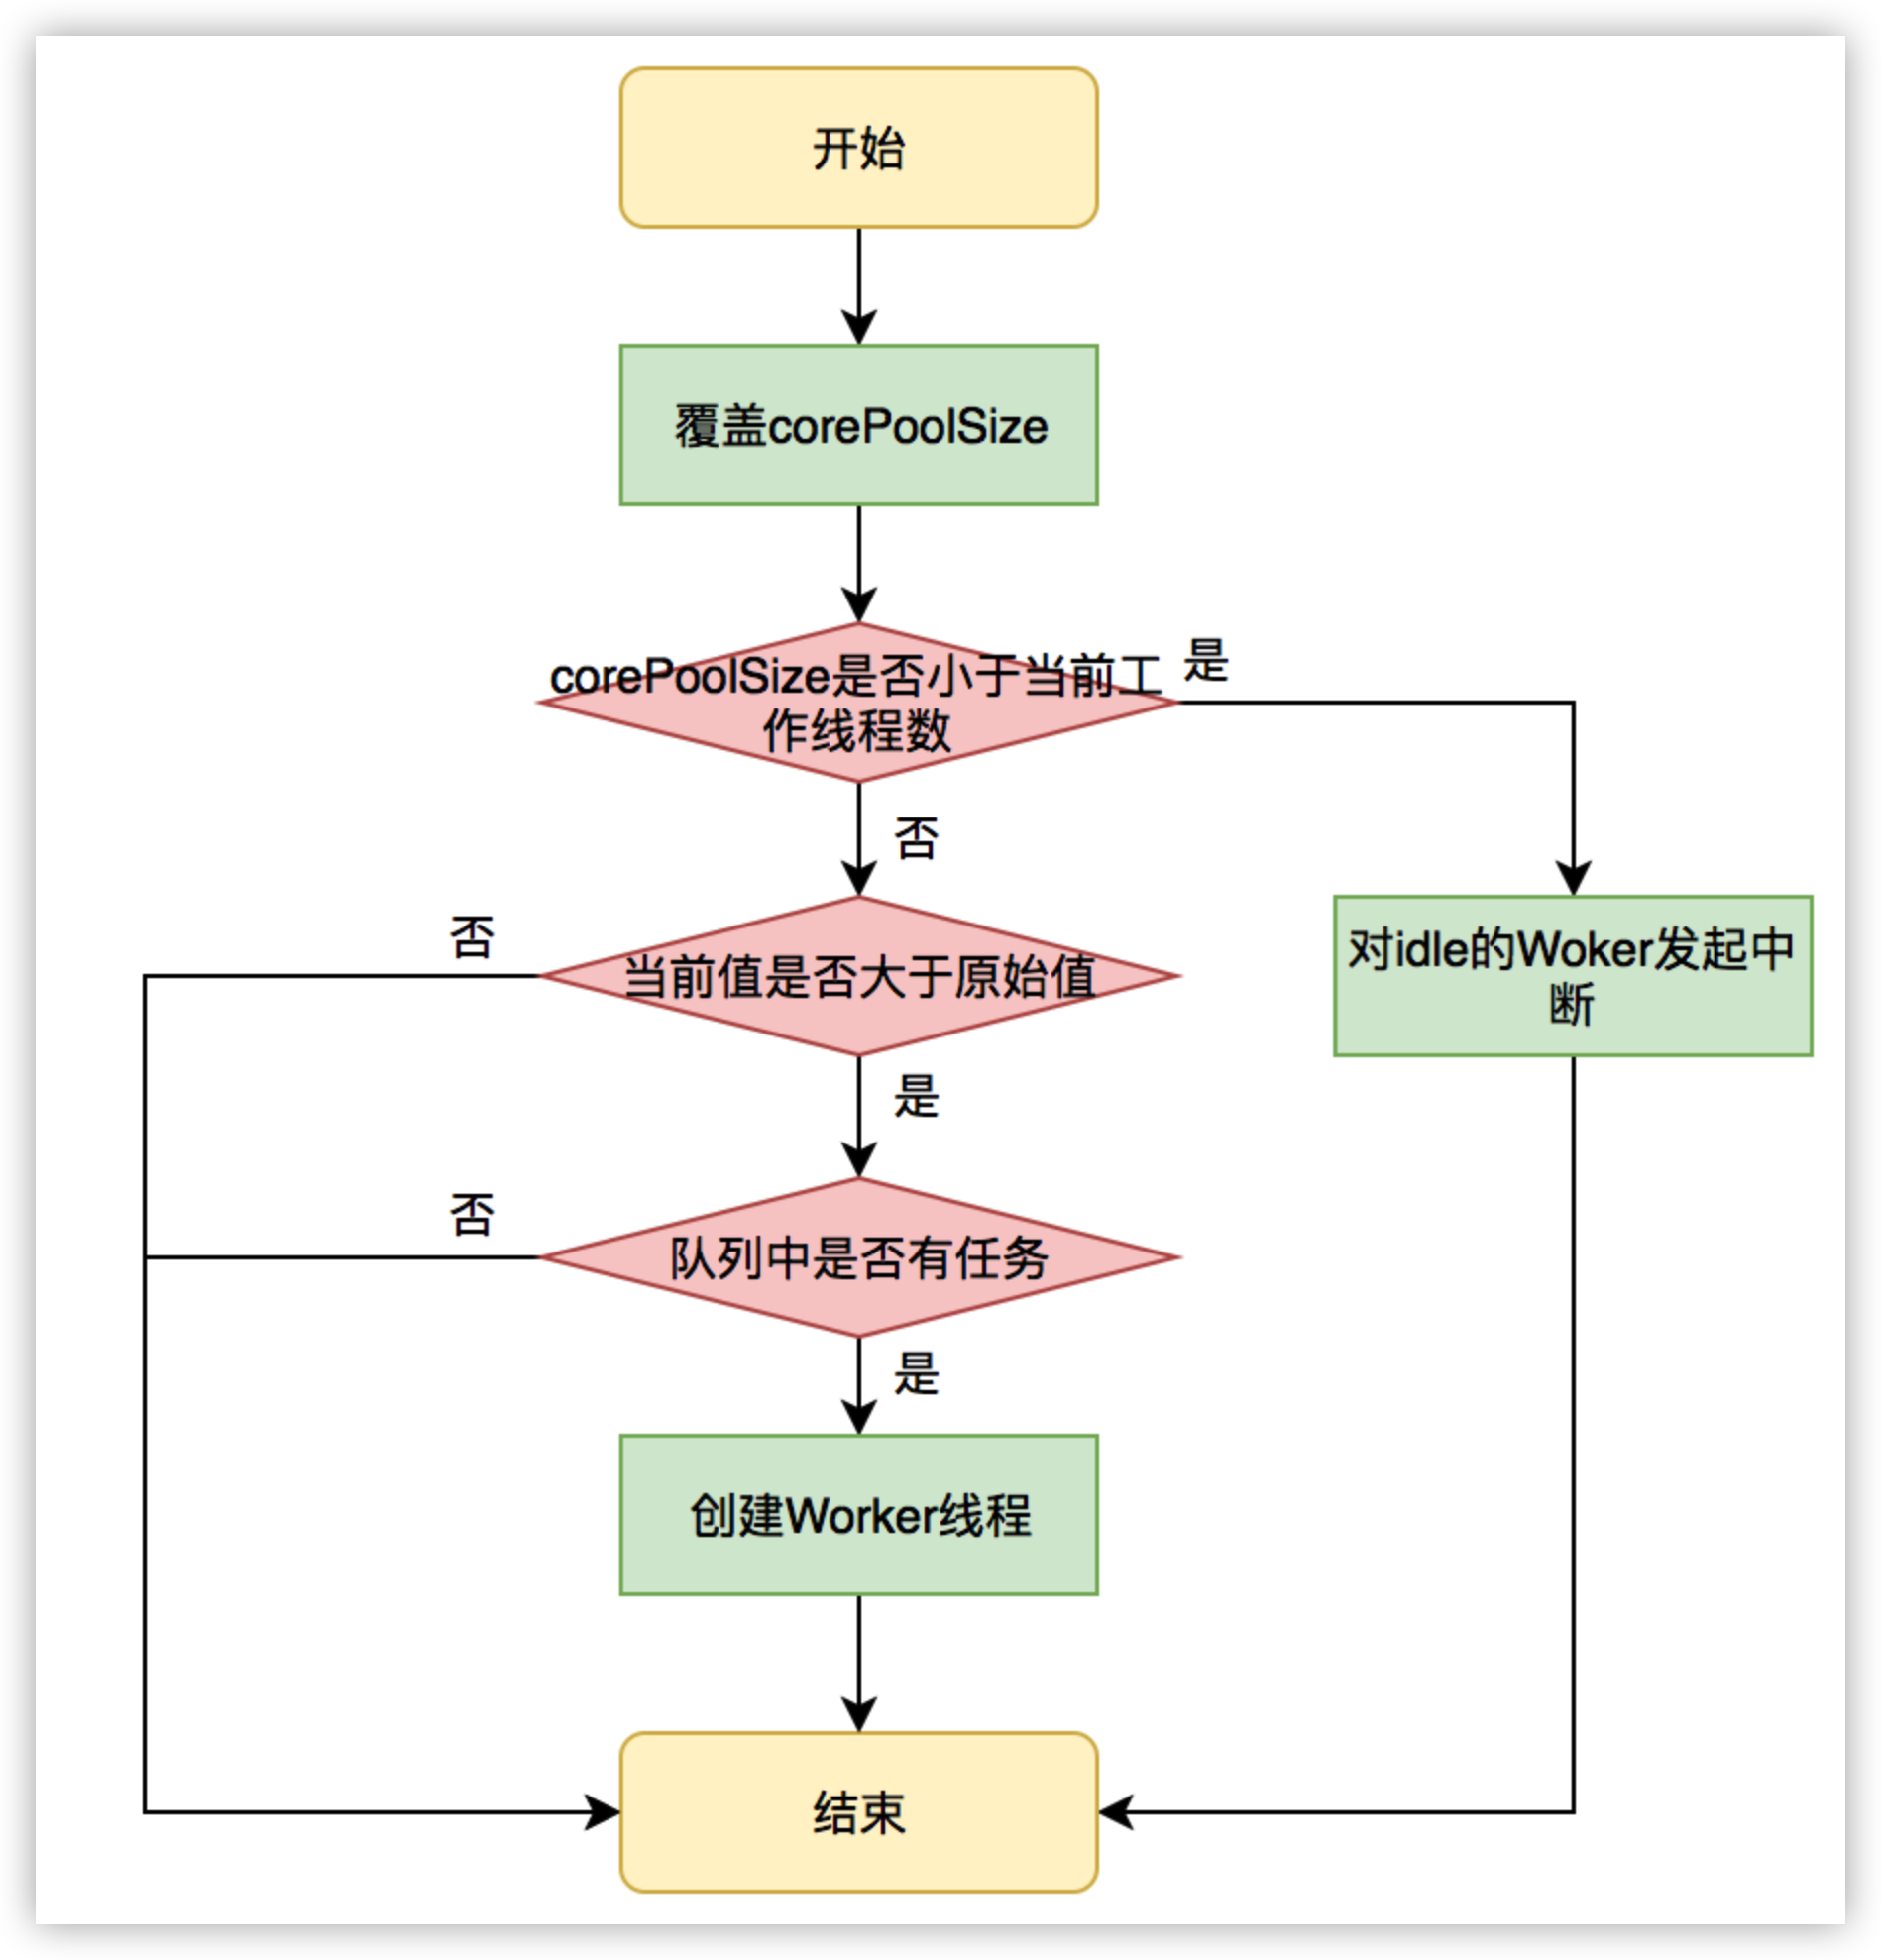
JDK允许线程池使用方通过ThreadPoolExecutor的实例来动态设置线程池的核心策略,以setCorePoolSize为方法例,在运行期线程池使用方调用此方法设置corePoolSize之后,线程池会直接覆盖原来的corePoolSize值,并且基于当前值和原始值的比较结果采取不同的处理策略。对于当前值小于当前工作线程数的情况,说明有多余的worker线程,此时会向当前idle的worker线程发起中断请求以实现回收,多余的worker在下次idel的时候也会被回收;对于当前值大于原始值且当前队列中有待执行任务,则线程池会创建新的worker线程来执行队列任务,setCorePoolSize具体流程如下:

图20 setCorePoolSize方法执行流程

图20 setCorePoolSize方法执行流程

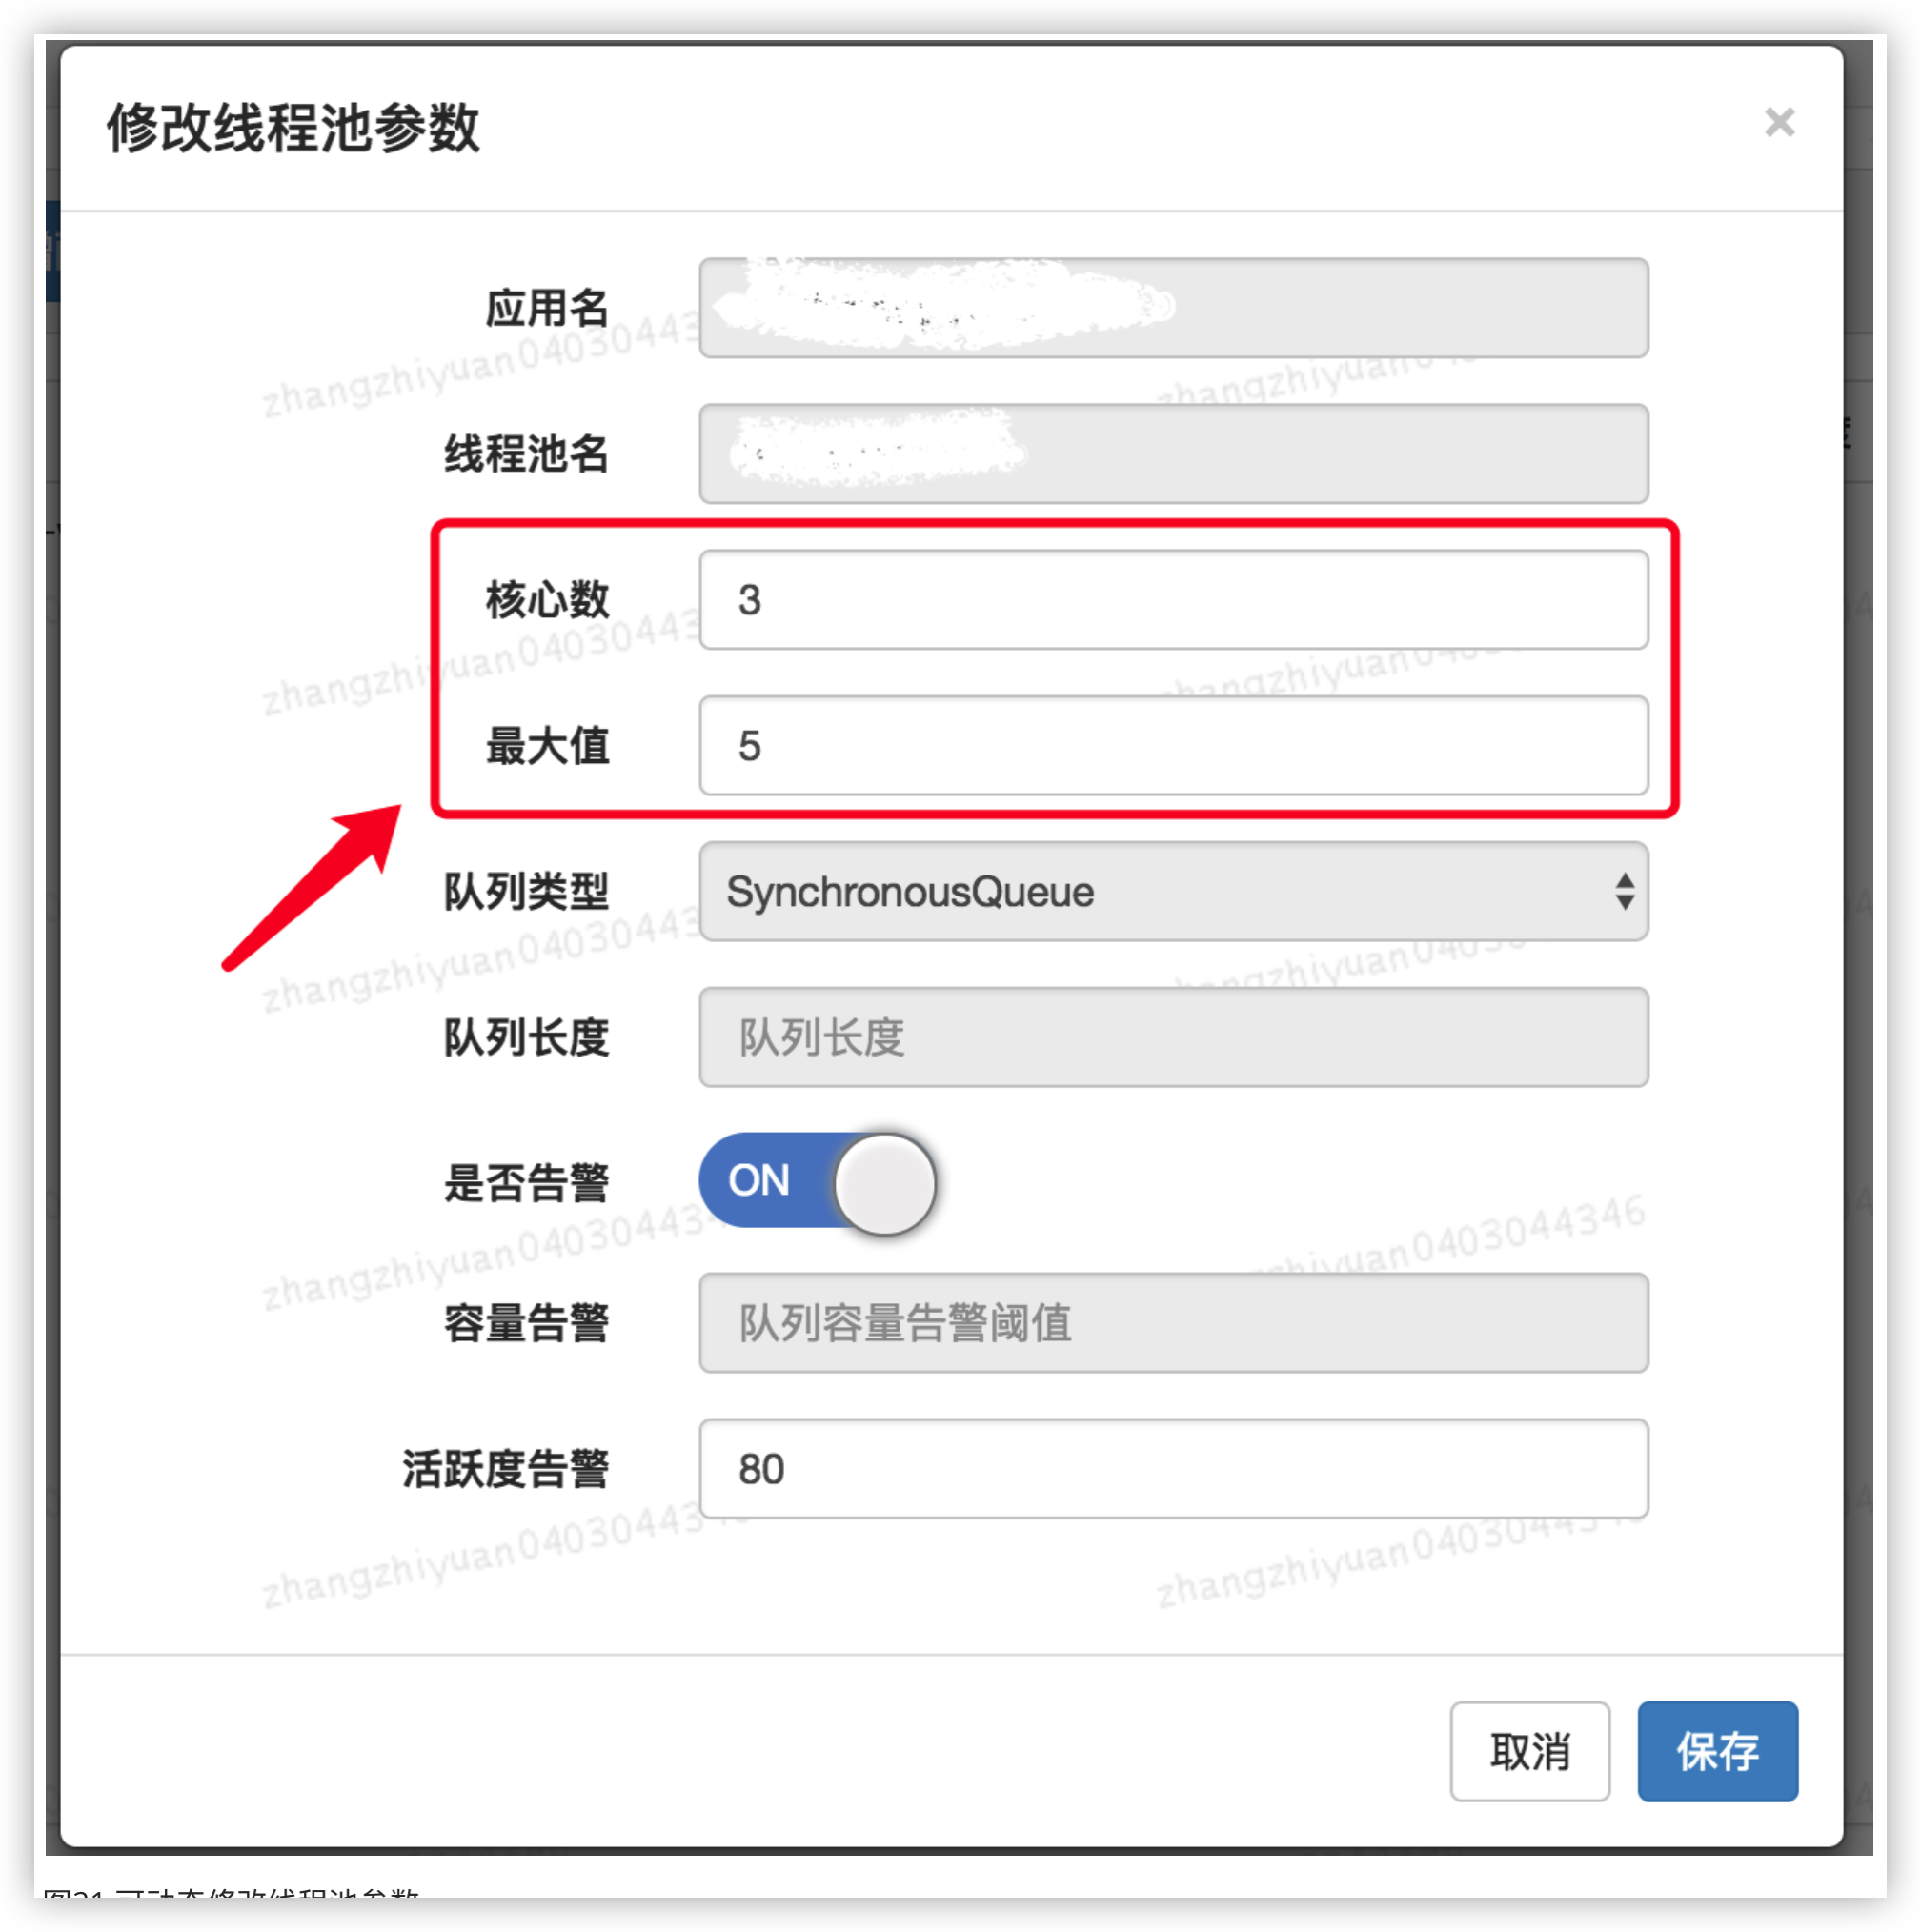
线程池内部会处理好当前状态做到平滑修改,其他几个方法限于篇幅,这里不一一介绍。重点是基于这几个public方法,我们只需要维护ThreadPoolExecutor的实例,并且在需要修改的时候拿到实例修改其参数即可。基于以上的思路,我们实现了线程池参数的动态化、线程池参数在管理平台可配置可修改,其效果图如下图所示:

图21 可动态修改线程池参数

图21 可动态修改线程池参数

用户可以在管理平台上通过线程池的名字找到指定的线程池,然后对其参数进行修改,保存后会实时生效。目前支持的动态参数包括核心数、最大值、队列长度等。除此之外,在界面中,我们还能看到用户可以配置是否开启告警、队列等待任务告警阈值、活跃度告警等等。关于监控和告警,我们下面一节会对齐进行介绍。

线程池监控

除了参数动态化之外,为了更好地使用线程池,我们需要对线程池的运行状况有感知,比如当前线程池的负载是怎么样的?分配的资源够不够用?任务的执行情况是怎么样的?是长任务还是短任务?基于对这些问题的思考,动态化线程池提供了多个维度的监控和告警能力,包括:线程池活跃度、任务的执行Transaction(频率、耗时)、Reject异常、线程池内部统计信息等等,既能帮助用户从多个维度分析线程池的使用情况,又能在出现问题第一时间通知到用户,从而避免故障或加速故障恢复。

1. 负载监控和告警

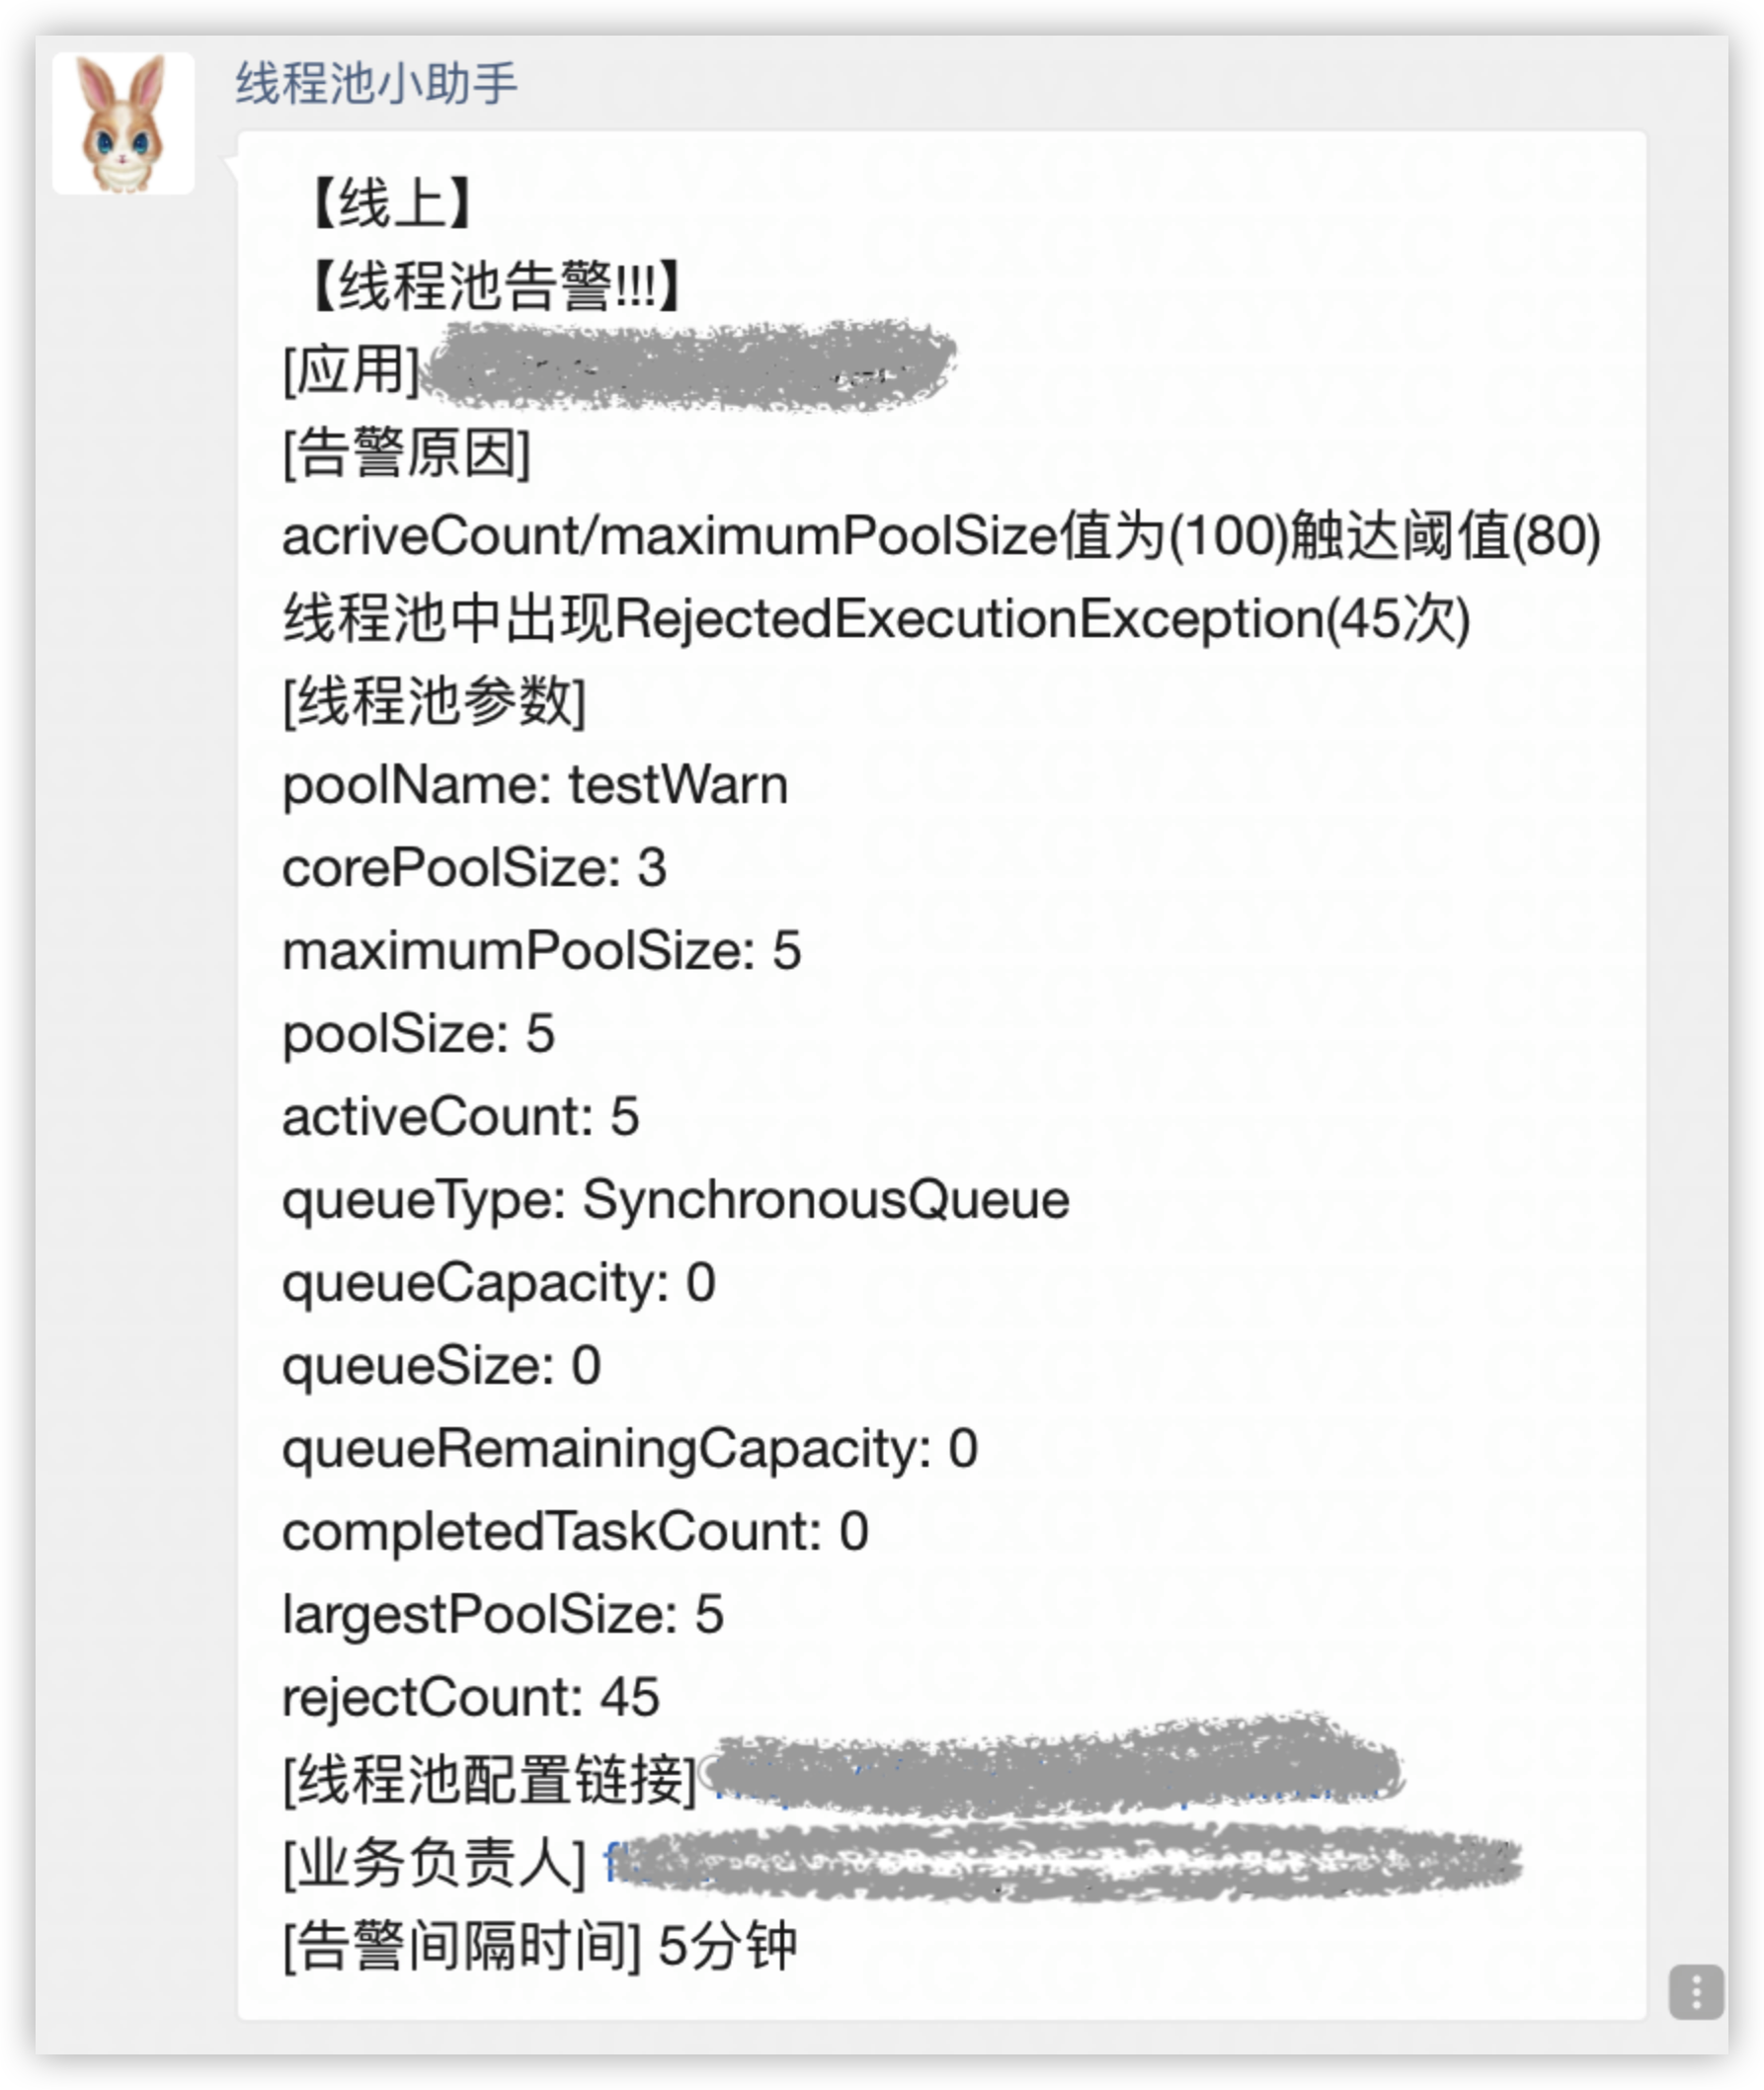
线程池负载关注的核心问题是:基于当前线程池参数分配的资源够不够。对于这个问题,我们可以从事前和事中两个角度来看。事前,线程池定义了“活跃度”这个概念,来让用户在发生Reject异常之前能够感知线程池负载问题,线程池活跃度计算公式为:线程池活跃度 = activeCount/maximumPoolSize。这个公式代表当活跃线程数趋向于maximumPoolSize的时候,代表线程负载趋高。事中,也可以从两方面来看线程池的过载判定条件,一个是发生了Reject异常,一个是队列中有等待任务(支持定制阈值)。以上两种情况发生了都会触发告警,告警信息会通过大象推送给服务所关联的负责人。

图22 大象告警通知

图22 大象告警通知

2. 任务级精细化监控

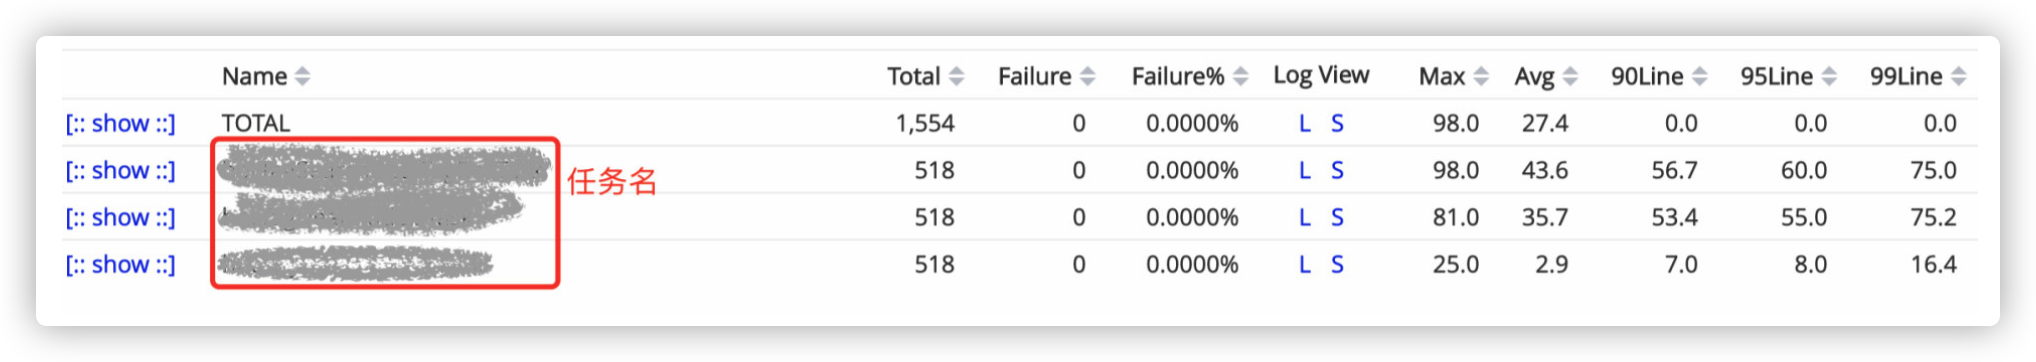
在传统的线程池应用场景中,线程池中的任务执行情况对于用户来说是透明的。比如在一个具体的业务场景中,业务开发申请了一个线程池同时用于执行两种任务,一个是发消息任务、一个是发短信任务,这两类任务实际执行的频率和时长对于用户来说没有一个直观的感受,很可能这两类任务不适合共享一个线程池,但是由于用户无法感知,因此也无从优化。动态化线程池内部实现了任务级别的埋点,且允许为不同的业务任务指定具有业务含义的名称,线程池内部基于这个名称做Transaction打点,基于这个功能,用户可以看到线程池内部任务级别的执行情况,且区分业务,任务监控示意图如下图所示:

图23 线程池任务执行监控

图23 线程池任务执行监控

3. 运行时状态实时查看

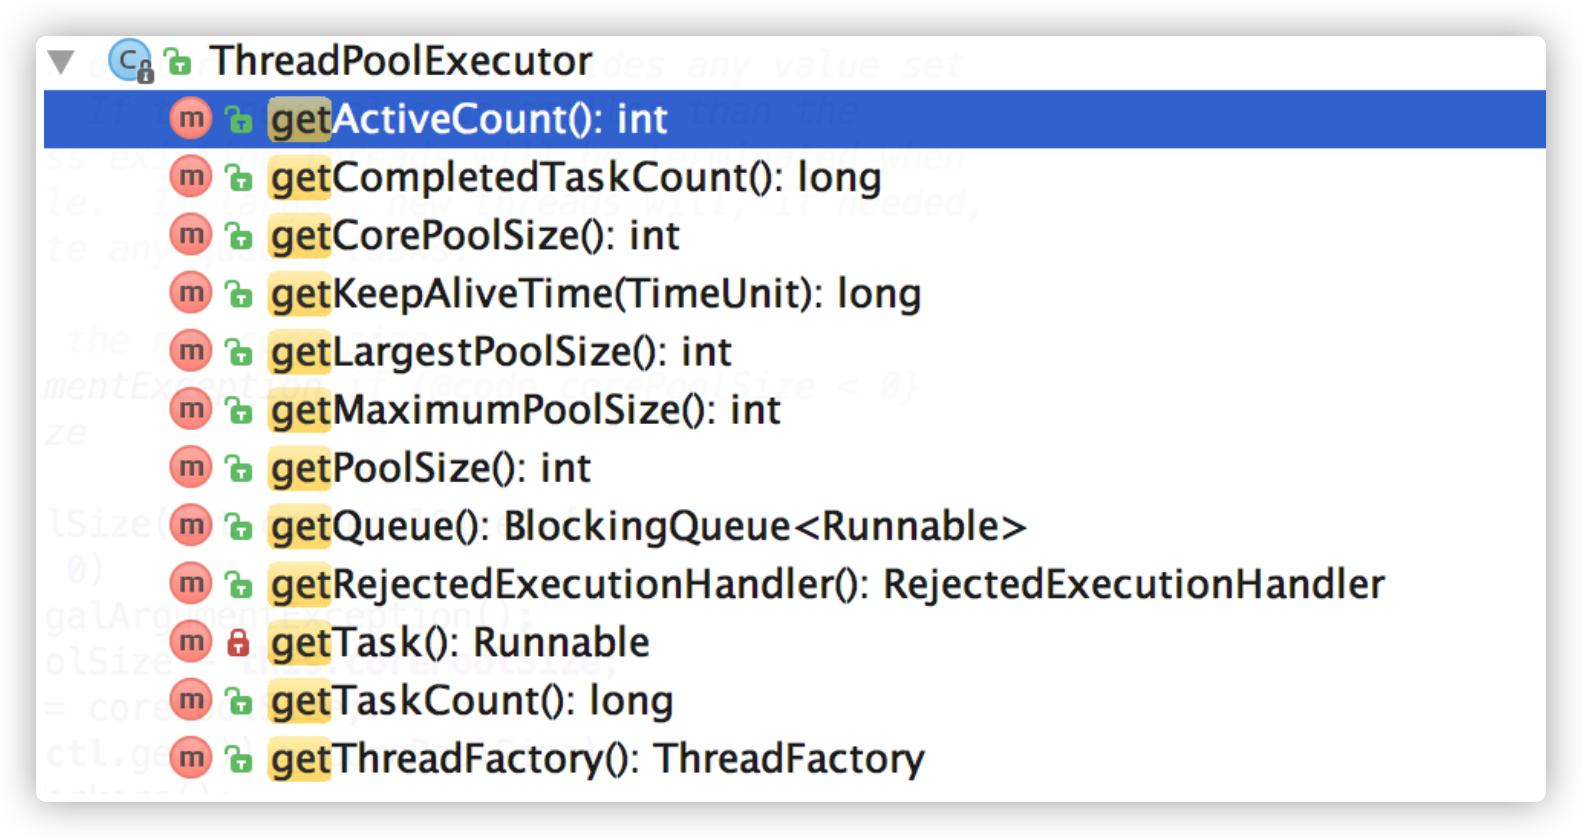
用户基于JDK原生线程池ThreadPoolExecutor提供的几个public的getter方法,可以读取到当前线程池的运行状态以及参数,如下图所示:

图24 线程池实时运行情况

图24 线程池实时运行情况

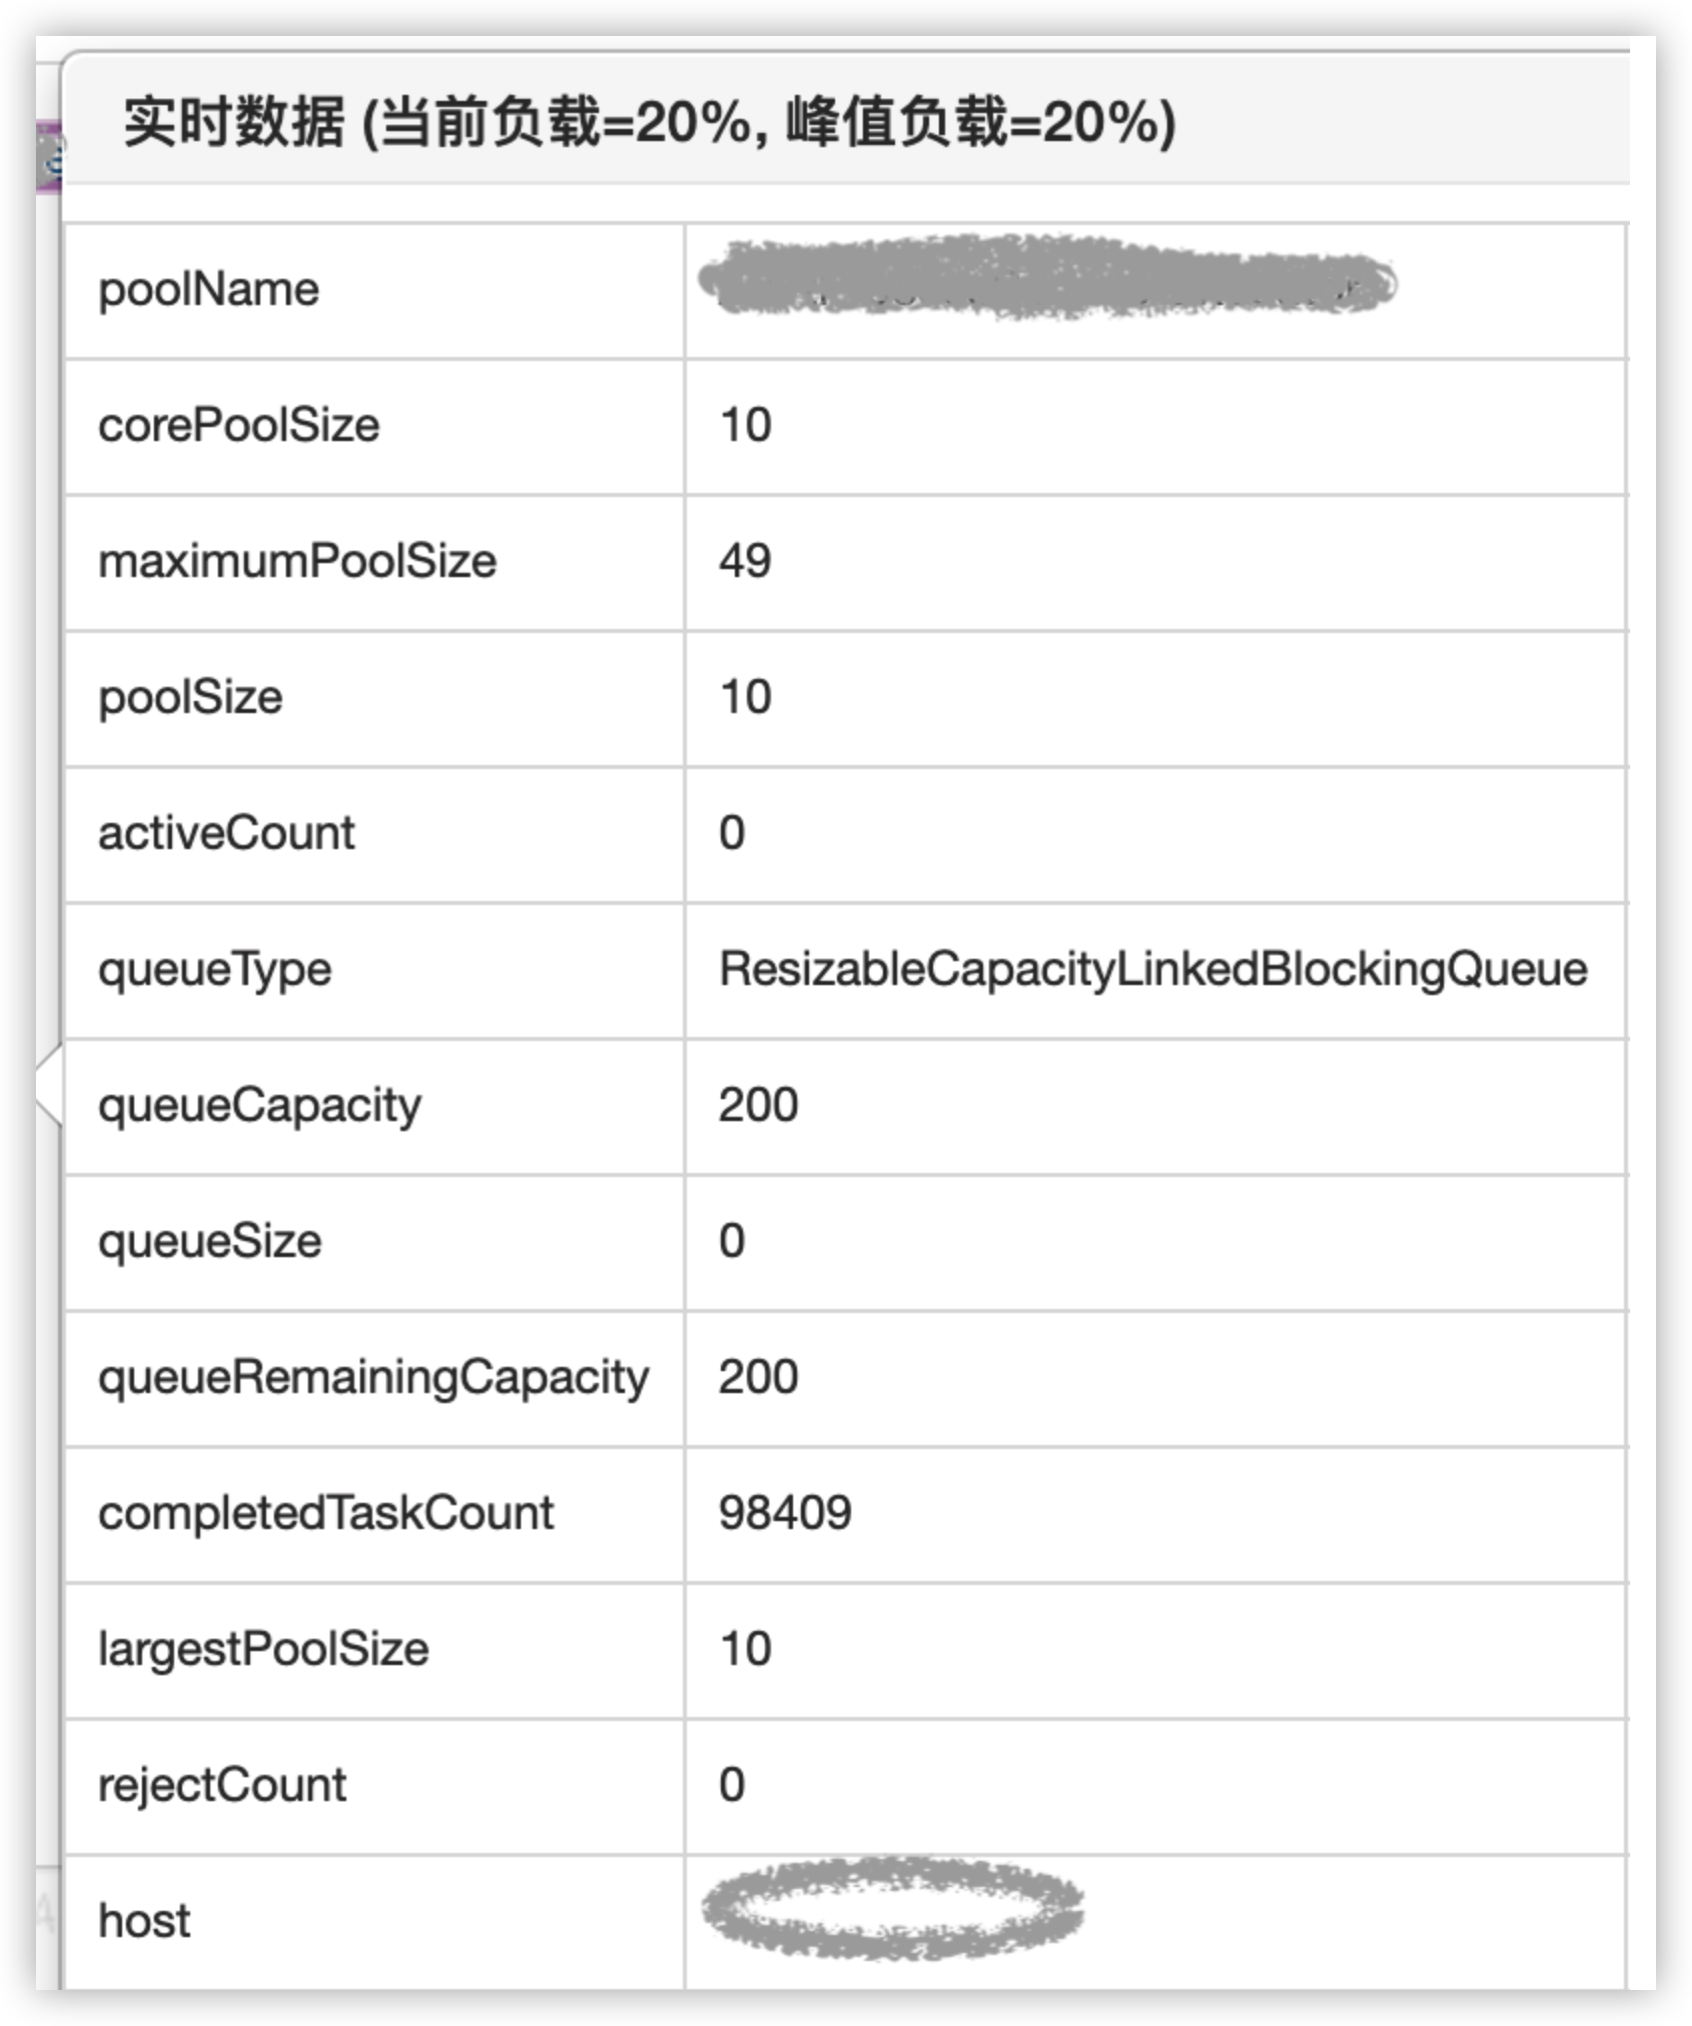
动态化线程池基于这几个接口封装了运行时状态实时查看的功能,用户基于这个功能可以了解线程池的实时状态,比如当前有多少个工作线程,执行了多少个任务,队列中等待的任务数等等。效果如下图所示:

图25 线程池实时运行情况

图25 线程池实时运行情况

3.4 实践总结

面对业务中使用线程池遇到的实际问题,我们曾回到支持并发性问题本身来思考有没有取代线程池的方案,也曾尝试着去追求线程池参数设置的合理性,但面对业界方案具体落地的复杂性、可维护性以及真实运行环境的不确定性,我们在前两个方向上可谓“举步维艰”。最终,我们回到线程池参数动态化方向上探索,得出一个且可以解决业务问题的方案,虽然本质上还是没有逃离使用线程池的范畴,但是在成本和收益之间,算是取得了一个很好的平衡。成本在于实现动态化以及监控成本不高,收益在于:在不颠覆原有线程池使用方式的基础之上,从降低线程池参数修改的成本以及多维度监控这两个方面降低了故障发生的概率。希望本文提供的动态化线程池思路能对大家有帮助。

四、参考资料

l

java学习路线图

项目地址:

这篇回答不会涉及到学习方法以及学习网站的推荐,我不想让篇幅太长,内容太杂,我希望留着下一篇文章专门来谈一谈。

另外,这篇回答也不会涉及到计算机基础,也是为了保证内容的不至于太杂。计算基础相关的内容我也已经写好,预计会在五一同步给小伙伴们。
imgimg

多说一句,对于编程初学者,我不太建议上来通过做项目学习。实践确实很重要,如果你没有编程基础的话,直接上手实战,很容易最后学个四不像。

建议你在学习编程的初期尽量多看一些优质视频。跟着视频一步一步走,可以让你少踩很多坑,学习编程的信心也会增加。

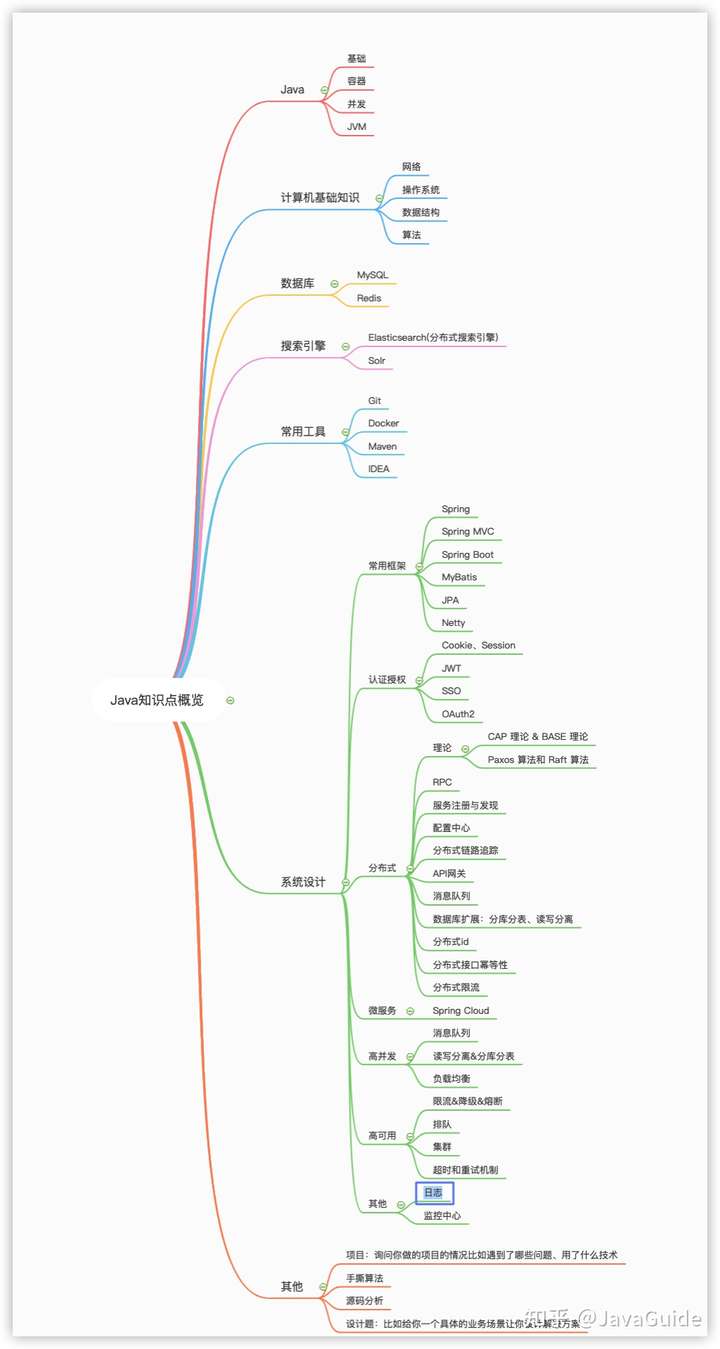
概览:
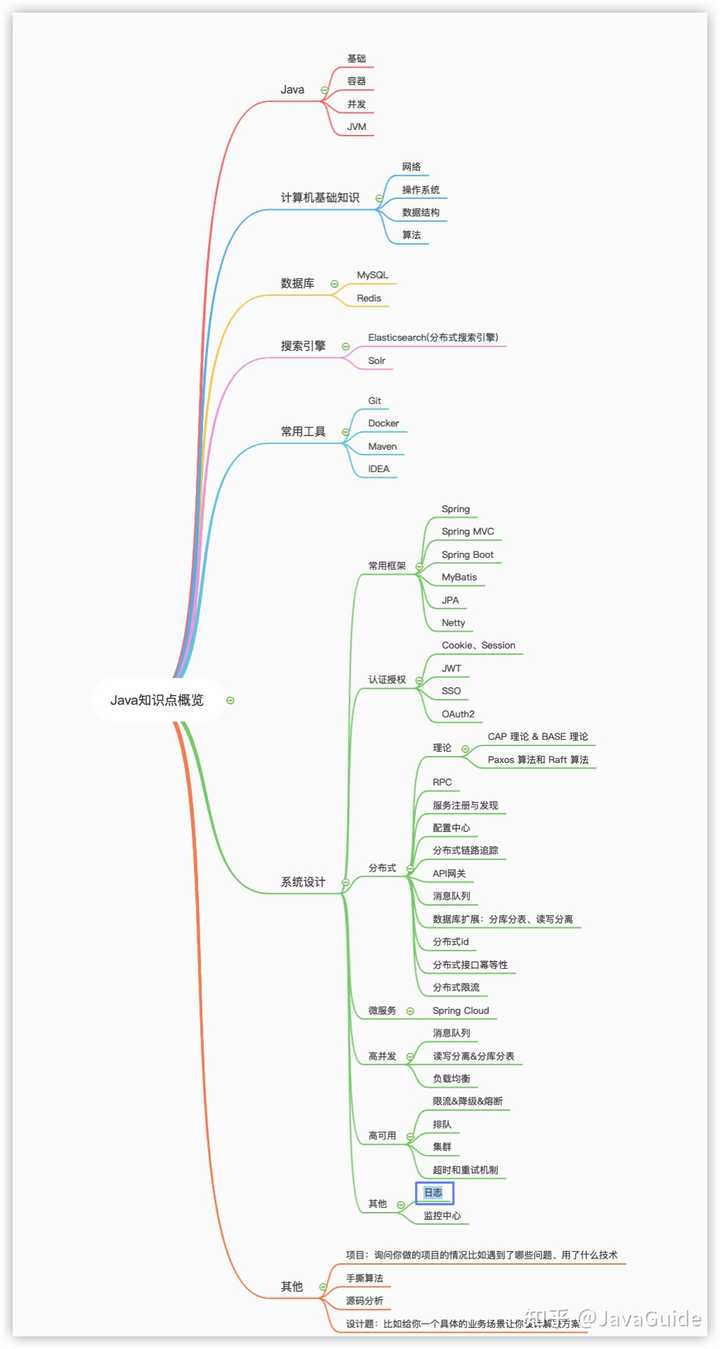
imgimg

回答中的相关书籍我也已经同步到了 Github和Gitee上(有PDF版本可供下载),欢迎小伙伴们一起完善。

Java 基础

如果你之前没有学习过编程的话,我建议你可以看看视频教程。

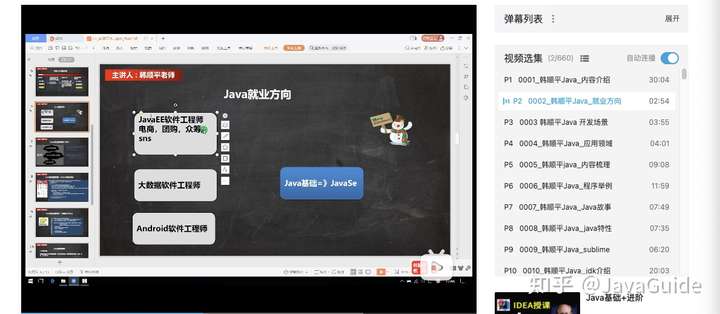
像尚硅谷的 《 Java 基础教程系列》和韩顺平老师的《零基础 30 天学会 Java》就很不错。
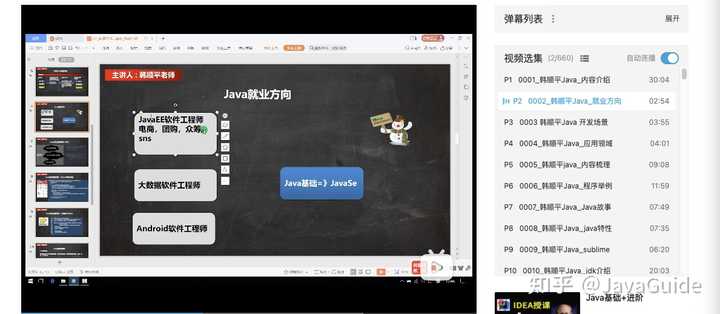
imgimg

学习过 Java 的朋友,大部分应该都看过韩老师的课程吧!韩老师毕业于清华大学,录制的视频课程质量都非常高。内容易懂,并且不失严谨。

韩老师的《零基础 30 天学会 Java》系列不光会教你 Java 基础,还会帮你建立编程思想,让你知道学习了 Java 之后,你可以从事什么工作。

看视频的同时,配套一本好书也是非常有作用的。

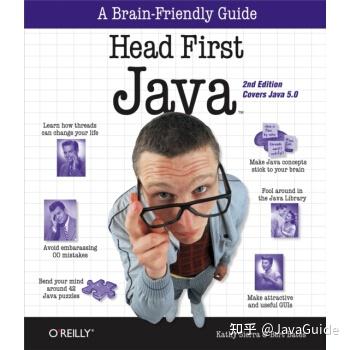
《Head First Java》 这本书在是入门 Java 的很不错的书籍 。
imgimg

《Head First Java》这本书的内容很轻松有趣,可以说是我学习编程初期最喜欢的几本书之一了。同时,这本书也是我的 Java 启蒙书籍。我在学习 Java 的初期多亏了这本书的帮助,自己才算是跨进 Java 语言的大门。

我觉得我在 Java 这块能够坚持下来,这本书有很大的功劳。我身边的的很多朋友学习 Java 初期都是看的这本书。

有很多小伙伴就会问了:这本书适不适合编程新手阅读呢?

我个人觉得这本书还是挺适合编程新手阅读的,毕竟是 “Head First” 系列。
imgimg

《Java 核心技术卷 1+卷 2》 这两本书也非常不错。不过,这两本书的内容很多,全看的话比较费时间。我现在是把这两本书当做工具书来用,就比如我平时写文章的时候,碰到一些 Java 基础方面的问题,经常就翻看这两本来当做参考!

我当时在大学的时候就买了两本放在寝室,没事的时候就翻翻。建议有点 Java 基础之后再读,介绍的还是比较深入和全面的,非常推荐。
imgimg

《Java 编程思想 》 这本书被很多人称之为 Java 领域的圣经(*感觉有点过了~~~*)。不太推荐编程初学者阅读,有点劝退的味道,稍微有点基础后阅读更好。

我第一次看的时候还觉得有点枯燥,那时候还在上大二,看了 1/3 就没看下去了。
imgimg

另外,Java 8 算是一个里程碑式的版本,现在一般企业还是用 Java 8 比较多。掌握 Java 8 的一些新特性比如 Lambda、Strean API 还是挺有必要的。这块的话,我推荐 《Java 8 实战》 这本书。

学完 Java 基础之后,你可以用自己学的东西实现一个简单的 Java 程序,也可以尝试用 Java 解决一些编程问题,以此来将自己学到的东西付诸于实践。

不太建议学习 Java 基础的之后通过做游戏来巩固。为什么培训班喜欢通过这种方式呢?说白点就是为了找到你的 G 点。新手学习完 Java 基础后做游戏一般是不太现实的,还不如找一些简单的程序问题解决一下比如简单的算法题。

记得多总结!打好基础!把自己重要的东西都记录下来。 API 文档放在自己可以看到的地方,以备自己可以随时查阅。为了能让自己写出更优秀的代码,《Effective Java》、《重构》 这两本书没事也可以看

并发

多线程这部分内容稍微会比较难以理解和实践。如果你刚学完 Java 基础的话,我建议你学习并发这部分内容的时候,可以先简单地了解一下基础知识比如线程和进程的对比。到了后面,你对于 Java 了解的更深了之后,再回来仔细看看这部分的内容。

下面是一些我比较推荐的书籍。

《Java 并发编程之美》
imgimg

这本书还是非常适合我们用来学习 Java 多线程的。这本书的讲解非常通俗易懂,作者从并发编程基础到实战都是信手拈来。

另外,这本书的作者加多自身也会经常在网上发布各种技术文章。这本书也是加多大佬这么多年在多线程领域的沉淀所得的结果吧!他书中的内容基本都是结合代码讲解,非常有说服力!

《实战 Java 高并发程序设计》
imgimg

这个是我第二本要推荐的书籍,比较适合作为多线程入门/进阶书籍来看。这本书内容同样是理论结合实战,对于每个知识点的讲解也比较通俗易懂,整体结构也比较清。

《深入浅出 Java 多线程》
imgimg

这本书是几位大厂的大佬开源的。

这几位作者为了写好《深入浅出 Java 多线程》这本书阅读了大量的 Java 多线程方面的书籍和博客,然后再加上他们的经验总结、Demo 实例、源码解析,最终才形成了这本书。

这本书的质量也是非常过硬!给作者们点个赞!这本书有统一的排版规则和语言风格、清晰的表达方式和逻辑。并且每篇文章初稿写完后,作者们就会互相审校,合并到主分支时所有成员会再次审校,最后再通篇修订了三遍。

《Java 并发实现原理:JDK 源码剖析》
imgimg

这本书是去年也就是 2020 年新出的,所以,现在知道的人还不是很多。

这本书主要是对 Java Concurrent 包中一些比较重要的源码进行了讲解,另外,像 JMM、happen-before、CAS 等等比较重要的并发知识这本书也都会一并介绍到。

不论是你想要深入研究 Java 并发,还是说要准备面试,你都可以看看这本书。

下面是我总结的一些关于并发的小问题,你可以拿来自测:

  1. 什么是线程和进程? 线程与进程的关系,区别及优缺点?
  2. 说说并发与并行的区别?
  3. 为什么要使用多线程呢?
  4. 使用多线程可能带来什么问题?(内存泄漏、死锁、线程不安全等等)
  5. 创建线程有哪几种方式?(a.继承 Thread 类;b.实现 Runnable 接口;c. 使用 Executor 框架;d.使用 FutureTask)
  6. 说说线程的生命周期和状态?
  7. 什么是上下文切换?
  8. 什么是线程死锁?如何避免死锁?
  9. 说说 sleep() 方法和 wait() 方法区别和共同点?
  10. Java 内存模型(JMM)、重排序与 happens-before 原则了解吗?
  11. synchronized 关键字、volatile 关键字
  12. ThreadLocal 有啥用(解决了什么问题)?怎么用?原理了解吗?内存泄露问题了解吗?
  13. 为什么要用线程池?ThreadPoolExecutor 类的重要参数了解吗?ThreadPoolExecutor 饱和策略了解吗?线程池原理了解吗?几种常见的线程池了解吗?为什么不推荐使用FixedThreadPool?如何设置线程池的大小?
  14. AQS 了解么?原理?AQS 常用组件:Semaphore (信号量)、CountDownLatch (倒计时器) CyclicBarrier(循环栅栏)
  15. ReentrantLock 、 ReentrantReadWriteLock 、StampedLock(JDK8)
  16. CAS 了解么?原理?
  17. Atomic 原子类
  18. 并发容器:ConcurrentHashMap 、 CopyOnWriteArrayList 、 ConcurrentLinkedQueue BlockingQueue 、ConcurrentSkipListMap
  19. Future 和 CompletableFuture
  20. ……

JVM

对于 Java 程序员来说,JVM 帮助我们做了很多事情比如内存管理、垃圾回收等等。在 JVM 的帮助下,我们的程序出现内存泄漏这些问题的概率相对来说是比较低的。但是,这并不代表我们在日常开发工作中不会遇到。万一你在工作中遇到了 OOM 问题,你至少要知道如何去排查和解决问题吧!

并且,就单纯从面试角度来说,JVM 是 Java 后端面试(大厂)中非常重要的一环。不论是应届还是社招,面试国内的一些大厂,你都会被问到很多 JVM 相关的问题(应届的话侧重理论,社招实践)。

只有搞懂了 JVM 才有可能真正把 Java 语言“吃透”。学习 JVM 这部分的内容,一定要注意要实战和理论结合。

书籍的话,**《深入理解 Java 虚拟机》** 这本书是首先要推荐的。
imgimg

这本书就一句话形容:国产书籍中的战斗机,实实在在的优秀! (真心希望国内能有更多这样的优质书籍出现!加油! )

这本书的第三版去年年底已经出来了,新增了很多实在的内容比如 ZGC 等新一代 GC 的原理剖析。目前豆瓣上是 9.6 的高分, 不 我就不多说了!

不论是你面试还是你想要在 Java 领域学习的更深,你都离不开这本书籍。这本书不光要看,你还要多看几遍,里面都是干货。这本书里面还有一些需要自己实践的东西,我建议你也跟着实践一下。

类似的书籍还有 《实战 Java 虚拟机》、《虚拟机设计与实现:以 JVM 为例》 ,这两本都是非常不错的!
imgimg

如果你对实战比较感兴趣,想要自己动手写一个简易的 JVM 的话,可以看看 《自己动手写 Java 虚拟机》 这本书。
imgimg

书中的代码是基于 Go 语言实现的,搞懂了原理之后,你可以使用 Java 语言模仿着写一个,也算是练练手! 如果你当前没有能力独立使用 Java 语言模仿着写一个的话,你也可以在网上找到很多基于 Java 语言版本的实现,比如《zachaxy 的手写 JVM 系列》 。

这本书目前在豆瓣有 8.2 的评分,我个人觉得张秀宏老师写的挺好的,这本书值得更高的评分。

另外,R 大在豆瓣发的《从表到里学习 JVM 实现》这篇文章中也推荐了很多不错的 JVM 相关的书籍,推荐小伙伴们去看看。

再推荐两个视频给喜欢看视频学习的小伙伴。

第 1 个是尚硅谷的宋红康老师讲的《JVM 全套教程》。这个课程的内容非常硬,一共有接近 400 小节。

课程的内容分为 3 部分:

  1. 《内存与垃圾回收篇》
  2. 《字节码与类的加载篇》
  3. 《性能监控与调优篇》

imgimg

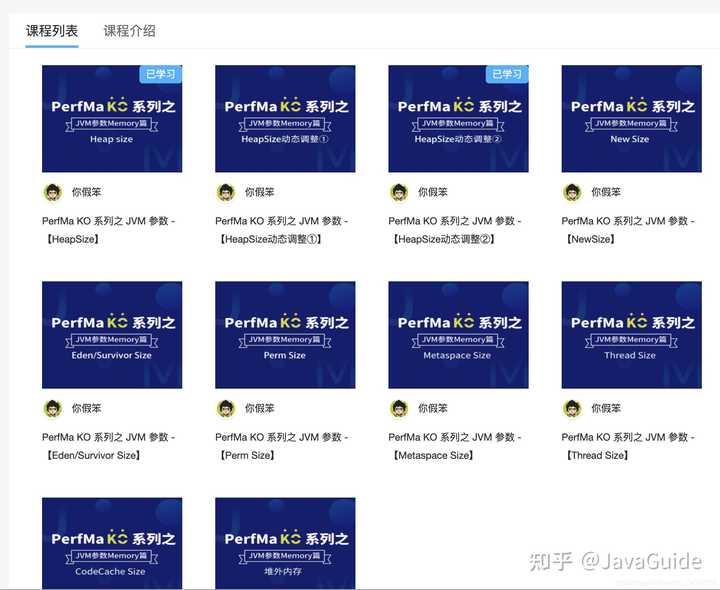
第 2 个是你假笨大佬的 《JVM 参数【Memory 篇】》 教程,很厉害了!
imgimg

下面是我总结的一些关于 JVM 的小问题,你可以拿来自测:

  1. 什么是虚拟机?
  2. Java 内存区域是怎么划分的?大对象放在哪个内存区域?
  3. 垃圾回收有哪些算法?GC 的流程
  4. 什么是类加载?何时类加载?类加载流程?
  5. 知道哪些类加载器。类加载器之间的关系?
  6. 类加载器的双亲委派了解么? 结合 Tomcat 说一下双亲委派(Tomcat 如何打破双亲委托机制?…)。
  7. 常见调优参数有哪些?
  8. ……

数据库

我们网站或 者 APP 的数据都是需要使用数据库来存储数据的。

MySQL

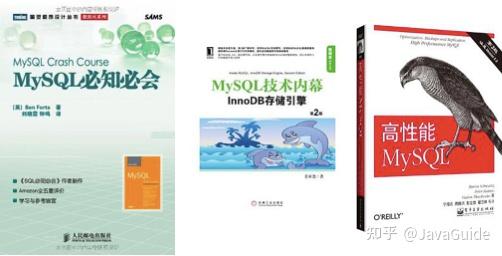
一般企业项目开发中,使用 MySQL 比较多。如果你要学习 MySQL 的话,可以看下面这 3 本书籍:

  • 《MySQL 必知必会》 :非常薄!非常适合 MySQL 新手阅读,很棒的入门教材。
  • 《高性能 MySQL》 : MySQL 领域的经典之作!学习 MySQL 必看!属于进阶内容,主要教你如何更好地使用 MySQL 。既有有理论,又有实践!如果你没时间都看一遍的话,拿我建议第 5 章(创建高性能的索引) 、第 6 章(查询性能优化) 你你一定要认真看一下。
  • 《MySQL 技术内幕》 :你想深入了解 MySQL 存储引擎的话,看这本书准没错!
imgimg

视频的话,你可以看看动力节点的 《MySQL 数据库教程视频》。这个视频基本上把 MySQL 的相关一些入门知识给介绍完了。

学习了 MySQL 之后,务必确保自己掌握下面这些知识点:

  1. MySQL 常用命令 :
  • 安全:登录、增加/删除用户、备份数据和还原数据
  • 数据库操作: 建库建表/删库删表、用户权限分配
  • ……
  1. MySQL 中常用的数据类型、字符集编码
  2. MySQL 简单查询、条件查询、模糊查询、多表查询以及如何对查询结果排序、过滤、分组……
  3. MySQL 中使用索引、视图、存储过程、游标、触发器
  4. ……

如果你想让自己更加了解 MySQL ,同时也是为了准备面试的话,下面这些知识点要格外注意:

  1. 索引:索引优缺点、B 树和 B+树、聚集索引与非聚集索引、覆盖索引
  2. 事务:事务、数据库事务、ACID、并发事务、事务隔离级别
  3. 存储引擎(MyISAM 和 InnoDB)
  4. 锁机制与 InnoDB 锁算法

Redis

Redis 就是一个使用 C 语言开发的数据库,不过与传统数据库不同的是 Redis 的数据是存在内存中的 ,也就是它是内存数据库,所以读写速度非常快,因此 Redis 被广泛应用于缓存方向。

如果你要学习 Redis 的话,强烈推荐 《Redis 设计与实现》 和 《Redis 实战》 这两本书。另外,**《Redis 开发与运维》** 这本书也非常不错,既有基础介绍,又有一线开发运维经验分享。
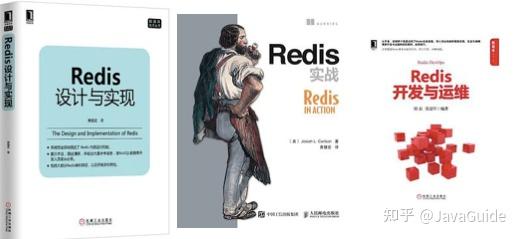
imgimg

下面是我总结的一些关于并发的小问题,你可以拿来自测:

  1. Redis 和 Memcached 的区别和共同点
  2. 为什么要用 Redis/为什么要用缓存?
  3. Redis 常见数据结构以及使用场景分析
  4. Redis 没有使用多线程?为什么不使用多线程?Redis6.0 之后为何引入了多线程?
  5. Redis 给缓存数据设置过期时间有啥用?
  6. Redis 是如何判断数据是否过期的呢?
  7. 过期的数据的删除策略了解么?
  8. Redis 内存淘汰机制了解么?
  9. Redis 持久化机制(怎么保证 Redis 挂掉之后再重启数据可以进行恢复)
  10. Redis 缓存穿透、缓存雪崩?
  11. 如何保证缓存和数据库数据的一致性?
  12. ……

常用工具

非常重要!非常重要!特别是 Git 和 Docker。

除了下面这些工具之外,我强烈建议你一定要搞懂 Github 的使用。一些使用 Github 的小技巧,你可以看《Github 小技巧》这篇文章。

IDEA

俗话说:“工欲善其事,必先利其器 !”。选择一款好的开发工具对于我们高效率编码非常有帮助!

常用的 Java 开发工具就 Eclipse 和 IDEA。就我个人而言 IDEA 是最适合 Java 开发者的 IDE 。

建议你要熟悉 IDEA 的基本操作以及常用快捷。你可以通过 Github 上的开源教程 《IntelliJ IDEA 简体中文专题教程》 来学习 IDEA 的相关使用。

除了 IDEA 自身对编码优秀的支持(比如智能上下文提示)之外,IDEA 中还有丰富的插件来帮助我们高效开发。《IDEA 插件》 这个系列专辑中推荐了很多实用 IDEA 必备的插件!

Maven

强烈建议学习常用框架之前可以提前花几天时间学习一下Maven的使用。(到处找 Jar 包,下载 Jar 包是真的麻烦费事,使用 Maven 可以为你省很多事情)。

Git

Git 技能对于程序员来说也是必备的!试着在学习的过程中将自己的代码托管在 Github 上,有一个漂亮的 Github 主页在求职面试中是十分加分的。并且,现在的企业都是基于 Git 在 GitHub 或 GitLab 平台上做版本控制。

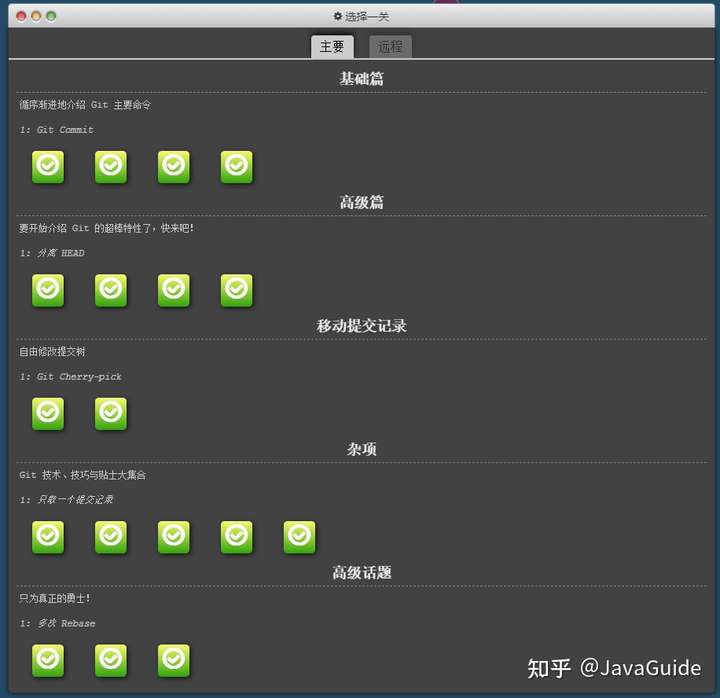
学习 Git 的话,强烈推荐给大家一个可以交互式学习 Git 的网站 Learn Git Branching。效果真的非常非常棒,通过游戏的方式让你学习 Git 的常见操作。

整个教程分为很多关,每一关都有非常详细的指导,还会有详细的动图展示结果。并且,你做错了之后还可以使用 reset 命令从头开始。
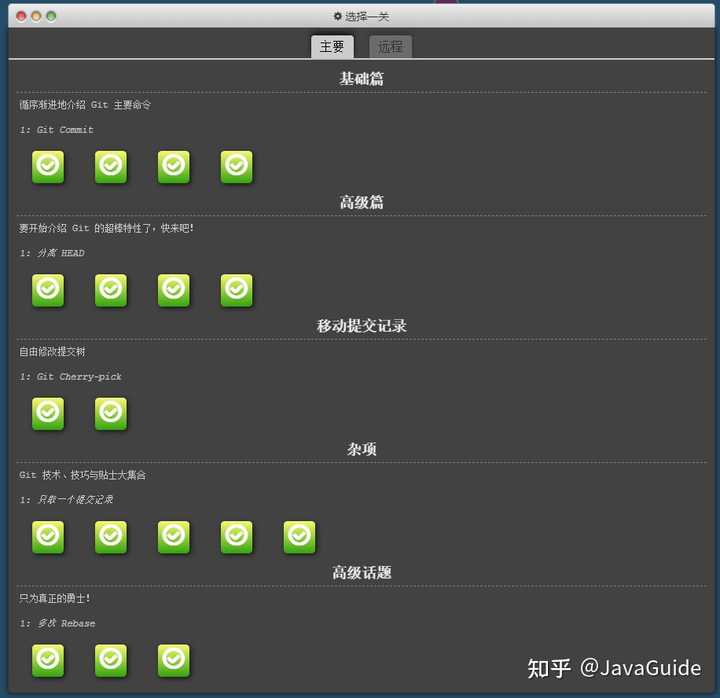
imgimg

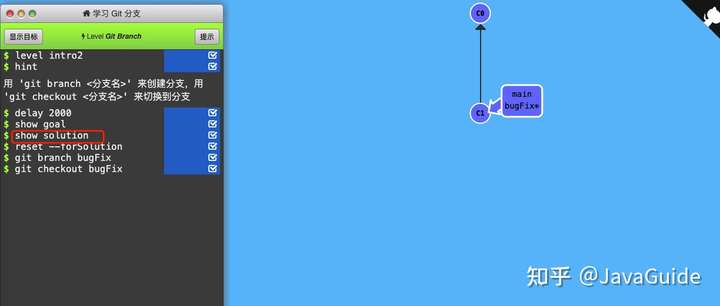
如果你是在不知道答案的话,还可以使用 show solution 命令查看答案。
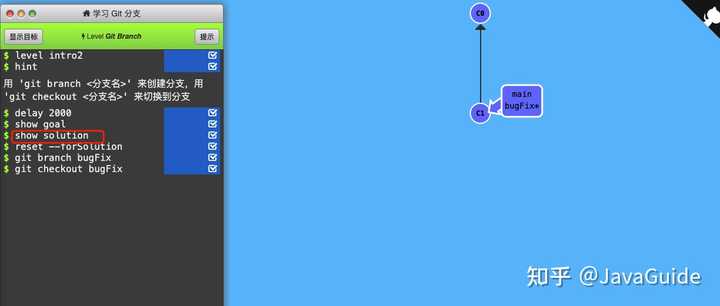
imgimg

这种即时反馈的学习让过程变得有趣!真心感谢这个网站的作者,太爱了!

另外,你可以看看 Github 上开源的这篇 《Git 极简入门》 ,像版本控制和 Git 的相关概念、Git 常见操作这篇文章都有介绍到。

如果想要详细了解 Git 的话,Git 官方文档教程是肯定要看的,介绍的非常全面,并且有中文版!
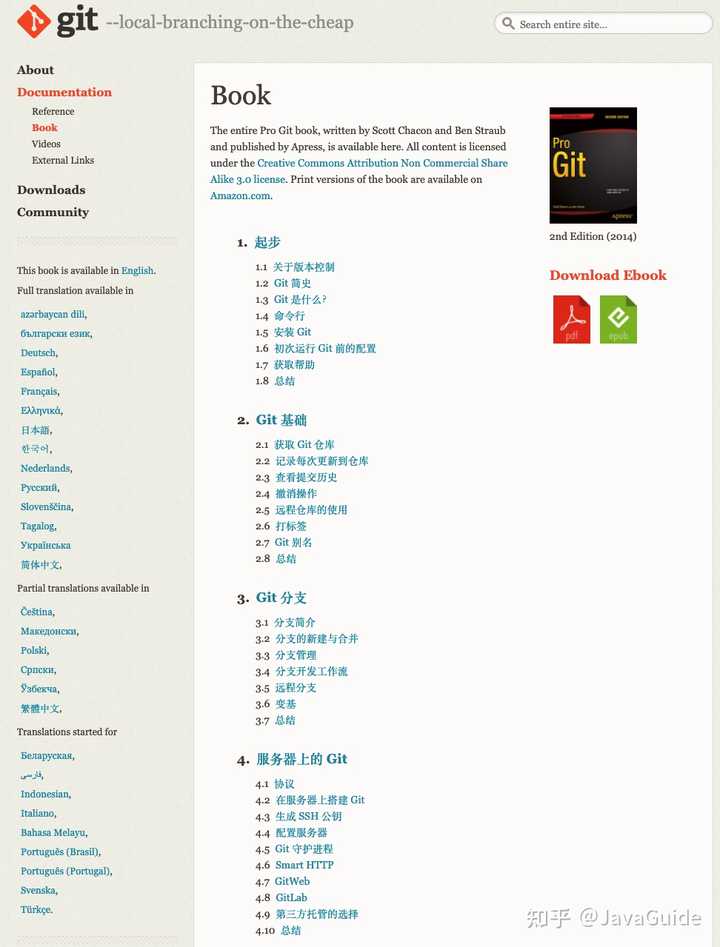
imgimg

《Pro Git》这本书也非常不错,还有中文版,内容非常全面,硬核!
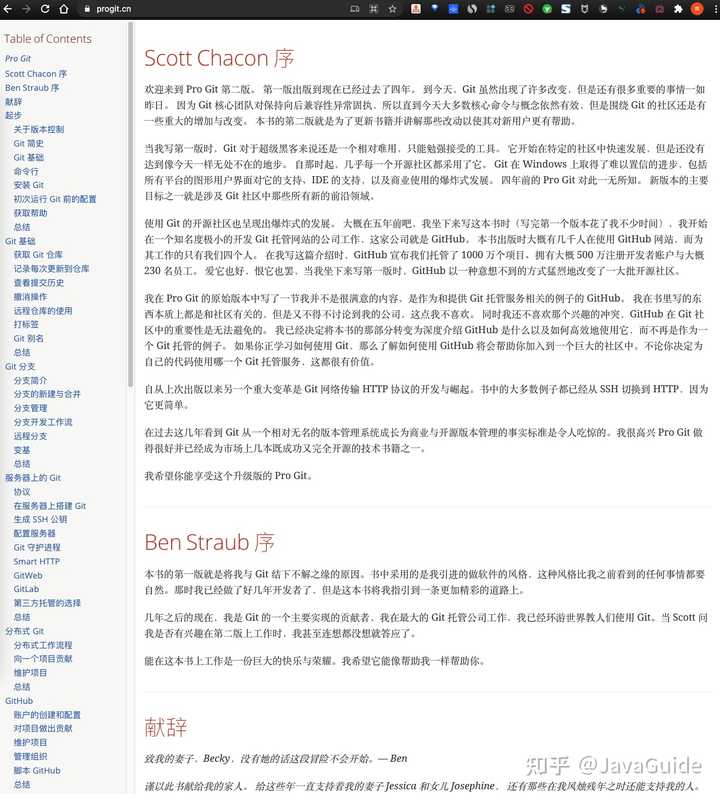
imgimg

imgimg

如果你比较喜欢看视频教程的话,可以看看极客时间的《玩转 Git 三剑客》,课程的作者是携程代码平台负责人苏玲,讲的挺不错的!

Docker

传统的开发流程中,我们的项目通常需要使用 MySQL、Redis、FastDFS 等等环境,这些环境都是需要我们手动去进行下载并配置的,安装配置流程极其复杂,而且不同系统下的操作也不一样。

Docker 的出现完美地解决了这一问题,我们可以在容器中安装 MySQL、Redis 等软件环境,使得应用和环境架构分开,它的优势在于:

  1. 一致的运行环境,能够更轻松地迁移
  2. 对进程进行封装隔离,容器与容器之间互不影响,更高效地利用系统资源
  3. 可以通过镜像复制多个一致的容器

Docker 常见概念解读,可以看这篇 Github 上开源的这篇《Docker 基本概念解读》 ,从零到上手实战可以看《Docker 从入门到上手干事》这篇文章,内容非常详细!

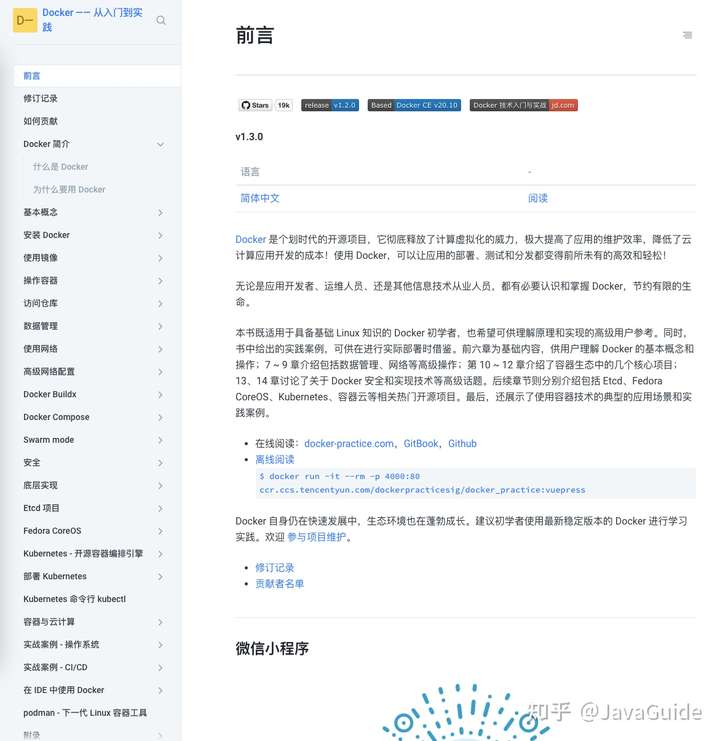
另外,再给大家推荐一本质量非常高的开源书籍《Docker 从入门到实践》 ,这本书的内容非常新,毕竟书籍的内容是开源的,可以随时改进。
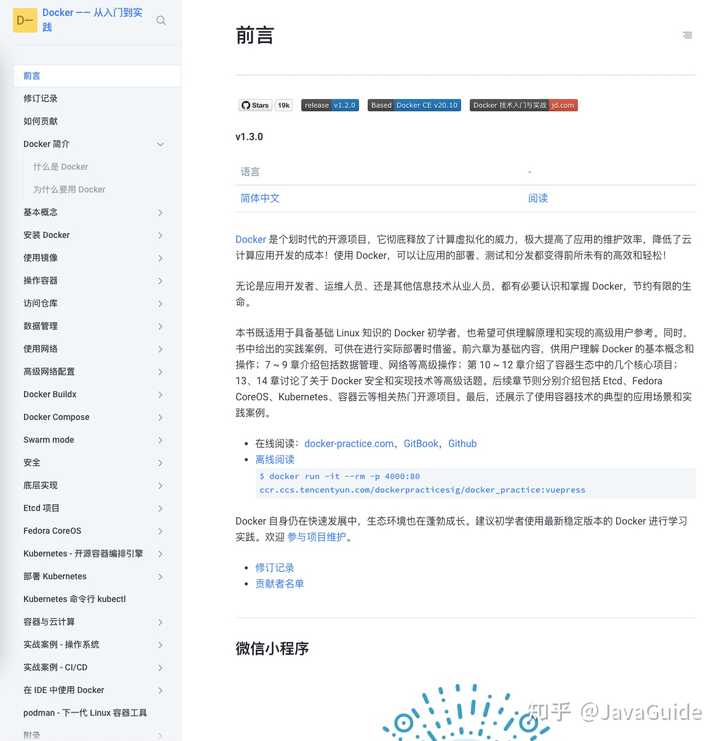
imgimg

常用框架

2021 最新Java实战项目源码打包下载t.1yb.co图标

Spring/SpringBoot

Spring 和 SpringBoot 真的很重要!

一定要搞懂 AOP 和 IOC 这两个概念。Spring 中 bean 的作用域与生命周期、SpringMVC 工作原理详解等等知识点都是非常重要的,一定要搞懂。

企业中做 Java 后端,你一定离不开 SpringBoot ,这个是必备的技能了!一定一定一定要学好!

像 SpringBoot 和一些常见技术的整合你也要知识怎么做,比如 SpringBoot 整合 MyBatis、 ElasticSearch、SpringSecurity、Redis 等等。

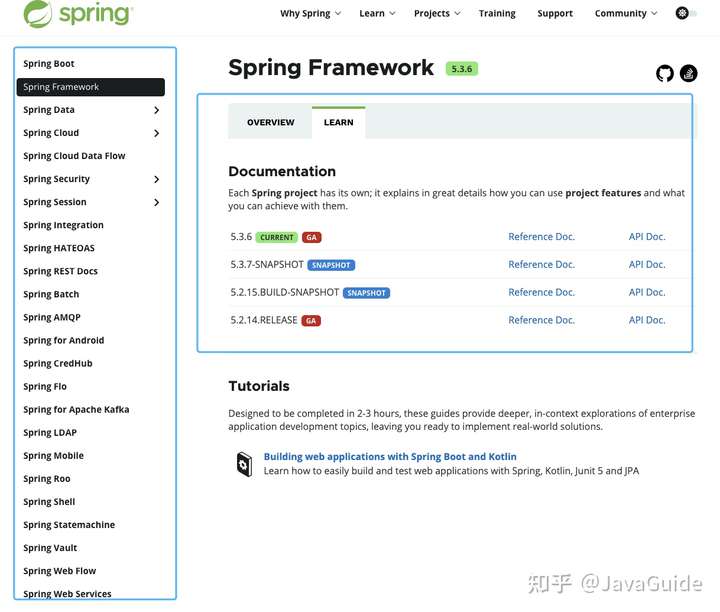
学习 Spring 的话,可以多看看 **《Spring 的官方文档》**,写的很详细。你可以在这里找到 Spring 全家桶的学习资源。
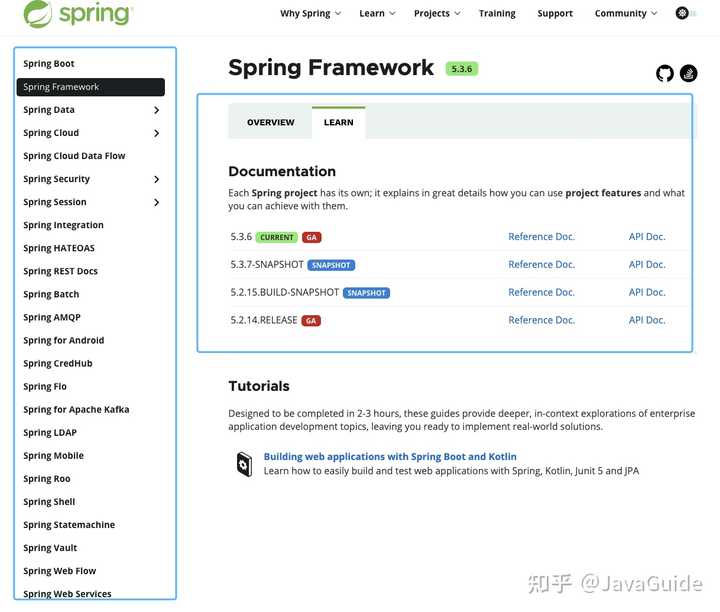
imgimg

你也可以把 《Spring 实战》 这本书作为学习 Spring 的参考资料。 这本书还是比较新的,目前已经出到了第 5 版,基于 Spring 5 来讲。
imgimg

了解了 Spring 中的一些常见概念和基本用法之后,你就可以开始学习 Spring Boot 了。

当然了,Spring 其实并不是学习 Spring Boot 的前置基础,相比于 Spring 来说,Spring Boot 要更容易上手一些!如果你只是想使用 Spring Boot 来做项目的话,直接学 Spring Boot 就可以了。

不过,我建议你在学习 Spring Boot 之前,可以看看 《Spring 常见问题总结》 。这些问题都是 Spring 比较重要的知识点,也是面试中经常会被问到的。

学习 Spring Boot 的话,还是建议可以多看看 **《Spring Boot 的官方文档》**,写的很详细。

你也可以把 《Spring Boot 实战》 这本书作为学习 Spring Boot 的参考资料。
imgimg

这本书的整体质量实际一般,你当做参考书来看就好了!

相比于 《Spring Boot 实战》这本书,我更推荐国人写的 《Spring Boot 实战派》 。
imgimg

这本书使用的 Spring Boot 2.0+的版本,还算比较新。整本书采用“知识点+实例”的形式编写,书籍的最后两章还有 2 个综合性的企业实战项目:

  • 开发企业级通用的后台系统
  • 实现一个类似“京东”的电子商务商城

作者在注意实战的过程中还不忘记对于一些重要的基础知识的讲解。

如果你想专研 Spring Boot 底层原理的话,可以看看 《Spring Boot 编程思想(核心篇)》 。
imgimg

这本书稍微有点啰嗦,不过,原理介绍的比较清楚(不适合初学者)。

如果你比较喜欢看视频的话,推荐尚硅谷雷神的**《2021 版 Spring Boot2 零基础入门》** 。
imgimg

这可能是全网质量最高并且免费的 Spring Boot 教程了,好评爆炸!

另外,Spring Boot 这块还有很多优质的开源教程,我已经整理好放到 awesome-java@SpringBoot 中了。
imgimg

Netty

但凡涉及到网络通信就必然必然离不开网络编程。 Netty 目前作为 Java 网络编程最热门的框架,毫不夸张地说是每个 Java 程序员必备的技能之一。

为什么说学好 Netty 很有必要呢?

  1. Netty 基于 NIO (NIO 是一种同步非阻塞的 I/O 模型,在 Java 1.4 中引入了 NIO )。使用 Netty 可以极大地简化并简化了 TCP 和 UDP 套接字服务器等网络编程,并且性能以及安全性等很多方面都非常优秀。
  2. 我们平常经常接触的 Dubbo、RocketMQ、Elasticsearch、gRPC、Spark、Elasticsearch 等等热门开源项目都用到了 Netty。
  3. 大部分微服务框架底层涉及到网络通信的部分都是基于 Netty 来做的,比如说 Spring Cloud 生态系统中的网关 Spring Cloud Gateway 。

下面是一些比较推荐的书籍/专栏。

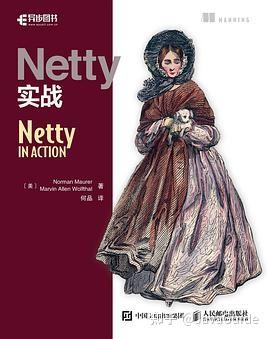
《Netty 实战》
imgimg

这本书可以用来入门 Netty ,内容从 BIO 聊到了 NIO、之后才详细介绍为什么有 Netty 、Netty 为什么好用以及 Netty 重要的知识点讲解。

这本书基本把 Netty 一些重要的知识点都介绍到了,而且基本都是通过实战的形式讲解。

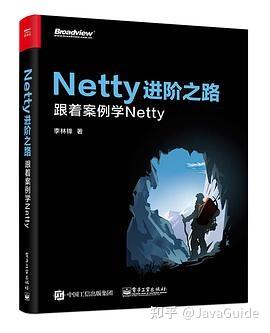
《Netty 进阶之路:跟着案例学 Netty》
imgimg

内容都是关于使用 Netty 的实践案例比如内存泄露这些东西。如果你觉得你的 Netty 已经完全入门了,并且你想要对 Netty 掌握的更深的话,推荐你看一下这本书。

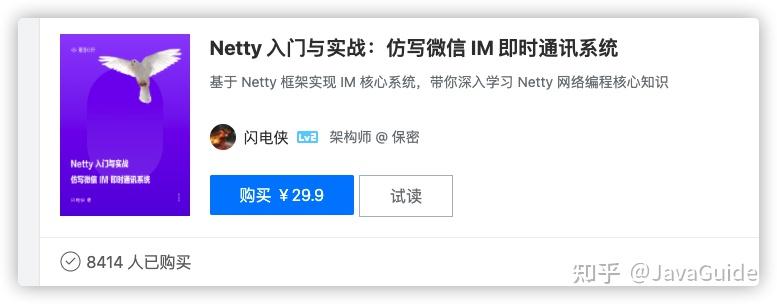
《Netty 入门与实战:仿写微信 IM 即时通讯系统》
imgimg

通过一个基于 Netty 框架实现 IM 核心系统为引子,带你学习 Netty。整个小册的质量还是很高的,即使你没有 Netty 使用经验也能看懂。

搜索引擎

搜索引擎用于提高搜索效率,功能和浏览器搜索引擎类似。比较常见的搜索引擎是 Elasticsearch(推荐) 和 Solr。

如果你要学习 Elasticsearch 的话,Elastic 中文社区 以及 Elastic 官方博客 都是非常不错的资源,上面会分享很多具体的实践案例。

除此之外,极客时间的《Elasticsearch 核心技术与实战》这门课程非常赞!这门课基于 Elasticsearch 7.1 版本讲解,比较新。并且,作者是 eBay 资深技术专家,有 20 年的行业经验,课程质量有保障!
imgimg

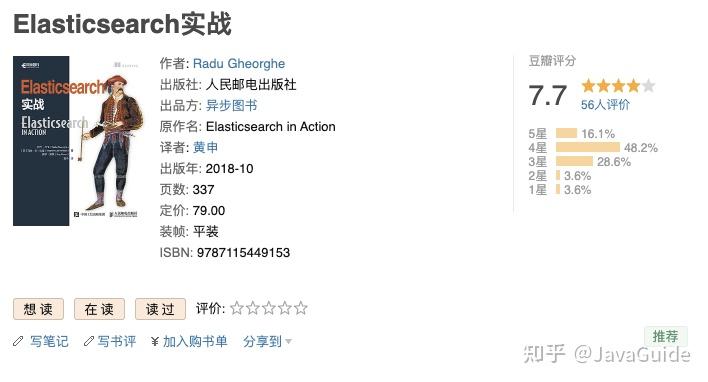
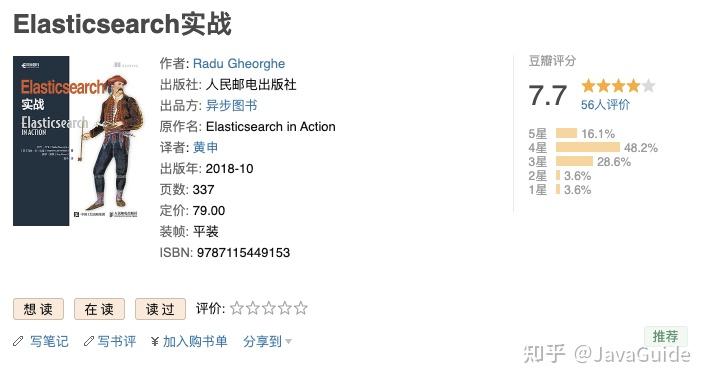
如果你想看书的话,可以考虑一下 《Elasticsearch 实战》 这本书。不过,需要说明的是,这本书中的 Elasticsearch 版本比较老,你可以将其作为一个参考书籍来看,有一些原理性的东西可以在上面找找答案。
imgimg

如果你想进一步深入研究 Elasticsearch 原理的话,可以看看张超老师的《Elasticsearch 源码解析与优化实战》这本书。这是市面上唯一一本写 Elasticsearch 源码的书。
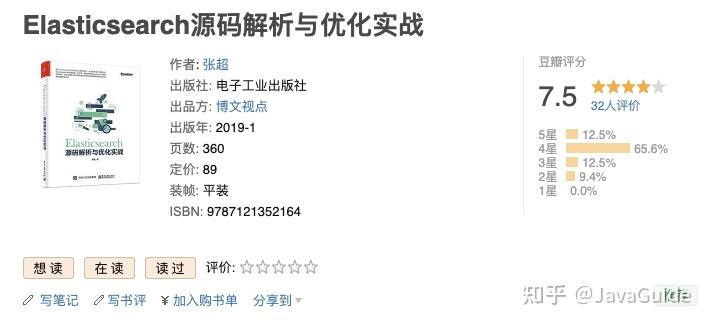
imgimg

分布式

下面我们开始学习分布式以及高并发、高可用了。

这块内容的话,对于每一个知识点没有特定的书籍。我就推荐 2 本我觉得还不错的书籍吧!这两把书籍基本把下面涉及到的知识点给涵盖了。

第一本是李运华老师的**《从零开始学架构》** 。
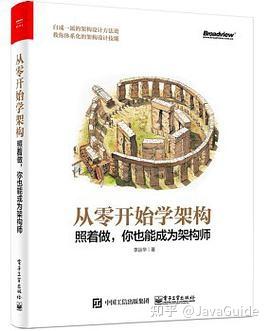
imgimg

这本书对应的有一个极客时间的专栏—《从零开始学架构》,里面的很多内容都是这个专栏里面的,两者买其一就可以了。

第二本是余老师的 《软件架构设计:大型网站技术架构与业务架构融合之道》 。
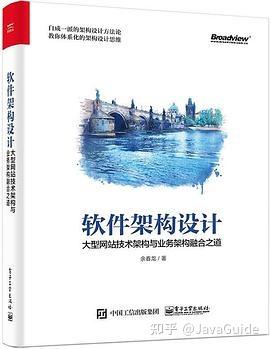
imgimg

事务与锁、分布式(CAP、分布式事务……)、高并发、高可用这本书都有介绍到。值得推荐!良心好书!

理论

CAP 理论

CAP 也就是 Consistency(一致性)、Availability(可用性)、Partition Tolerance(分区容错性) 这三个单词首字母组合。

关于 CAP 的详细解读请看:《CAP 理论解读》。

BASE 理论

BASE 是 Basically Available(基本可用) 、Soft-state(软状态) 和 Eventually Consistent(最终一致性) 三个短语的缩写。BASE 理论是对 CAP 中一致性和可用性权衡的结果,其来源于对大规模互联网系统分布式实践的总结,是基于 CAP 定理逐步演化而来的,它大大降低了我们对系统的要求。

关于 CAP 的详细解读请看:《BASE 理论解读》。

Paxos 算法和 Raft 算法

Paxos 算法诞生于 1990 年,这是一种解决分布式系统一致性的经典算法 。但是,由于 Paxos 算法非常难以理解和实现,不断有人尝试简化这一算法。到了 2013 年才诞生了一个比 Paxos 算法更易理解和实现的分布式一致性算法—Raft 算法。

RPC

RPC 让调用远程服务调用像调用本地方法那样简单。

Dubbo 是一款国产的 RPC 框架,由阿里开源。相关阅读:

服务注册与发现

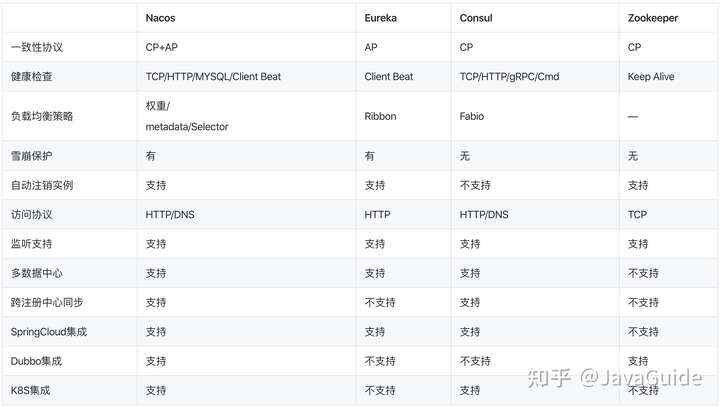
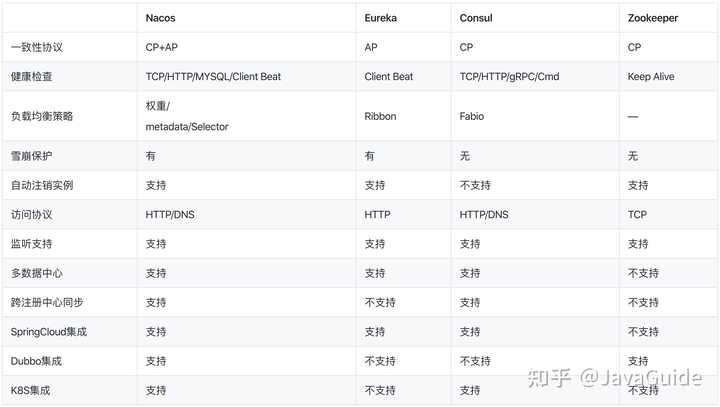
Eureka、Zookeeper、Consul、Nacos 都可以提供服务注册与发现的功能。
imgimg

API 网关

网关主要用于请求转发、安全认证、协议转换、容灾。

SpringCloud Gateway 是 Spring Cloud 的一个全新项目,为了取代 Netflix Zuul。

配置中心

微服务下,业务的发展一般会导致服务数量的增加,进而导致程序配置(服务地址、数据库参数等等)增多。

传统的配置文件的方式已经无法满足当前需求,主要有两点原因:一是安全性得不到保障(配置放在代码库中容易泄露);二是时效性不行 (修改配置需要重启服务才能生效)。

Spring Cloud Config、Nacos 、Apollo、K8s ConfigMap 都可以用来做配置中心。

Apollo 和 Nacos 我个人更喜欢。Nacos 使用起来更加顺手,Apollo 在配置管理方面做的更加全面。

分布式 id

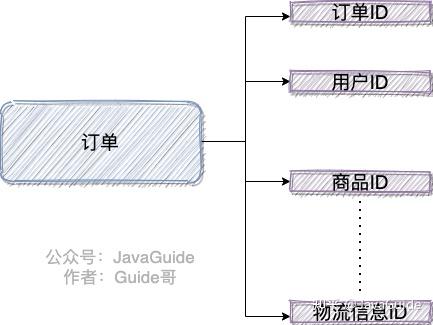
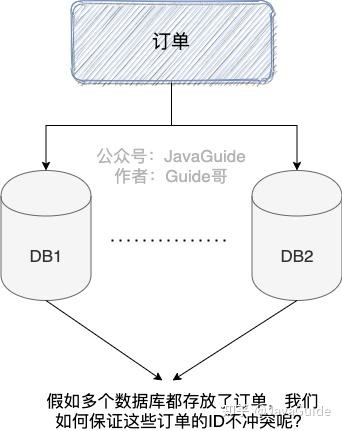
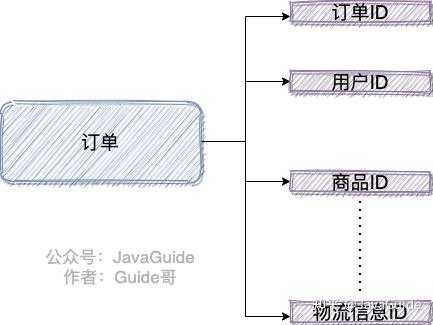
日常开发中,我们需要对系统中的各种数据使用 ID 唯一表示,比如用户 ID 对应且仅对应一个人,商品 ID 对应且仅对应一件商品,订单 ID 对应且仅对应一个订单。
imgimg

简单来说,ID 就是数据的唯一标识。

分布式 ID 是分布式系统下的 ID。分布式 ID 不存在与现实生活中,属于计算机系统中的一个概念。

我简单举一个分库分表的例子。

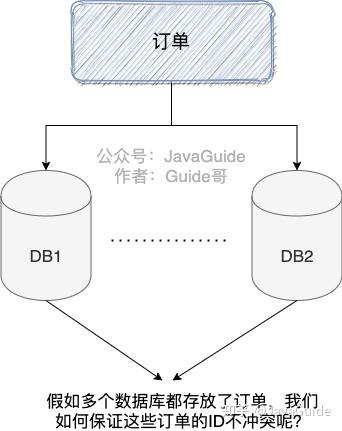
我司的一个项目,使用的是单机 MySQL 。但是,没想到的是,项目上线一个月之后,随着使用人数越来越多,整个系统的数据量将越来越大。

单机 MySQL 已经没办法支撑了,需要进行分库分表(推荐 Sharding-JDBC)。

在分库之后, 数据遍布在不同服务器上的数据库,数据库的自增主键已经没办法满足生成的主键唯一了。我们如何为不同的数据节点生成全局唯一主键呢?
imgimg

这个时候就需要生成分布式 ID了。

分布式 ID 的解决方案有很多比如 :

  • 算法 :UUID、Snowflake
  • 开源框架 : UidGenerator、Leaf 、Tinyid

分布式事务

微服务架构下,一个系统被拆分为多个小的微服务。

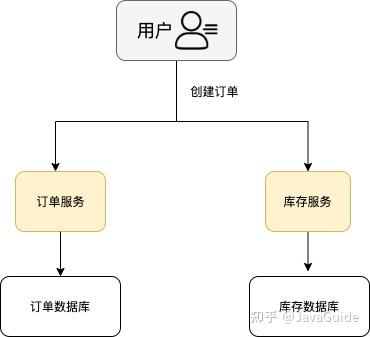
每个微服务都可能存在不同的机器上,并且每个微服务可能都有一个单独的数据库供自己使用。这种情况下,一组操作可能会涉及到多个微服务以及多个数据库。

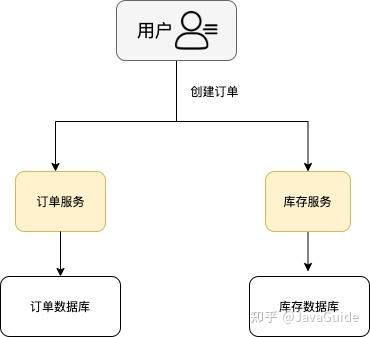
举个例子:电商系统中,你创建一个订单往往会涉及到订单服务(订单数加一)、库存服务(库存减一)等等服务,这些服务会有供自己单独使用的数据库。
imgimg

那么如何保证这一组操作要么都执行成功,要么都执行失败呢?

这个时候单单依靠数据库事务就不行了!我们就需要引入 分布式事务 这个概念了!

常用分布式事务解决方案有 Seata 和 Hmily。

  1. Seata :Seata 是一款开源的分布式事务解决方案,致力于在微服务架构下提供高性能和简单易用的分布式事务服务。
  2. Hmily : 金融级分布式事务解决方案

分布式链路追踪

不同于单体架构,在分布式架构下,请求需要在多个服务之间调用,排查问题会非常麻烦。我们需要分布式链路追踪系统来解决这个痛点。

目前分布式链路追踪系统基本都是根据谷歌的《Dapper 大规模分布式系统的跟踪系统》这篇论文发展而来,主流的有 Pinpoint,Skywalking ,CAT(当然也有其他的例如 Zipkin,Jaeger 等产品,不过总体来说不如前面选取的 3 个完成度高)等。

Zipkin 是 Twitter 公司开源的一个分布式链路追踪工具,Spring Cloud Sleuth 实际是基于 Zipkin 的。

SkyWalking 是国人吴晟(华为)开源的一款分布式追踪,分析,告警的工具,现在是 Apache 旗下开源项目

微服务

微服务的很多东西实际在分布式这一节已经提到了。

我这里就再补充一些微服务架构中,经常使用到的一些组件。

  • 声明式服务调用 : Feign
  • 负载均衡 : Ribbon
  • ……

高并发

消息队列

imgimg

消息队列在分布式系统中主要是为了解耦和削峰。相关阅读:消息队列常见问题总结。

常用的消息队列如下:

  1. RocketMQ :阿里巴巴开源的一款高性能、高吞吐量的分布式消息中间件。
  2. Kafaka: Kafka 是一种分布式的,基于发布 / 订阅的消息系统。关于它的入门可以查看:Kafka 入门看这一篇就够了
  3. RabbitMQ :由 erlang 开发的基于 AMQP(Advanced Message Queue 高级消息队列协议)协议实现的消息队列。

读写分离&分库分表

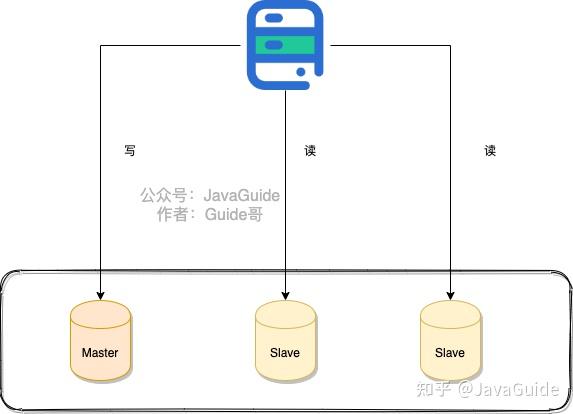
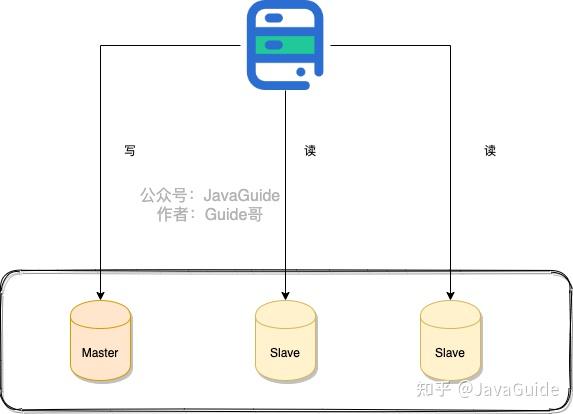
读写分离主要是为了将数据库的读和写操作分不到不同的数据库节点上。主服务器负责写,从服务器负责读。另外,一主一从或者一主多从都可以。

读写分离可以大幅提高读性能,小幅提高写的性能。因此,读写分离更适合单机并发读请求比较多的场景。
imgimg

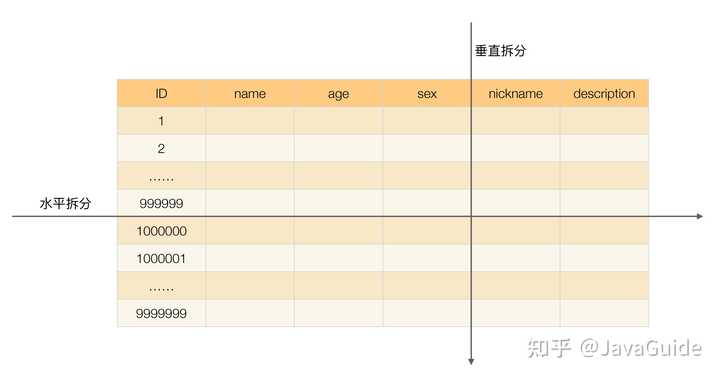
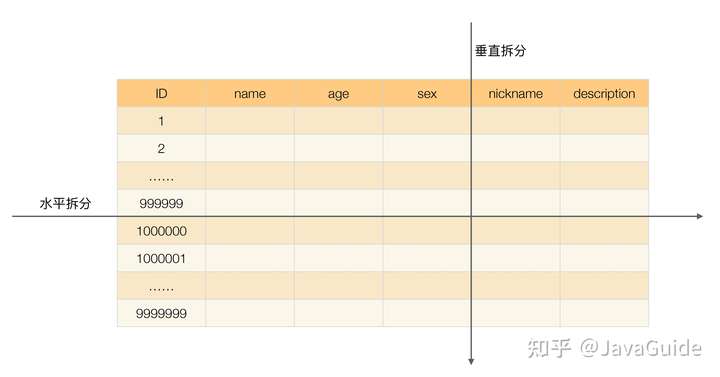
分库分表是为了解决由于库、表数据量过大,而导致数据库性能持续下降的问题。

常见的分库分表工具有:sharding-jdbc(当当)、TSharding(蘑菇街)、MyCAT(基于 Cobar)、Cobar(阿里巴巴)…。 推荐使用 sharding-jdbc。 因为,sharding-jdbc 是一款轻量级 Java 框架,以 jar 包形式提供服务,不要我们做额外的运维工作,并且兼容性也很好。
imgimg

相关阅读: 读写分离&分库分表常见问题总结

负载均衡

负载均衡系统通常用于将任务比如用户请求处理分配到多个服务器处理以提高网站、应用或者数据库的性能和可靠性。

常见的负载均衡系统包括 3 种:

  1. DNS 负载均衡 :一般用来实现地理级别的均衡。
  2. 硬件负载均衡 : 通过单独的硬件设备比如 F5 来实现负载均衡功能(硬件的价格一般很贵)。
  3. 软件负载均衡 :通过负载均衡软件比如 Nginx 来实现负载均衡功能。

高可用

高可用描述的是一个系统在大部分时间都是可用的,可以为我们提供服务的。高可用代表系统即使在发生硬件故障或者系统升级的时候,服务仍然是可用的 。

相关阅读: 《如何设计一个高可用系统?要考虑哪些地方?》 。

限流&降级&熔断

限流是从用户访问压力的角度来考虑如何应对系统故障。限流为了对服务端的接口接受请求的频率进行限制,防止服务挂掉。比如某一接口的请求限制为 100 个每秒, 对超过限制的请求放弃处理或者放到队列中等待处理。限流可以有效应对突发请求过多。相关阅读:限流算法有哪些?

降级是从系统功能优先级的角度考虑如何应对系统故障。服务降级指的是当服务器压力剧增的情况下,根据当前业务情况及流量对一些服务和页面有策略的降级,以此释放服务器资源以保证核心任务的正常运行。

熔断和降级是两个比较容易混淆的概念,两者的含义并不相同。

降级的目的在于应对系统自身的故障,而熔断的目的在于应对当前系统依赖的外部系统或者第三方系统的故障。

Hystrix 和 Sentinel 都能实现限流、降级、熔断。

Hystrix 是 Netflix 开源的熔断降级组件,Sentinel 是阿里中间件团队开源的一款不光具有熔断降级功能,同时还支持系统负载保护的组件。

两者都是主要做熔断降级 ,那么两者到底有啥异同呢?该如何选择呢?

Sentinel 的 wiki 中已经详细描述了其与 Hystrix 的区别,你可以看看。

排队

另类的一种限流,类比于现实世界的排队。玩过英雄联盟的小伙伴应该有体会,每次一有活动,就要经历一波排队才能进入游戏。

集群

相同的服务部署多份,避免单点故障。

超时和重试机制

一旦用户的请求超过某个时间得不到响应就结束此次请求并抛出异常。 如果不进行超时设置可能会导致请求响应速度慢,甚至导致请求堆积进而让系统无法在处理请求。

另外,重试的次数一般设为 3 次,再多次的重试没有好处,反而会加重服务器压力(部分场景使用失败重试机制会不太适合)。
l

线程与进程

一、进程

  1. 计算机内存空间

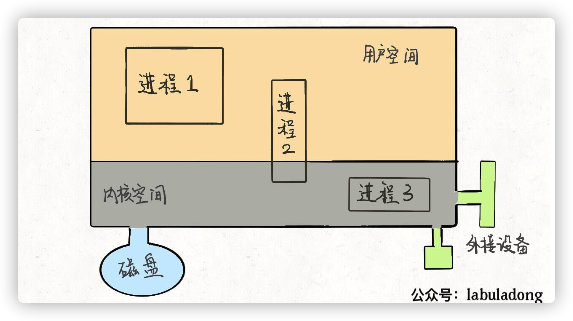
​ 用户空间装着用户进程需要使用的资源,比如你在程序代码里开一个数组, 这个数组肯定存在用户空间;内核空间存放内核进程需要加载的系统资源, 这一些资源一般是不允许用户访问的。但是注意有的用户进程会共享一些内 核空间的资源,比如一些动态链接库等等。

  1. 对于操作系统,进程就是一个数据结构,直接看 Linux 的源码:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    struct task_struct {
    // 进程状态
    long state;
    // 虚拟内存结构体
    struct mm_struct *mm;
    // 进程号
    pid_t pid;
    // 指向父进程的指针
    struct task_struct __rcu *parent;
    // 一个数组,包含该进程打开的文件指针
    struct files_struct *files;
    };

    ​ 其中比较有意思的是 mm 指针和 files 指针。

    ​ mm 指针指向:进程的虚拟内存,也就是载入资源和可执行文件的地方;

    ​ files 指针指向:一个数组,这个数组里装着所有该进程打开的文件的指针。

二、文件描述符

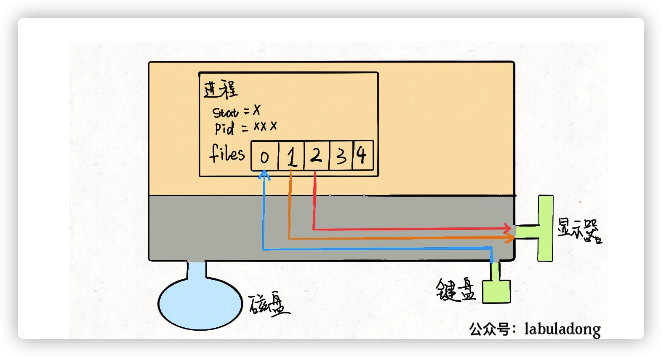
​ 每个进程被创建时, files 的前三位被填入默认值,分别指向标准输入 流、标准输出流、标准错误流。我们常说的「文件描述符」就是指这个文件 指针数组的索引(0,1,2),所以程序的文件描述符默认情况下 0 是输入,1 是输出, 2 是错误。

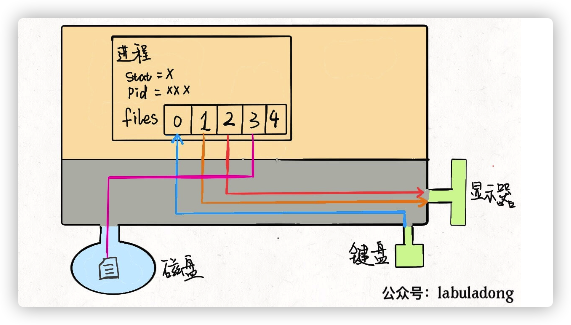
​ linux一切皆文件,对于一般的计算机,输入流是键盘,输出流是显示器,错误流也是显示器, 所以现在这个进程和内核连了三根线。因为硬件都是由内核管理的,我们的 进程需要通过「系统调用」让内核进程访问硬件资源。

​ 如果我们写的程序需要其他资源,比如打开一个文件进行读写,这也很简 单,进行系统调用,让内核把文件打开,这个文件就会被放到 files 的第 4 个位置:

输入重定向:command < file.txt,file[0]指向file.txt,程序从file[0]读取数据

输出重定向:command > file.txt,file[1]指向file.txt, 程序像file[1]写入数据

管道符:cmd1 | cmd2 把一个进程的输出流和另一个进程的输入流接起 一条「管道」,数据就在其中传递

注意:一个简单的 files 数组,进程通过简单的文件描述符访问相应资源, 具体细节交于操作系统,有效解耦,优美高效。

三、线程是什么

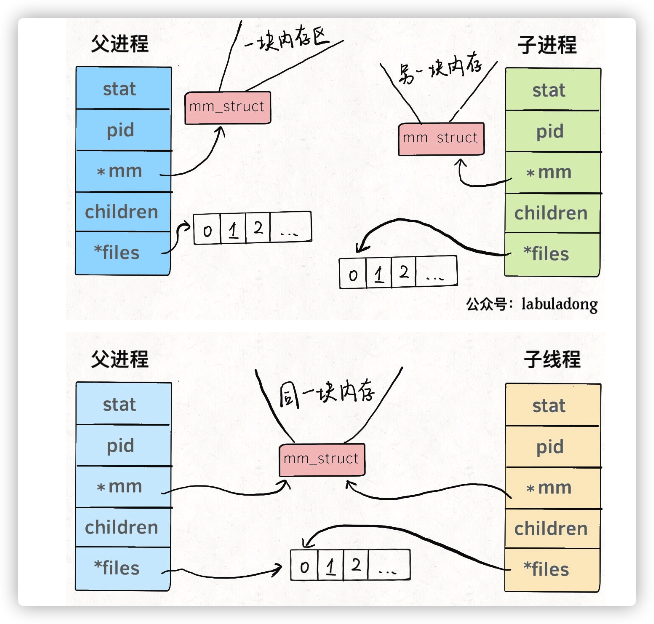
​ 之所以Linux 中线程和进程基本没有区别呢,因为从 Linux 内核的角度来看,并没有把线程和进程区别对待。都是用 task_struct 结构表示的,唯一的 区别就是共享的数据区域不同。

​ 换句话说,线程看起来跟进程没有区别,只是线程的某些数据区域和其父进 程是共享的,而子进程是拷⻉副本,而不是共享。就比如说, mm 结构 和 files 结构在线程中都是共享的,我画两张图你就明白了:

注意:对于新建进程时内存区域拷 ⻉的问题,Linux 采用了 copy-on-write 的策略优化,也就是并不真正复制父 进程的内存空间,而是等到需要写操作时才去复制。所以 Linux 中新建进 程和新建线程都是很迅速的。

l

面试官:说说你了解class文件吗?

本文思维导图:

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/2rLXEs_20210507091957.png

Class类文件结构

为什么Java可以一次编译到处运行?JVM无关性

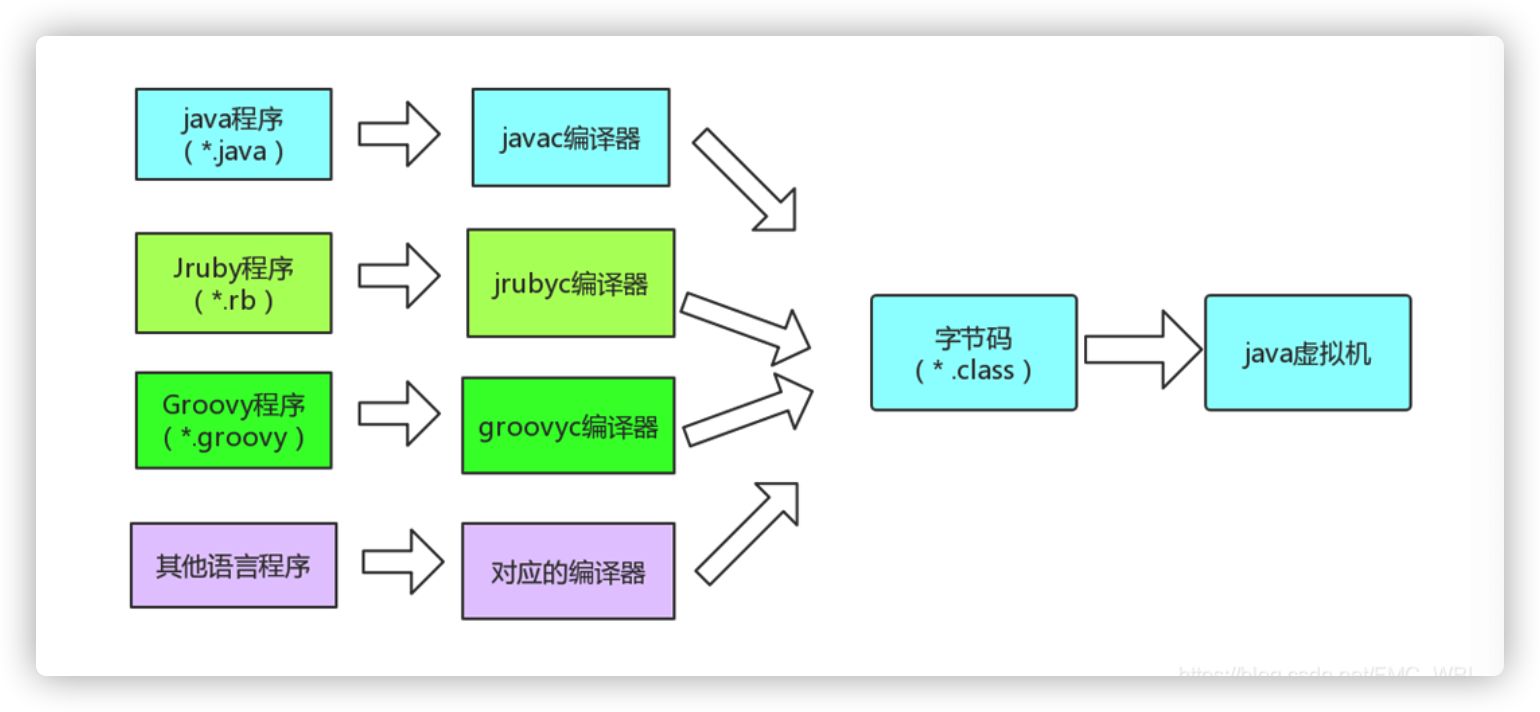
与平台无关性是建立在操作系统上,虚拟机厂商提供了许多可以运行在各种不同平台的虚拟机,它们都可以载入和执行字节码,从而实现程序的“一次编写,到处运行”。

各种不同平台的虚拟机与所有平台都统一使用的程序存储格式——字节码(Byte Code)是构成平台无关性的基石,也是语言无关性的基础。Java 虚拟机不和包括 Java 在内的任何语言绑定,它只与“Class 文件”这种特定的二进制文件格式所关联,Class 文件中包含了 Java 虚拟机指令集和符号表以及若干其他辅助信息。

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/ZGOAdI_20210507092208.png

Class 类文件

Java 技术能够一直保持非常好的向后兼容性,这点 Class 文件结构的稳定性功不可没。Java 已经发展到 14 版本,但是 class 文件结构的内容,绝大部分在JDK1.2 时代就已经定义好了。虽然 JDK1.2 的内容比较古老,但是 java 发展经历了十余个大版本,但是每次基本上知识在原有结构基础上新增内容、扩充功能,并未对定义的内容做修改。

任何一个 Class 文件都对应着唯一一个类或接口的定义信息,但反过来说,Class 文件实际上它并不一定以磁盘文件的形式存在(比如可以动态生成、或者直接送入类加载器中)。
Class 文件是一组以 8 位字节为基础单位的二进制流。
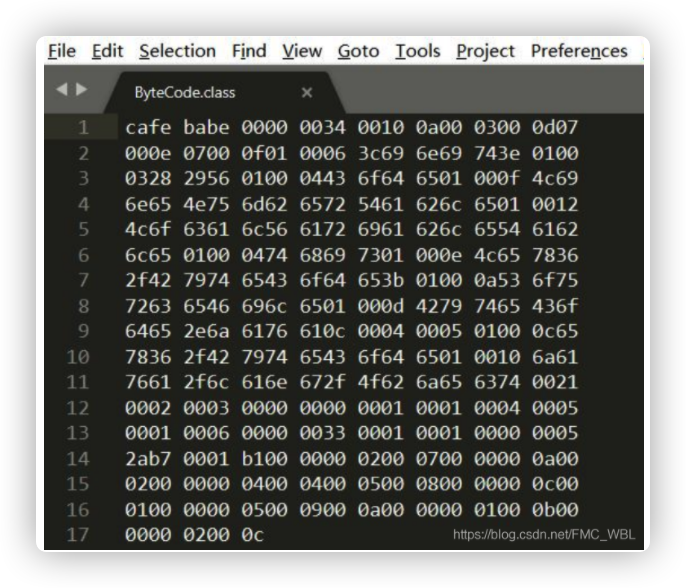
工具介绍

Sublime:查看 16 进制的编辑器
javap:javap 是 JDK 自带的反解析工具。它的作用是将 .class 字节码文件解析成可读的文件格式。
在使用 javap 时我一般会添加 -v 参数,尽量多打印一些信息。同时,我也会使用 -p 参数,打印一些私有的字段和方法。
jclasslib:如果你不太习惯使用命令行的操作,还可以使用 jclasslib,jclasslib 是一个图形化的工具,能够更加直观的查看字节码中的内容。它还分门别类的对类中的各个部分进行了整理,非常的人性化。同时,它还提供了 Idea 的插件,你可以从 plugins 中搜索到它。

Class 文件格式

从一个 Class 文件开始,整个 Class 文件的格式就是一个二进制的字节流。各个数据项目严格按照顺序紧凑地排列在 Class 文件之中,中间没有添加任何分隔符,这使得整个 Class 文件中存储的内容几乎全部是程序运行的必要数据,没有空隙存在。

Class 文件格式采用一种类似于 C 语言结构体的伪结构来存储数据,这种伪结构中只有两种数据类型:无符号数和表。

无符号数属于基本的数据类型,以 u1、u2、u4、u8 来分别代表 1 个字节(一个字节是由两位 16 进制数组成 (1个16进制数=4个二进制数 8个二进制数=一个字节))、2 个字节、4 个字节和 8 个字节的无符号数,无符号数可以用来描述数字、索引引用、数量值或者按照 UTF-8 编码构成字符串值。

表是由多个无符号数或者其他表作为数据项构成的复合数据类型,所有表都习惯性地以“_info”结尾。表用于描述有层次关系的复合结构的数据,整个Class 文件本质上就是一张表。

Class 文件格式详解

Class 的结构不像 XML 等描述语言,由于它没有任何分隔符号,所以在其中的数据项,无论是顺序还是数量,都是被严格限定的,哪个字节代表什么含义,长度是多少,先后顺序如何,都不允许改变。

https://cdn.jsdelivr.net/gh/swimminghao/picture@main/img/mwHImZ_20210507115741.png

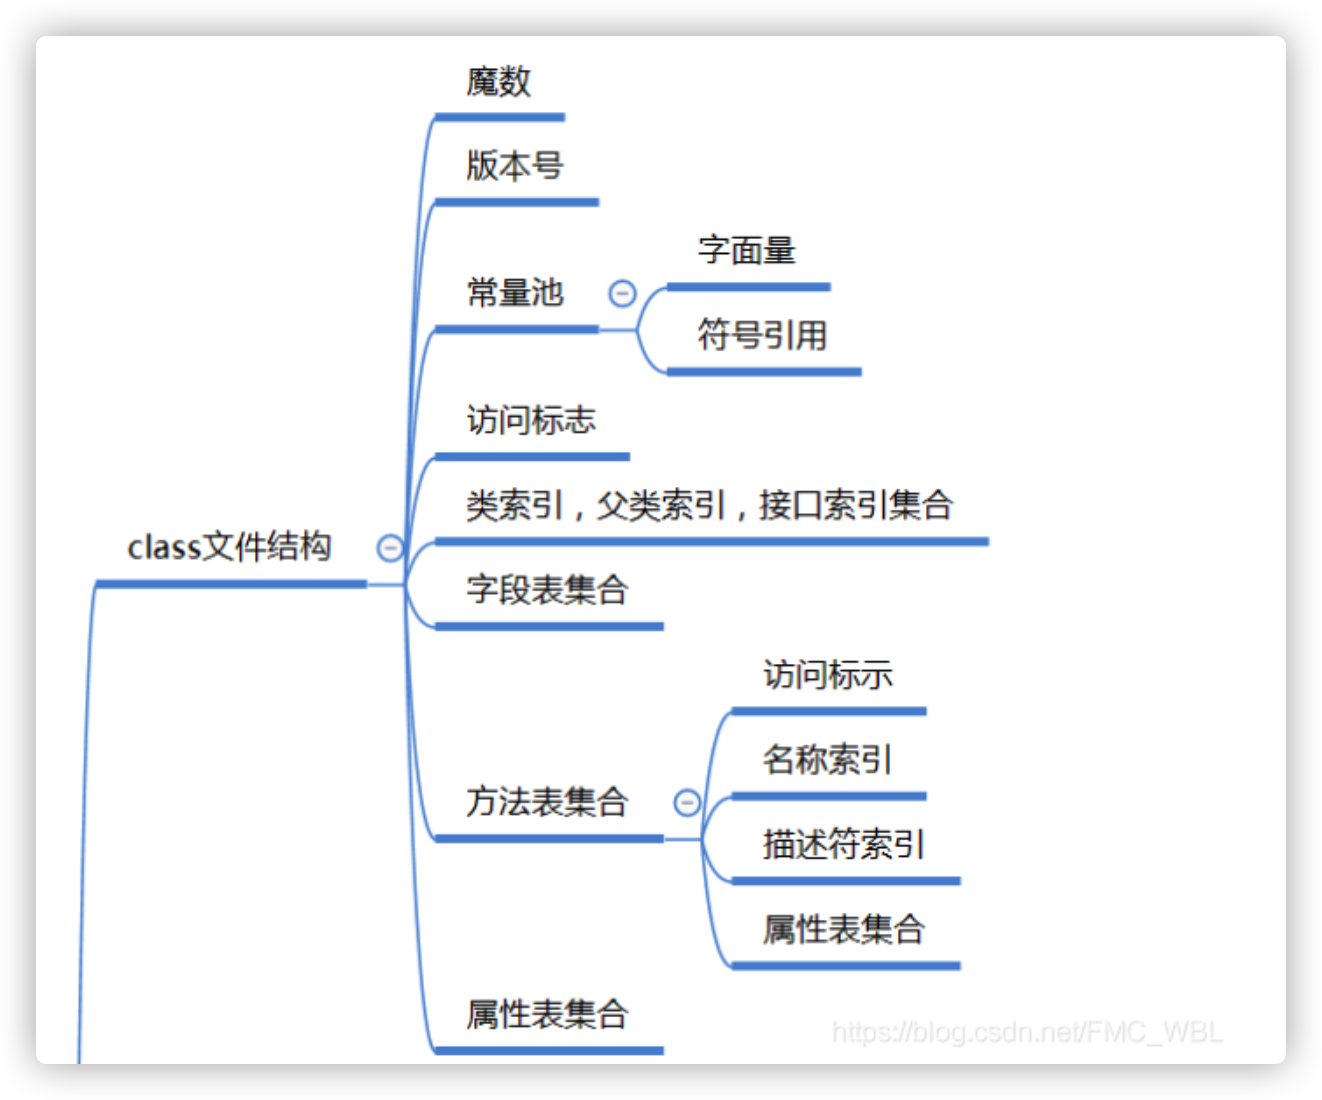
按顺序包括:

魔数与 Class 文件的版本

每个 Class 文件的头 4 个字节称为魔数(Magic Number),它的唯一作用是确定这个文件是否为一个能被虚拟机接受的 Class 文件。使用魔数而不是扩展名来进行识别主要是基于安全方面的考虑,因为文件扩展名可以随意地改动。文件格式的制定者可以自由地选择魔数值,只要这个魔数值还没有被广泛采用过同时又不会引起混淆即可。

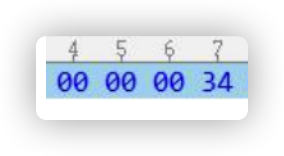
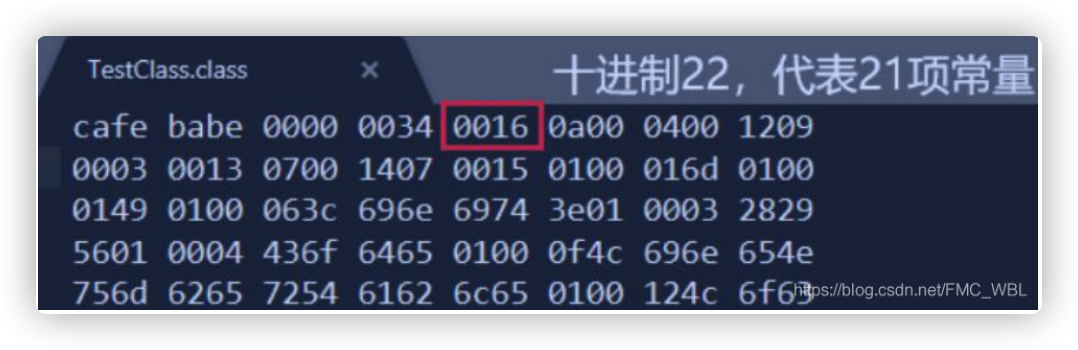
紧接着魔数的 4 个字节存储的是 Class 文件 的版本号:第 5 和第 6 个字节是次版本号(MinorVersion),第 7 和第 8 个字节是主版本号(Major Version)。

Java 的版本号是从 45 开始的,JDK 1.1 之后的每个 JDK 大版本发布主版本号向上加 1 高版本的 JDK 能向下兼容以前版本的 Class 文件,但不能运行以后版本的 Class 文件,即使文件格式并未发生任何变化,虚拟机也必须拒绝执行超过其版本号的 Class 文件。代表 JDK1.8(16 进制的 34,换成 10 进制就是 52)

常量池

常量池中常量的数量是不固定的,所以在常量池的入口需要放置一项 u2 类型的数据,代表常量池容量计数值(constant_pool_count)。与 Java 中语言习惯不一样的是,这个容量计数是从 1 而不是 0 开始的

常量池中主要存放两大类常量:字面量(Literal)和符号引用(Symbolic References)。
字面量比较接近于 Java 语言层面的常量概念,如文本字符串、声明为 final 的常量值等。
符号引用则属于编译原理方面的概念,包括了下面三类常量:类和接口的全限定名(Fully Qualified Name)、字段的名称和描述符(Descriptor)、方法的名称和描述符

访问标志

用于识别一些类或者接口层次的访问信息,包括:这个 Class 是类还是接口;是否定义为 public 类型;是否定义为 abstract 类型;如果是类的话,是否被声明为 final 等

类索引、父类索引与接口索引集合

这三项数据来确定类的继承关系。类索引用于确定这个类的全限定名,父类索引用于确定这个类的父类的全限定名。由于 Java 语言不允许多重继承,所以父类索引只有一个,除了 java.lang.Object 之外,所有的 Java 类都有父类,因此除了java.lang.Object 外,所有 Java 类的父类索引都不为 0。接口索引集合就用来描述这个类实现了哪些接口,这些被实现的接口将按 implements 语句(如果这个类本身是一个接口,则应当是 extends 语句)后的接口顺序从左到右排列在接口索引集合中

字段表集合

描述接口或者类中声明的变量。字段(field)包括类级变量以及实例级变量。
而字段叫什么名字、字段被定义为什么数据类型,这些都是无法固定的,只能引用常量池中的常量来描述。字段表集合中不会列出从超类或者父接口中继承而来的字段,但有可能列出原本 Java 代码之中不存在的字段,譬如在内部类中为了保持对外部类的访问性,会自动添加指向外部类实例的字段。

方法表集合

描述了方法的定义,但是方法里的 Java 代码,经过编译器编译成字节码指令后,存放在属性表集合中的方法属性表集合中一个名为“Code”的属性里面。

与字段表集合相类似的,如果父类方法在子类中没有被重写(Override),方法表集合中就不会出现来自父类的方法信息。但同样的,有可能会出现由编译器自动添加的方法,最典型的便是类构造器“<clinit>”方法和实例构造器“<init>”

属性表集合

存储 Class 文件、字段表、方法表都自己的属性表集合,以用于描述某些场景专有的信息。如方法的代码就存储在 Code 属性表中。

l

10、【对线面试官】TreadLocal

今天要不来聊聊ThreadLocal吧?

  1. 我个人对ThreadLocal理解就是
  2. 它能够提供了线程的局部变量让每个线程都可以通过set/get来对这个局部变量进行操作
  3. 不会和其他线程的局部变量进行冲突,实现了线程的数据隔离

你在工作中有用到过ThreadLocal吗?

  1. 这块是真不多,不过还是有一处的。就是我们项目有个的DateUtils工具类
  2. 这个工具类主要是对时间进行格式化
  3. 格式化/转化的实现是用的SimpleDateFormat
  4. 但众所周知SimpleDateFormat不是线程安全的 ,所以我们就用ThreadLocal来让每个线程装载着自己的SimpleDateFormat对象
  5. 以达到在格式化时间时,线程安全的目的
  6. 在方法上创建SimpleDateFormat对象也没问题,但每调用一次就创建一次有点不优雅
  7. 在工作中ThreadLocal的应用场景确实不多,但要不我给你讲讲Spring是怎么用的?

spring中的应用

  1. Spring提供了事务相关的操作,而我们知道事务是得保证一组操作同时成功或失败的
  2. 这意味着我们一次事务的所有操作需要在同一个数据库连接上
  3. 但是在我们日常写代码的时候是不需要关注这点的
  4. Spring就是用的ThreadLocal来实现,Th readLocal存储的类型是一个Map
  5. Map中的key是DataSource,value是C onnection(为了应对多数据源的情况,所以是一个Map)
  6. 用了ThreadLocal保证了同一个线程获取一个Connection对象,从而保证一次事务的所有操作需要在同一个数据库连接上

你知道ThreadLocal内存泄露这个知识点吗?

  1. 了解的,要不我先来讲讲ThreadLocal的原理?
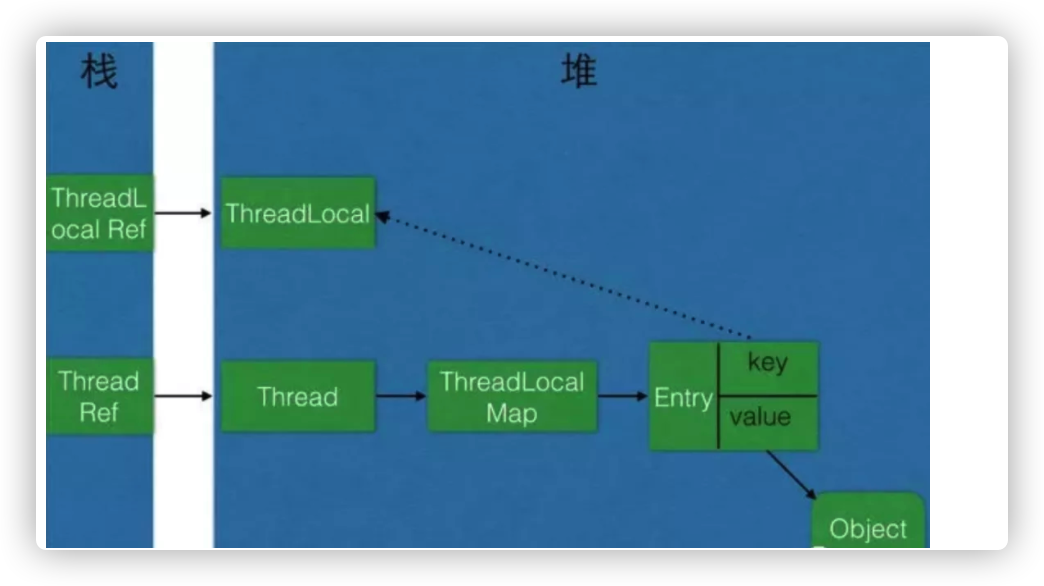
    • ThreadLocal是一个壳子,真正的存储结构是ThreadLocal里有ThreadLocalMap这么个内部类
    • 而有趣的是,ThreadLocalMap的引用是在Thread上定义的
    • ThreadLocal本身并不存储值,它只是作为key来让线程从ThreadLocalMap获取value
    • 所以,得出的结论就是ThreadLocalMap该结构本身就在Thread下定义,而ThreadLocal只是作为key,存储set到ThreadLocalMap的变量当然是线程私有的咯

l

11、【对线面试官】CountDownLatch和CyclicBarrier

我现在有个场景:现在我有50个任务,这50个任务在完成之后,才能执行下一个「函数」,要是你,你怎么设计?

  1. 可以用JDK给我们提供的线程工具类,CountDownLatch和CyclicBarrier都可以完成这个需求。
  2. 这两个类都可以等到线程完成之后,才去执行某些操作

那既然都能实现的话?那CountDownLatch和CyclicBarrier有什么什么区别呢?

  • 主要的区别就是CountDownLatch用完了,就结束了,没法复用。而CyclicBarrier不一样,它可以复用。
  • 比如说,你得给我解释:CountDownLatch和CyclicBarrier都是线程同步的工具类
    od
  • CountDownLatch允许一个或多个线程一直等待,直到这些线程完成它们的操作
  • 而CyclicBarrier不一样,它往往是当线程到达某状态后,暂停下来等待其他线程等到所有线程均到达以后,才继续执行
  • 可以发现这两者的等待主体是不一样的。
  • CountDownLatch调用await()通常是主线程/调用线程,而CyclicBarrier调用await()是在任务线程调用的
  • 所以,CyclicBarrier中的阻塞的是任务的线程,而主线程是不受影响的
  • 简单叙述完这些基本概念后,可以特意抛出这两个类都是基于AQS实现的
  • countDownLatch
    1. 前面提到了CountDownLatch也是基于AQS实现的,它的实现机制很简单
    2. 当我们在构建CountDownLatch对象时,传入的值其实就会赋值给AQS的关键变量state
    3. 执行countDown方法时,其实就是利用CAS将state-1
      执行await方法时,其实就是判断state是否为0,不为0则加入到队列中,将该线程阻塞掉(除了头结点)
    4. 因为头节点会一直自旋等待state为0,当state为0时,头节点把剩余的在队列中阻塞的节点也一并唤醒
  • CycllicBarrier
    1. 从源码不难发现的是,它没有像CountDo wnLatch和ReentrantLock使用AQS的stat e变量,而CyclicBarrier是直接借助ReentrantLock加上Condition等待唤醒的功能进而实现的
    2. 在构建CyclicBarrier时,传入的值会赋值给CyclicBarrier内部维护count变量,也会赋值给parties变量(这是可以复用的关键)
    3. 每次调用await时,会将count-1,操作count值是直接使用ReentrantLock来保证线程安全性
    4. 如果count不为0,则添加则condition队列中
    5. 如果count等于0时,则把节点从condition队列添加至AQS的队列中进行全部唤醒,并且将parties的值重新赋值为count的值(实现复用)

那如果是这样的话,那我多次用CountDownLatch不也可以解决问题吗?

  1. 是这样的,我提出了个场景,它确实很像可以用CountDownLatch和CyclicBarrier解决
  2. 但是,作为面试者的你可以尝试向我获取更多的信息
  3. 我可没说一个任务就用一个线程处理哦
  4. 放一步讲,即便我是想考察CountDownLatch和CyclicBarrier的知识,但是过程也是很重要的。我会看你在这个过程中思考的以及沟通

总结

  1. CountDownlatch基于AQS实现,会将构造CountDownLatch的入参传递至state,countDown()就是在利用CAS将state减- 1,await()实际就是让头节点一直在等待s tate为0时,释放所有等待的线程
  2. 而CyclicBarrier则利用ReentrantLock和Condition,自身维护了count和parties变量。每次调用await将count-1,并将线程加入到condition队列上。等到count为0时,则将condition队列的节点移交至AQS队列,并全部释放。
l